实测 TRAE 宝|开发者的个人助理长什么样?
实测 TRAE 宝|开发者的个人助理长什么样?一个人、一台电脑,与一只 TRAE 宝。
来自主题:
AI产品测评
8489 点击 2026-10-30 10:55

 搜索
一个人、一台电脑,与一只 TRAE 宝。
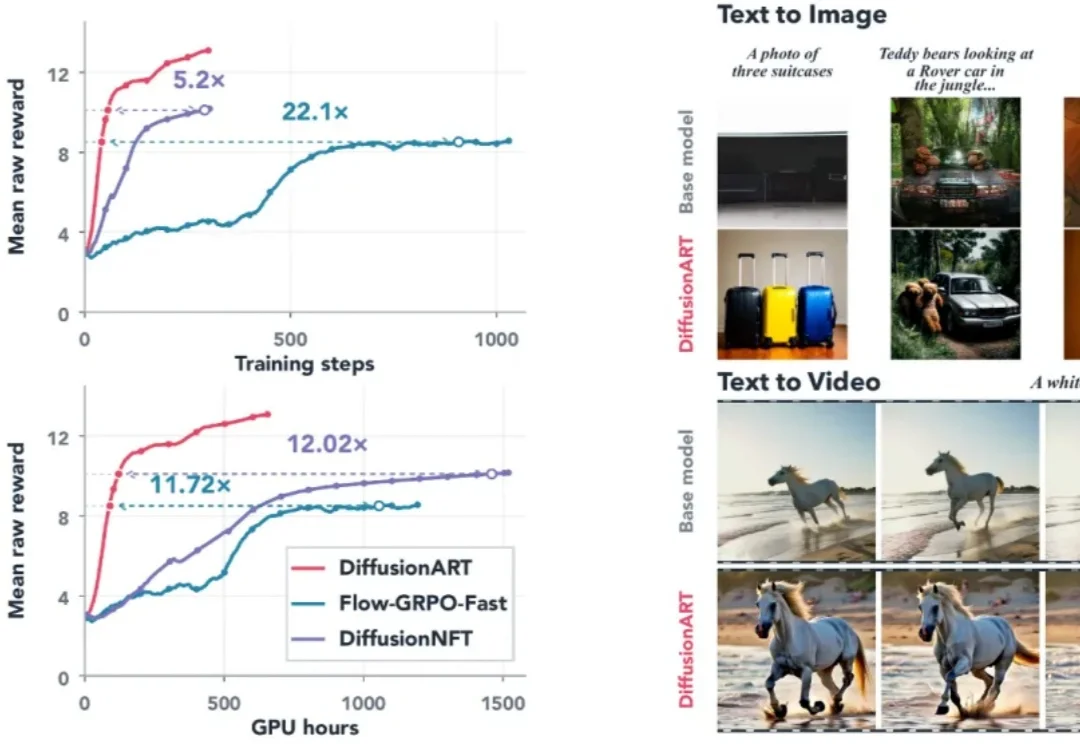
来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。
昨晚刷朋友圈的时候,看到有朋友发了一个WorkBuddy的图。
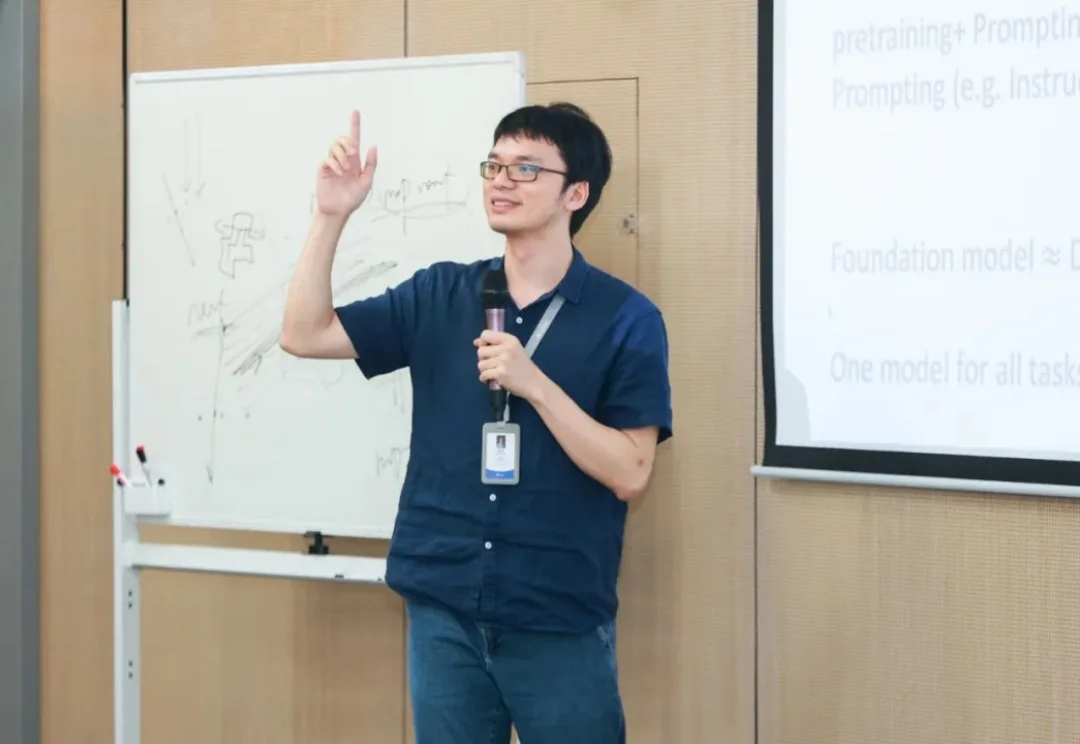
蓝振忠的气质看上去像一名在读研究生,沉静,说话不疾不徐,他是卡耐基梅隆大学博士,计算机视觉出身,曾是谷歌的大模型专家,做出了 ALBERT。两个多小时的访谈里,他三次共享屏幕给我们看论文,讲到自己的技术判断时,语气从来没有犹豫过。
Z Potential独家获悉,柔性织物触觉传感企业矩侨工业近日完成亿元A轮融资,由蚂蚁集团领投,老股东零以创投、威海港融及青岛和信跟投,多维资本担任长期独家财务顾问。本轮资金将主要用于织物电子皮肤规模化量产与交付、触觉及多模态感知技术研发,以及机器人、智能家居和医疗康养等场景的产品拓展。
《持械入宋》,或许将成为AI短剧圈的又一部里程碑式作品。
从 GPT-6 在演示里用 Blender 做三维建模,到 AI 短剧占据越来越多的屏幕时间,再到机器人走进真实场景,看似不同的应用,正指向一组共同的能力要求:理解物体在哪里、彼此如何关联、状态怎样随时间变化,以及采取行动可能带来什么结果。
启元机器人刚刚下线5000台!
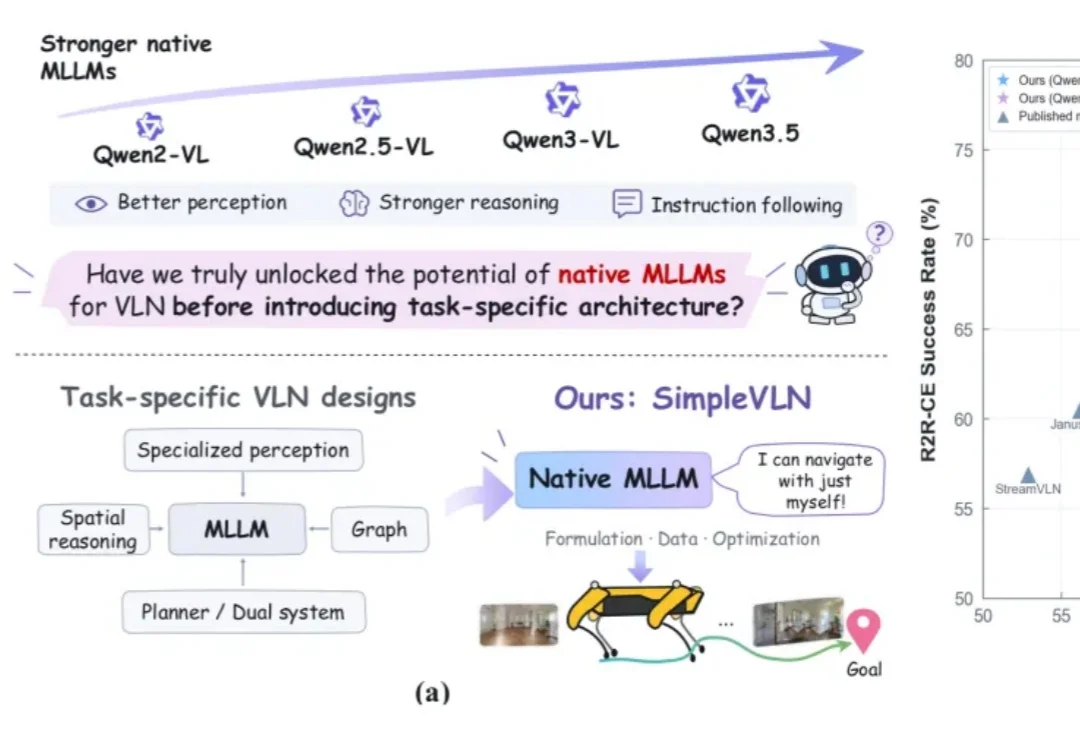
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
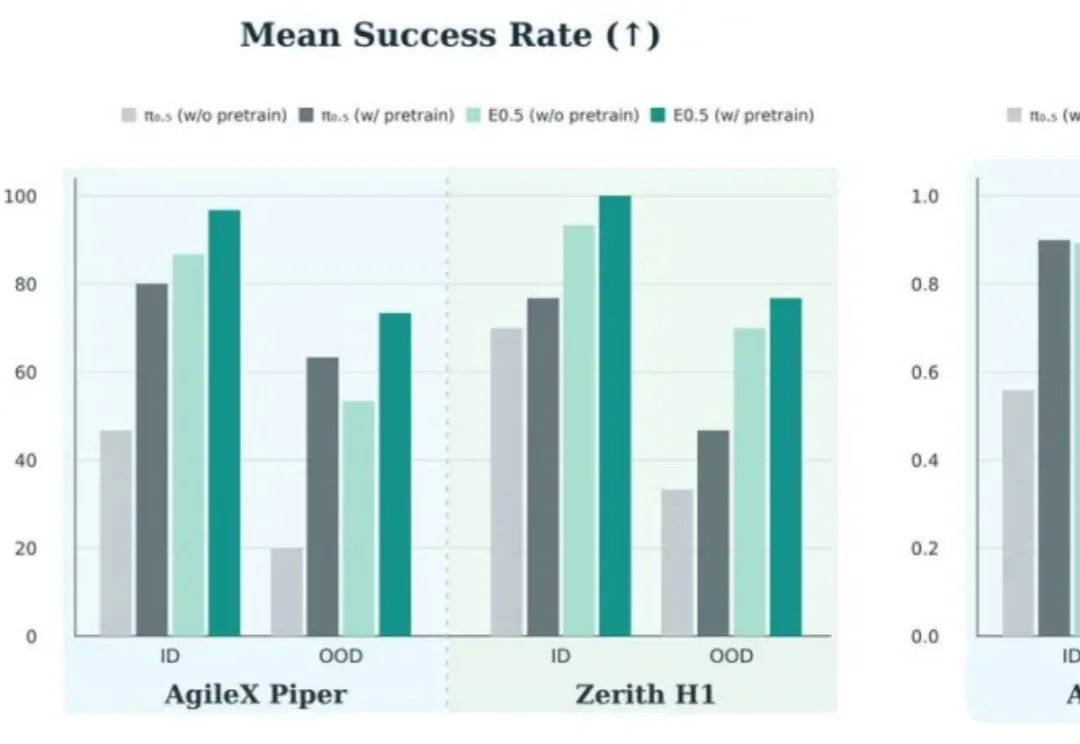
一个充电器,一根缠成一团的线。
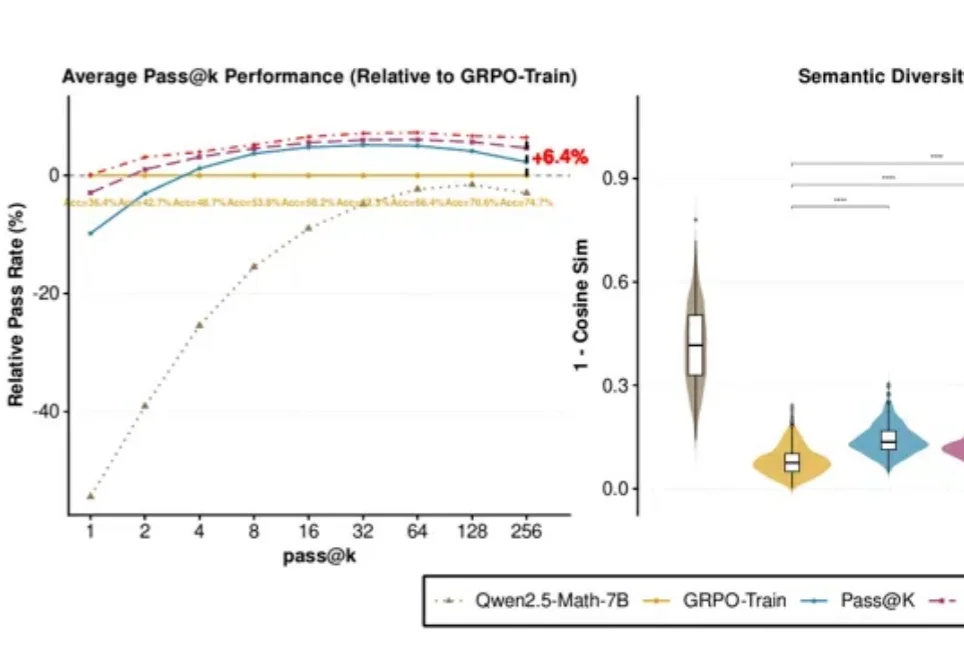
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
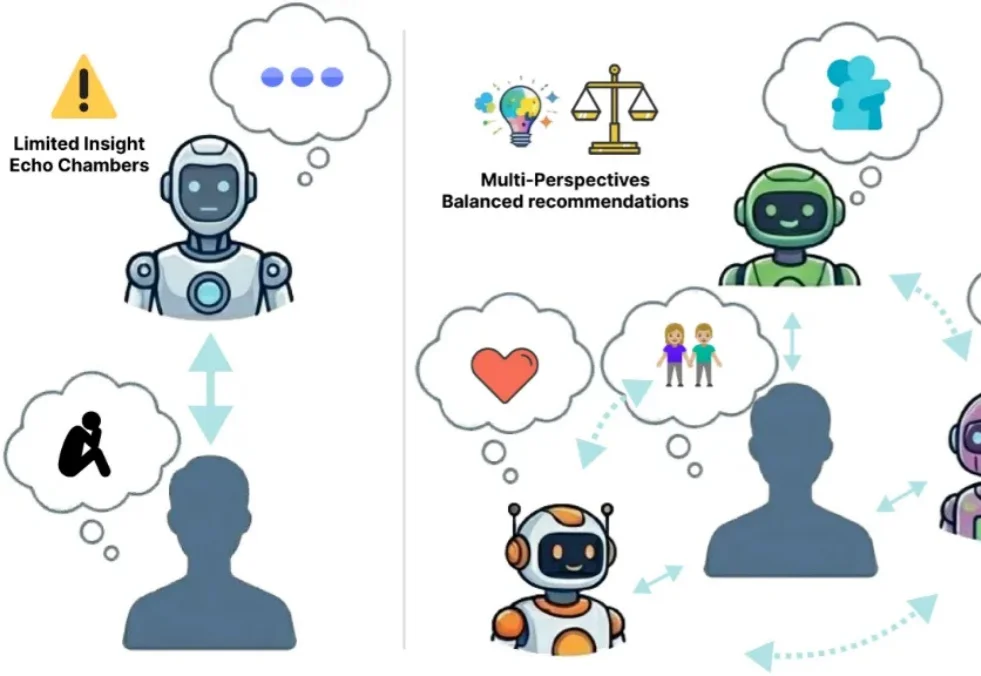
想象一下,你向几个 AI 倾诉最近的压力。
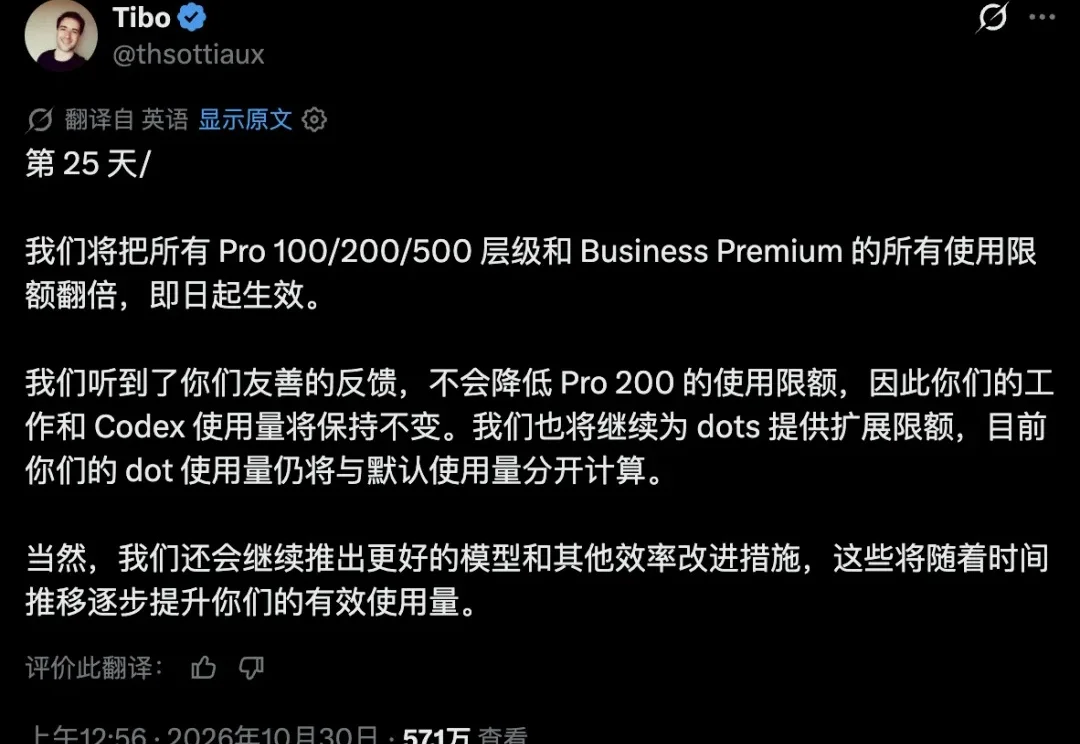
前一天,还有一堆 Codex 用户在喊,最后一天了赶紧蹬,降额之前能薅多少是多少。
OpenAI向已生效至少7天的ChatGPT Pro及符合条件的Business订阅用户提供每计费周期最高500美元免费API额度,Pro按订阅费等额返还、Business按席位共享并封顶,额度到期清零且OpenAI保留调整或取消福利的权利。
AI 的下一次突破将从何而来?业界大佬们一两年前就已给出判断。
让故事世界有更多可能。
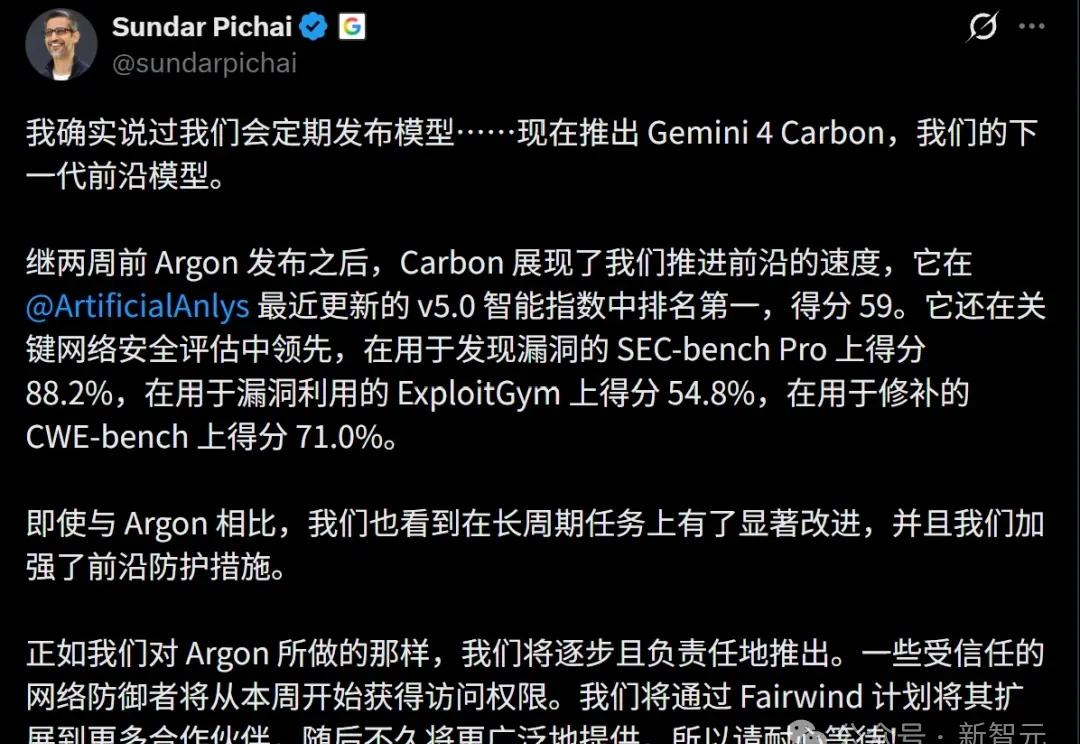
刚刚,谷歌甩出全新前沿王炸模型Gemini 4 Carbon,一口气把全球第一抢了回来!
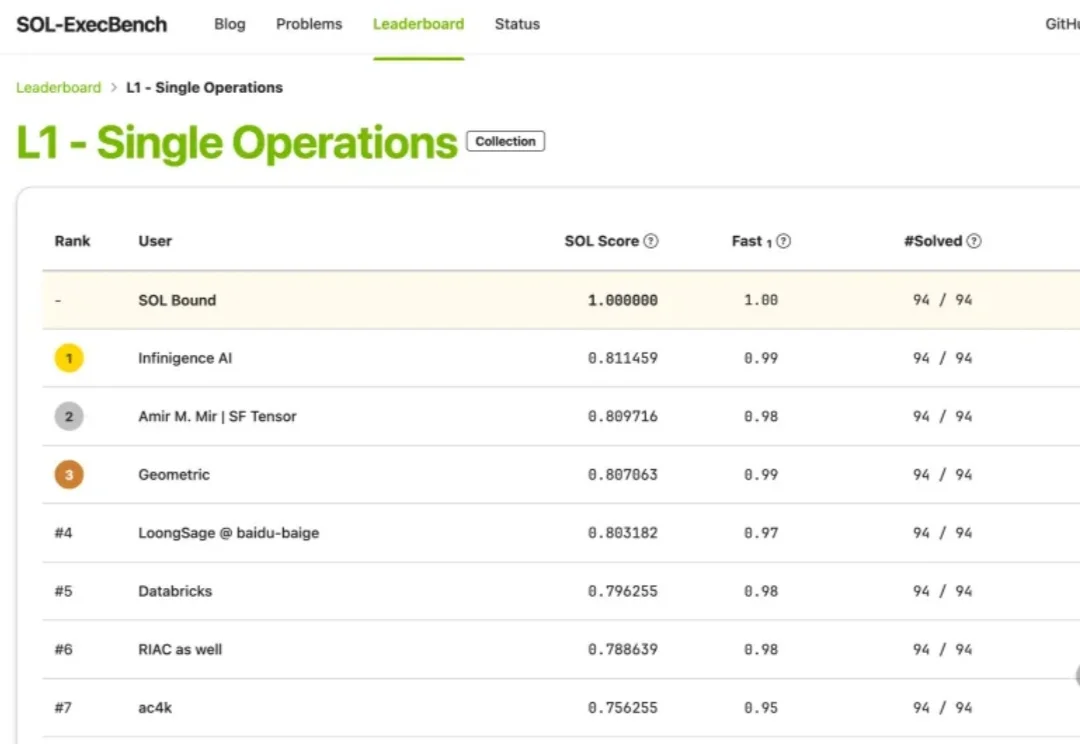
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
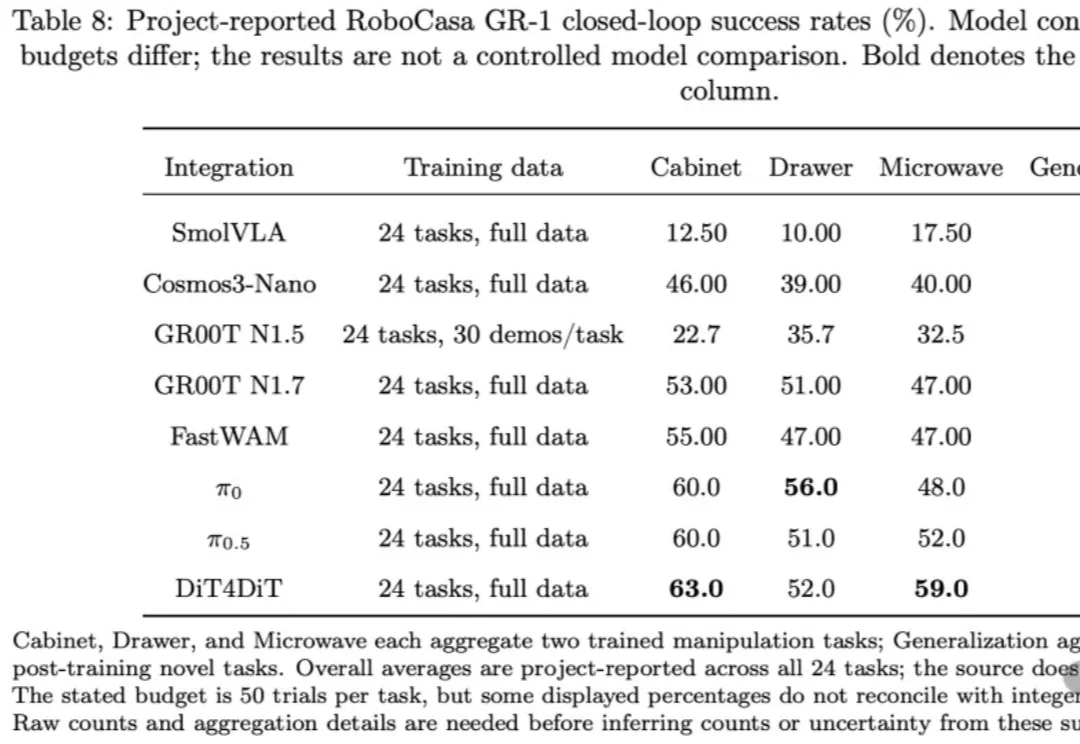
什么时候是具身智能的ChatGPT时刻?
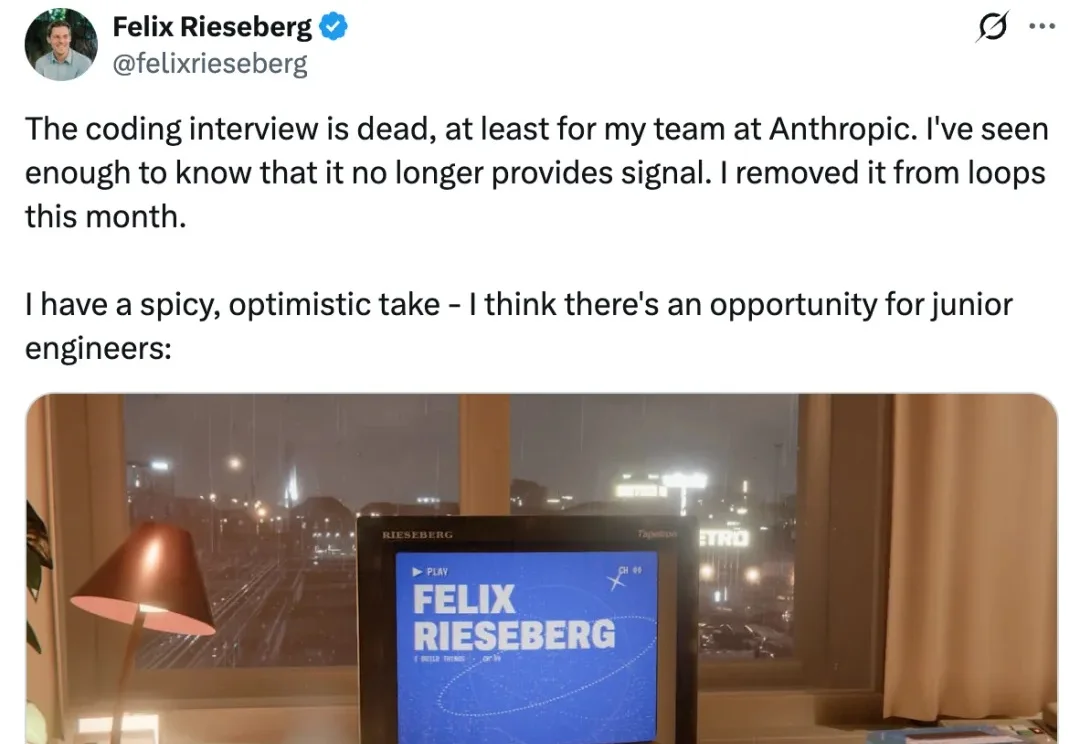
「LeetCode 式的编程面试已死!至少对我的团队来说是这样。」
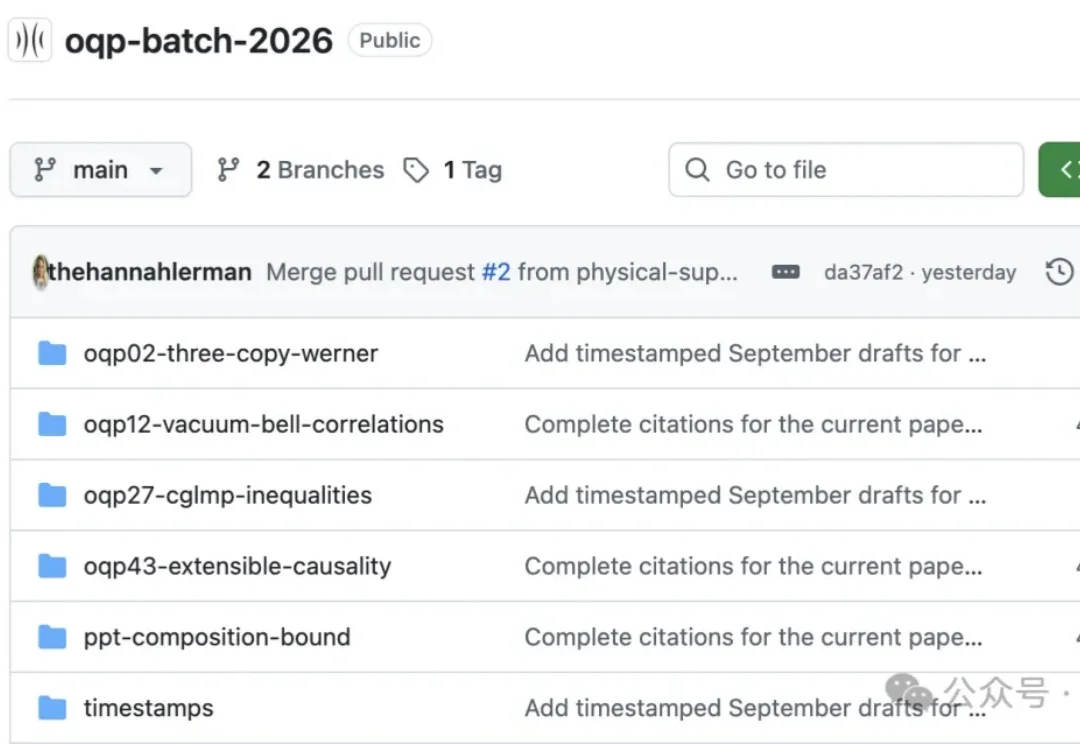
可怕,这才过了几天?
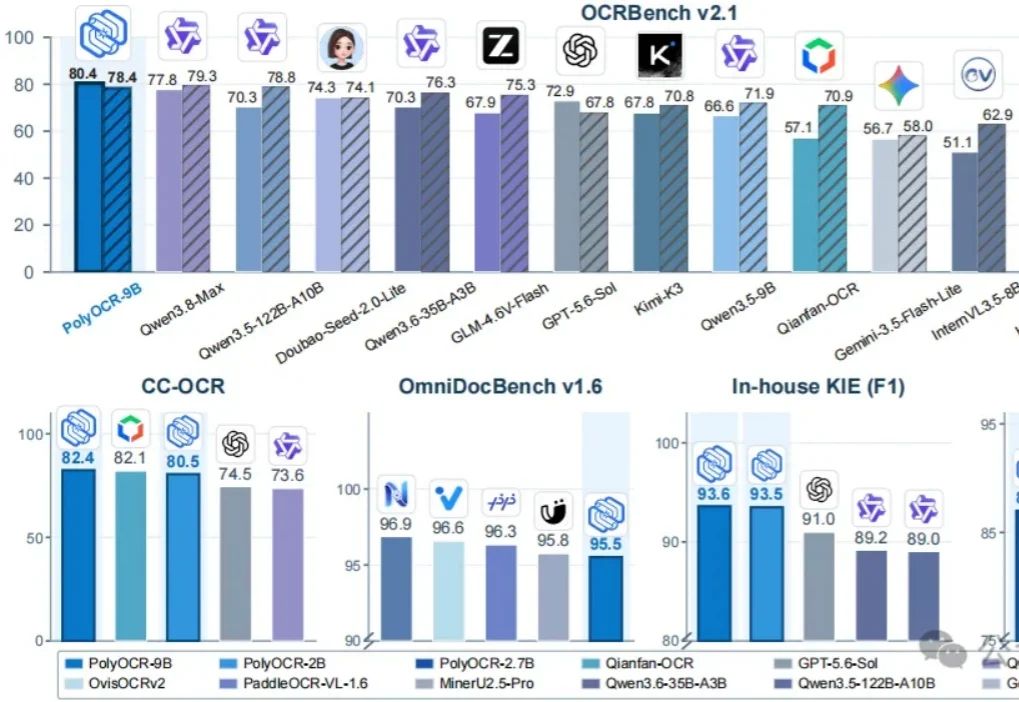
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
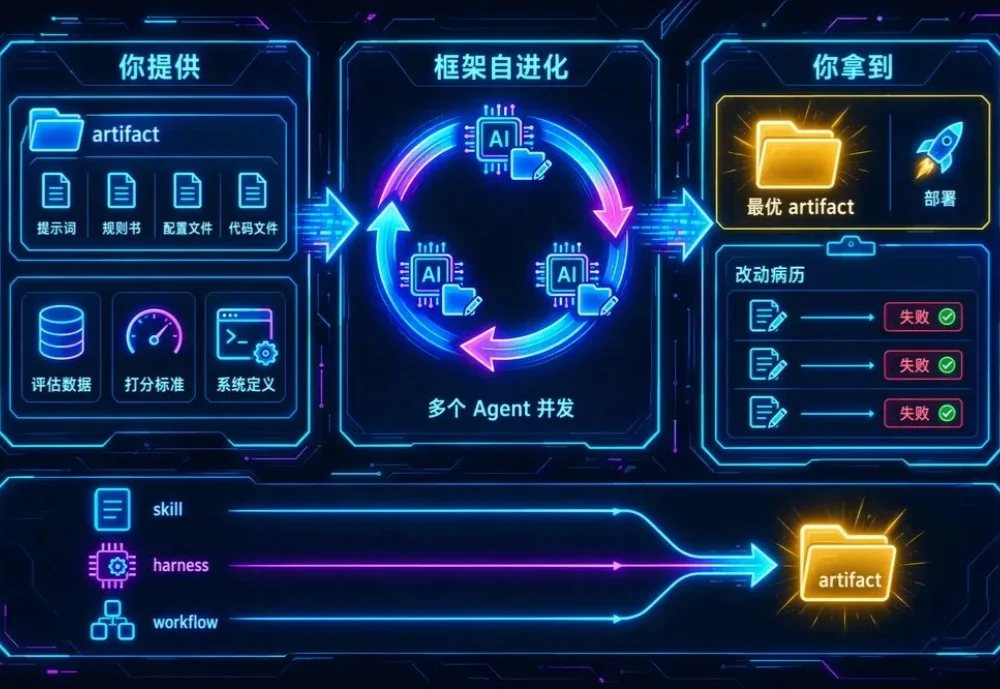
每个做 AI 系统的人都经历过这个阶段:效果上不去,又不知道往哪使劲——读轨迹、改 prompt、调配置,靠人一轮轮试,一试就是好几天。
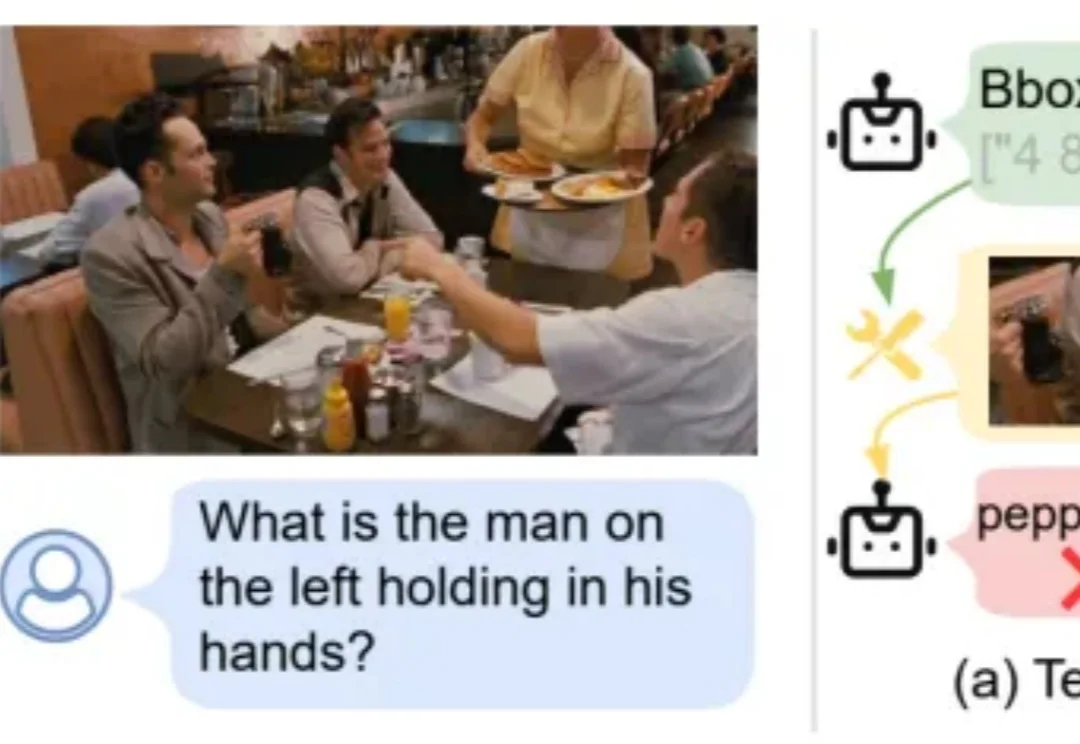
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
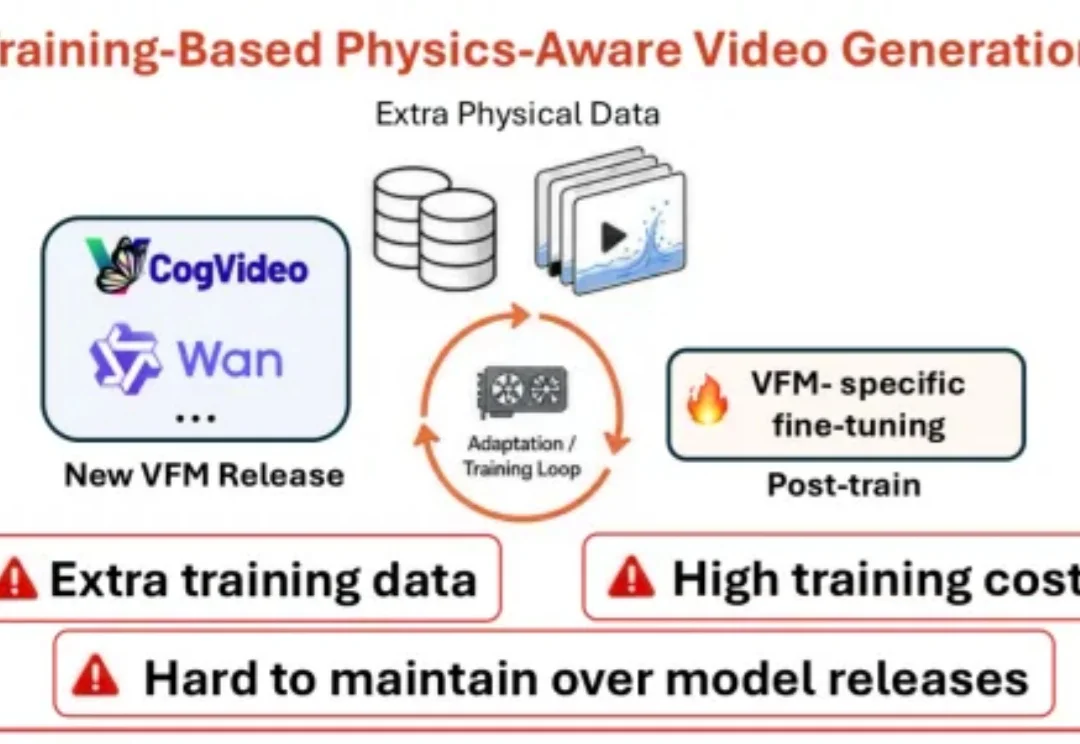
一颗梨在液体中快速旋转,周围的液体应该随之流动、飞溅;一个物体撞向水面,液体也应该产生与碰撞相对应的响应。
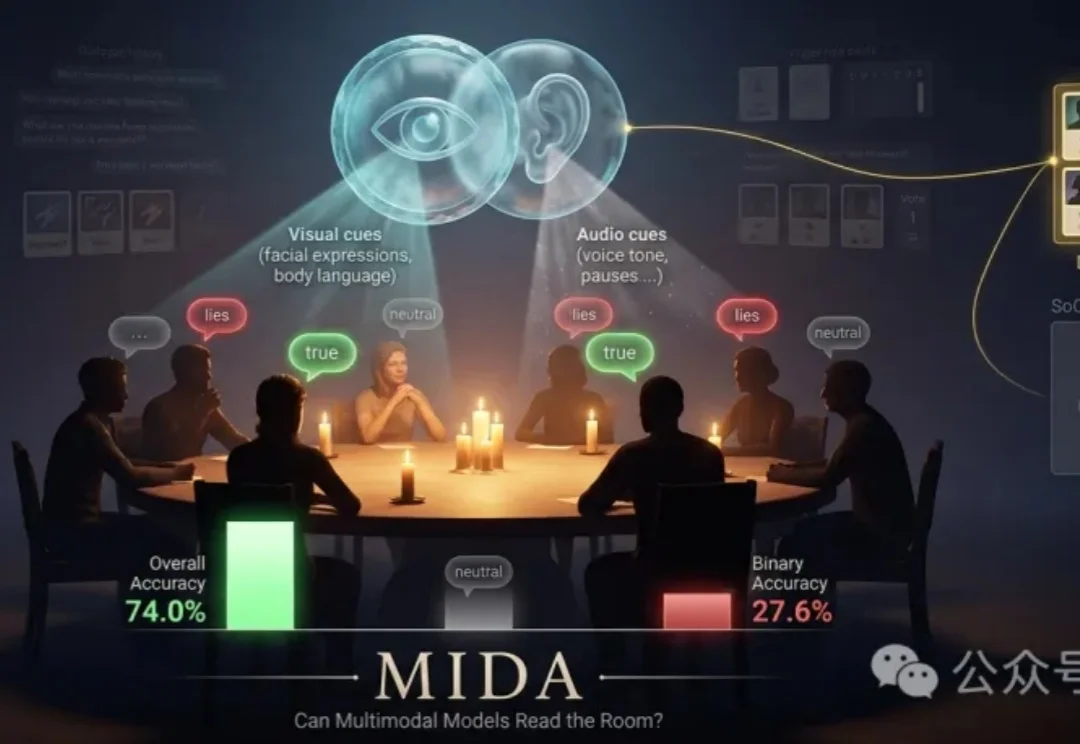
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
一个做软件开发生意的人,开始大规模退订软件,还喊出了一句狠话:软件已死。
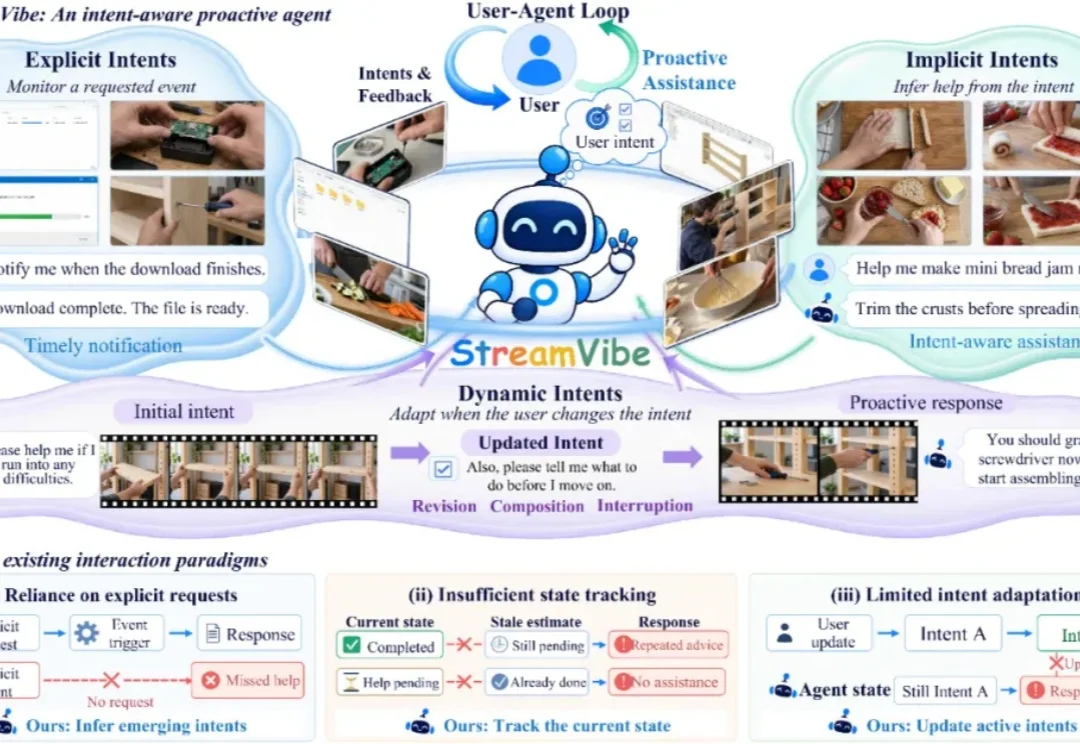
近期,Meta 的 Muse、OpenAI 的 Dot 等产品相继推出,让 Personal Agent(个人智能体)再次成为大模型领域的关注焦点。相比传统的对话助手,这类 Agent 不再局限于回答问题,而是能够结合用户的个人背景、历史记忆与应用上下文,主动执行任务并持续推进长期目标。一个更具主动性、能够长期陪伴用户的 AI 助手,正在逐渐成为现实。
「朋友马上来家里做客,帮我准备一下。」
计算复杂性理论要变天了。