
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
智谱今天上线 GLM-5.3-FlashX,推理速度最高 200 tokens/s,较 GLM-5.3-Flash 模型 提速 5 倍、提价 2.5 倍,API 同步开放,模型名称:GLM-5.3-FlashX
在这背后,是在 10万 张国产芯片提供的推理算力基础上,进一步加大对 Infra 侧的投入与推理优化
跑 Flash 的这套 Infra,是由 GLM-5.3 驱动 Agent 构建的,从模型适配一路做到生产上线,前后不到两周,端到端吞吐做到了初始基线的 3 倍
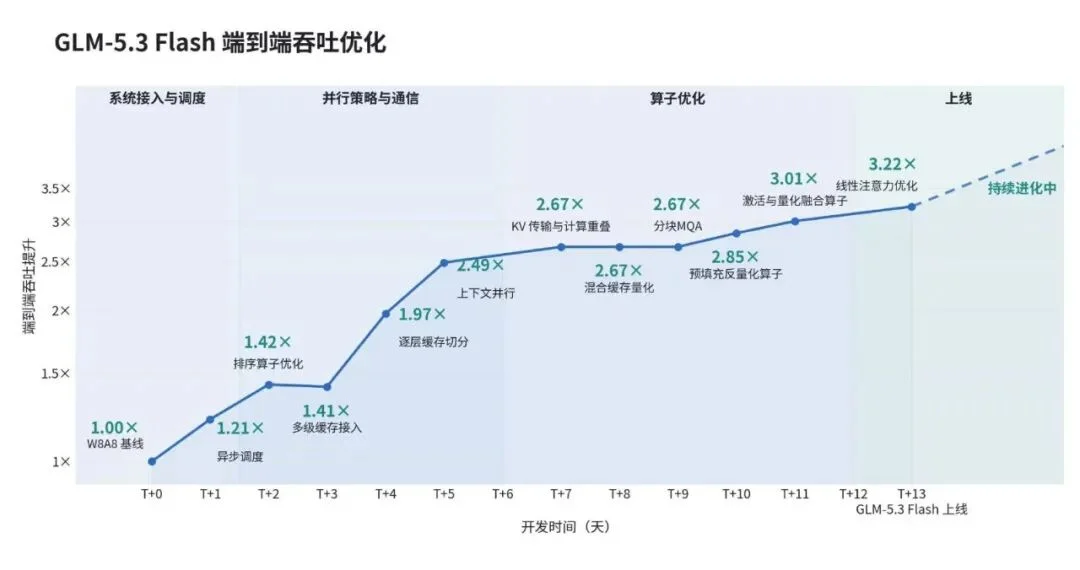
GLM-5.3-Flash 从首次运行到正式上线的性能演进
在构建的过程中,人负责定目标、设边界,搭好反馈环境,以及关键的修改审核 而对于测试、日志、Trace、微基准都接给 Agent,它自己查问题、改代码、跑实验,局部验证通过,再放回完整服务里验收,完成「稠密反馈」
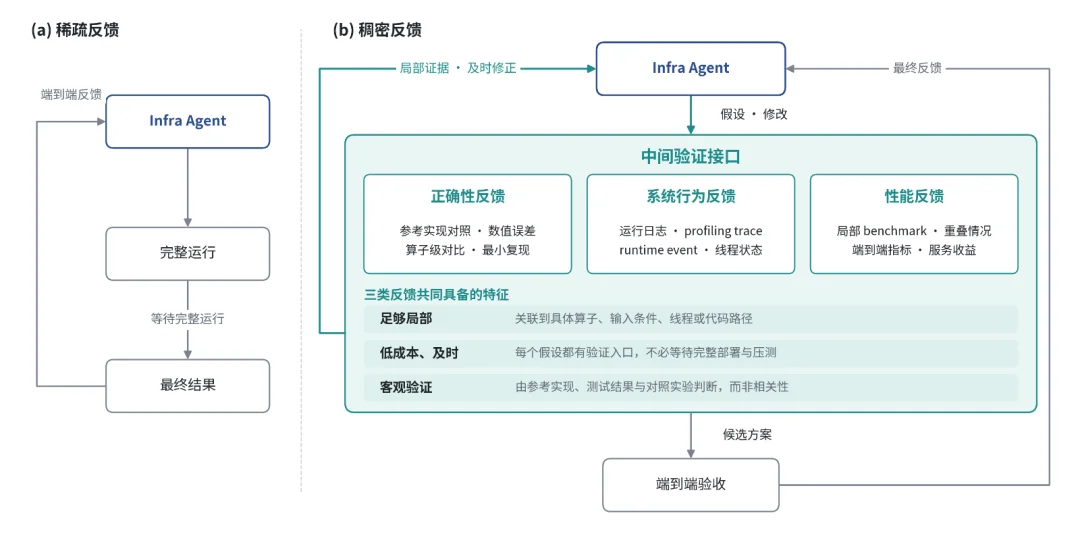
基于稠密反馈的 Infra Agent 优化闭环
下面是构建、优化这套推理系统时的三个案例。
KDA 的 CP 路径出了精度偏差,长上下文下尤其明显。Agent 顺着状态合并、更新的过程查下去,问题落在两处 tl.dot 上:输入是 FP32,计算却默认用了 TF32,误差逐步积了起来。
这两处都显式加上了 input_precision="tf32x3"。修复已合入 Flash Linear Attention 上游。
同样的 workload,Prefill 加上传输后,与单独 Prefill 的性能差距要求不超过 5%,测试却跑出了 20% 以上。Agent 翻看 Trace,发现 KV Transfer 的 Python 侧执行,始终没能和 DeepEP 的 dispatch/combine 调用重叠。
再往下查,DeepEP v1.2.1 的两处 C++ 调用没有释放 GIL,负责 Mooncake Transfer 的 Python 线程拿不到锁,传输任务迟迟交不出去。改完,同样测试条件下,性能差距降到了 1% 以内。
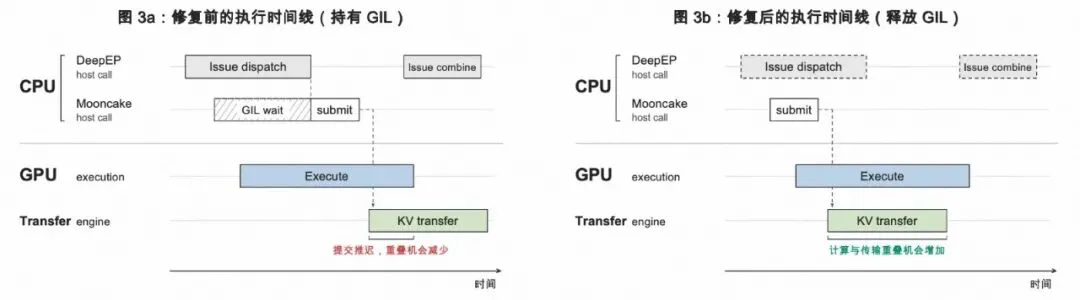
KV Transfer 并发瓶颈的排查与修复
KDA Decode 沿 V 维度分块,同一组 FP32 归一化和门控计算,被不同分块重复做了四遍。
Agent 把这些分块合到同一线程块里,提前批量计算,共享中间结果。并行度少了一些,重复计算也去掉了;这一步,算子性能提高到优化前的 1.71 倍。
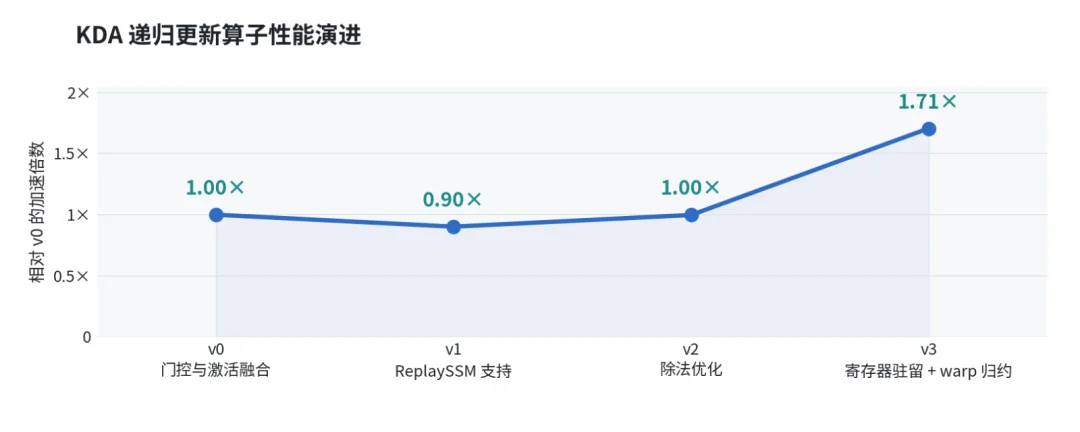
KDA Decode 算子从基础实现到生产版本的性能演进
文章来自于微信公众号 “赛博禅心”,作者 “赛博禅心”


【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
