
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
AI顶会论文,到底有多拼卡?
刚刚,CVPR2026第一次摊开了这笔相当现实的算力账本:
被录取论文,GPU数量中位数为4张;被拒论文,只有2张。
更扎心的是,双方做项目的时间明明都在7个月左右,但中稿组却足足烧掉了2000小时的研发算力,比拒稿组的1200小时整整多出了67%。
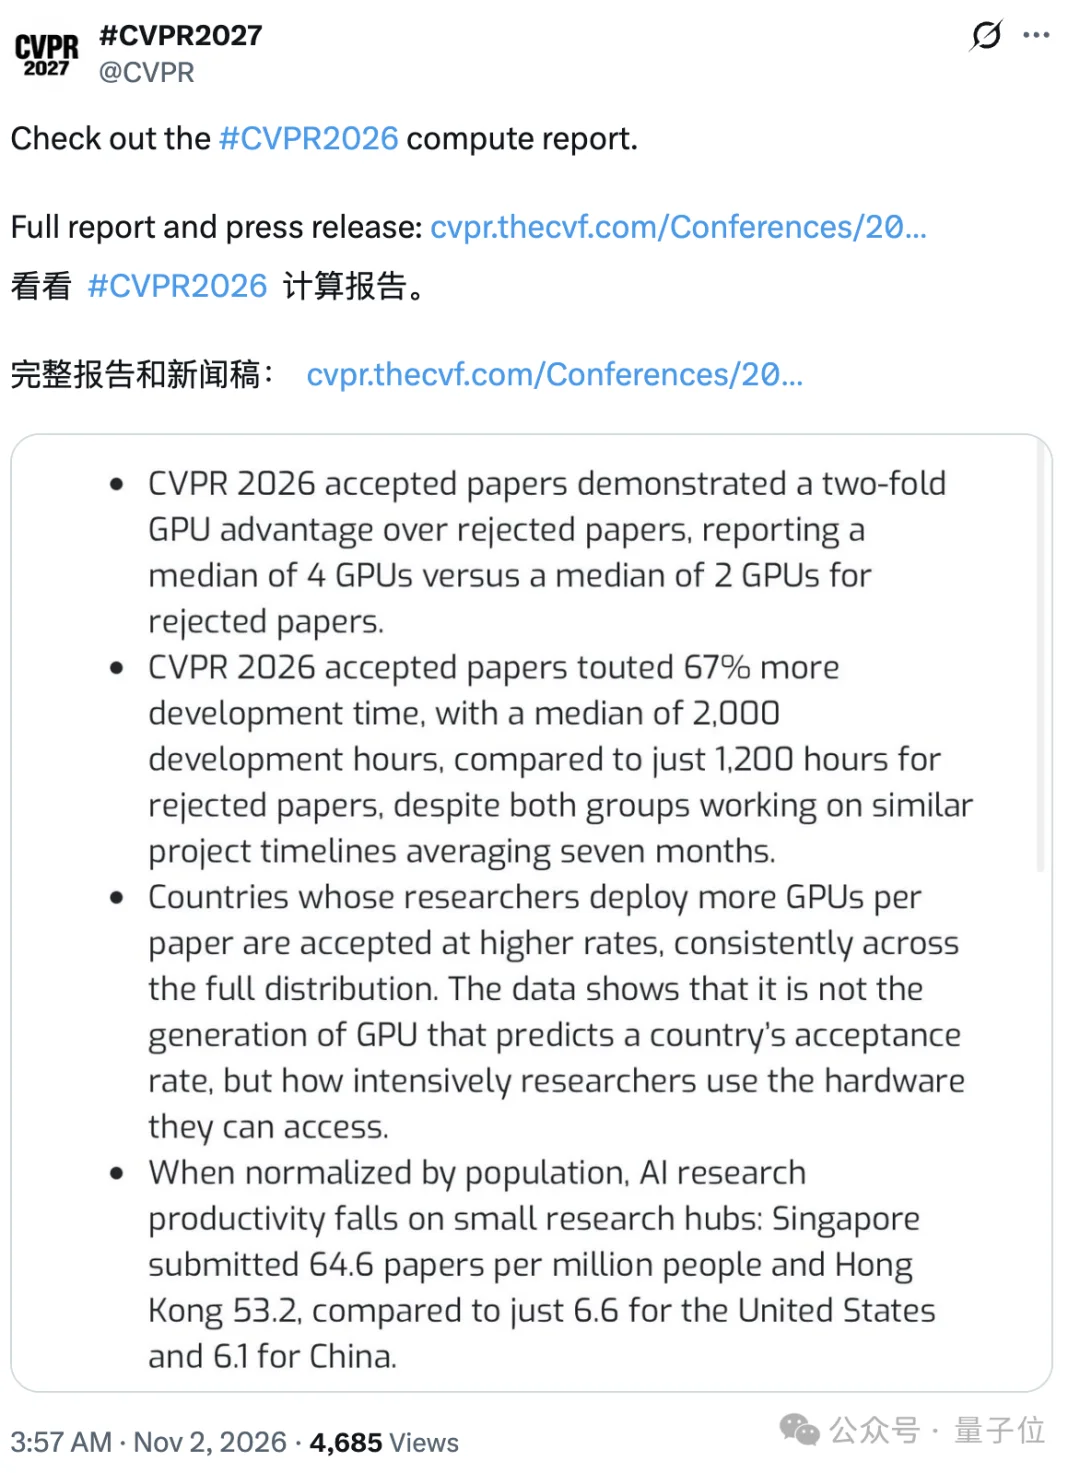 △△CVPR官方发布首份算力报告
这意味着如今想挤进AI顶会,光有好想法还不够,手里能有多少卡、能把实验多跑几轮,也在悄然拉开差距。
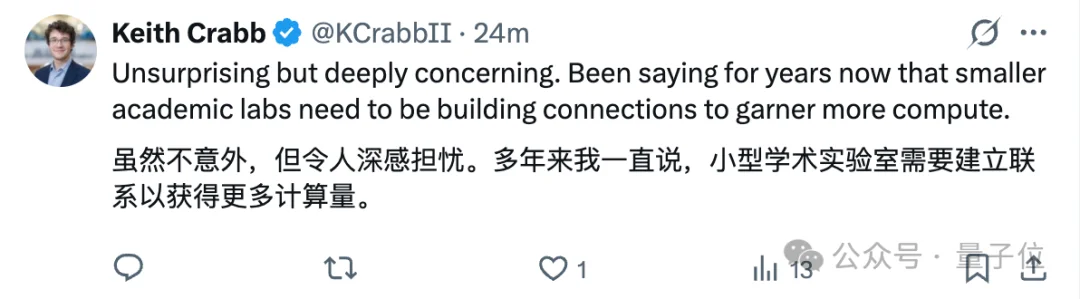
网友Keith看完忍不住感叹:
虽然不意外,但还是很令人担忧。
看来小型学术实验室唯有抱团取暖,才能在算力争夺战中争取一席之地了。
但算力不足,就一定没救了吗?
那倒也不一定~
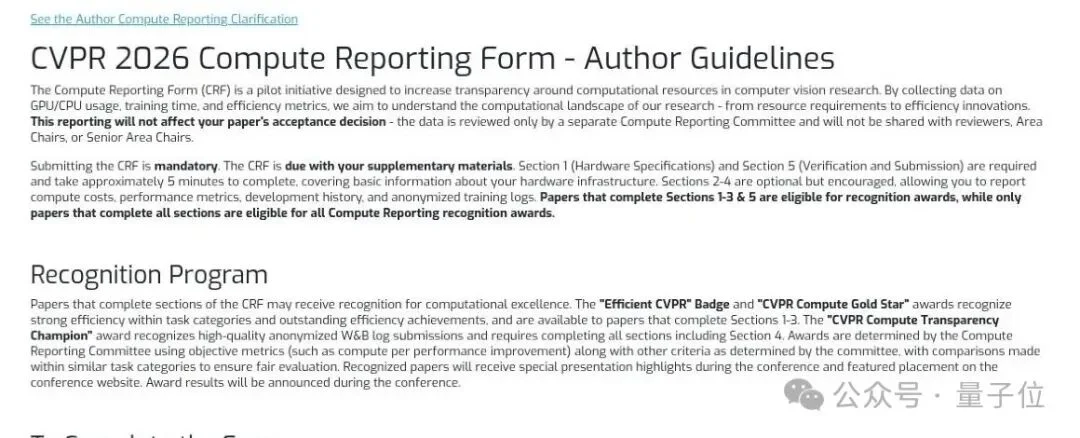
今年,CVPR首次试行算力披露计划。
所有的投稿者都必须先填一张Compute Reporting Form,将用了什么 GPU、几张卡、显存多大,卡是云的、自有的还是借的集群,统统交代清楚。
愿意多写几句的,还能把账算得更细,比如最终模型烧了多少GPU/CPU 时长,期间调过几次参、做过多少轮消融等等。
16034张算力表收上来后,CVPR第一次画出了AI论文背后的“烧卡众生相”。
结果,第一组的差距就直白得刺眼:
被拒论文的GPU数量中位数只有2张,单卡显存则是40GB。
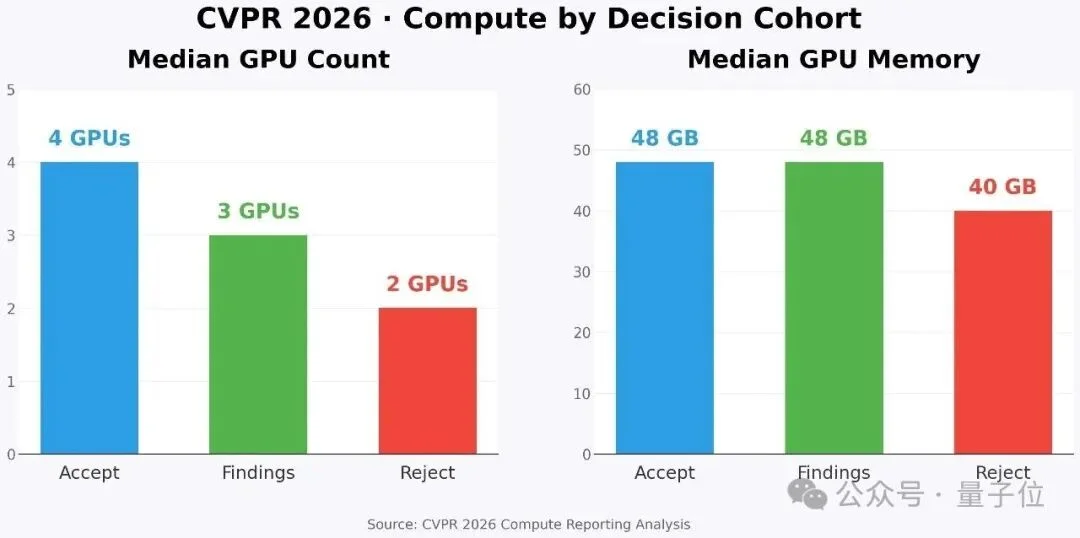 △录取、Findings、拒稿论文的GPU数量与显存对比
与此同时,CVPR还翻出了藏在最终结果背后的计算成本:
偏偏两组的项目周期还差不多——中位数都是7个月。
这也就是说,同样守着一条截稿线,有人只能把路走一遍,有人却已经把几条岔路全踩过了。
方向不行,就火速换;
参数没调对,那就再跑;
基线压不住,那就全部推翻重来;
只要卡还能转,实验就总还有下一轮。
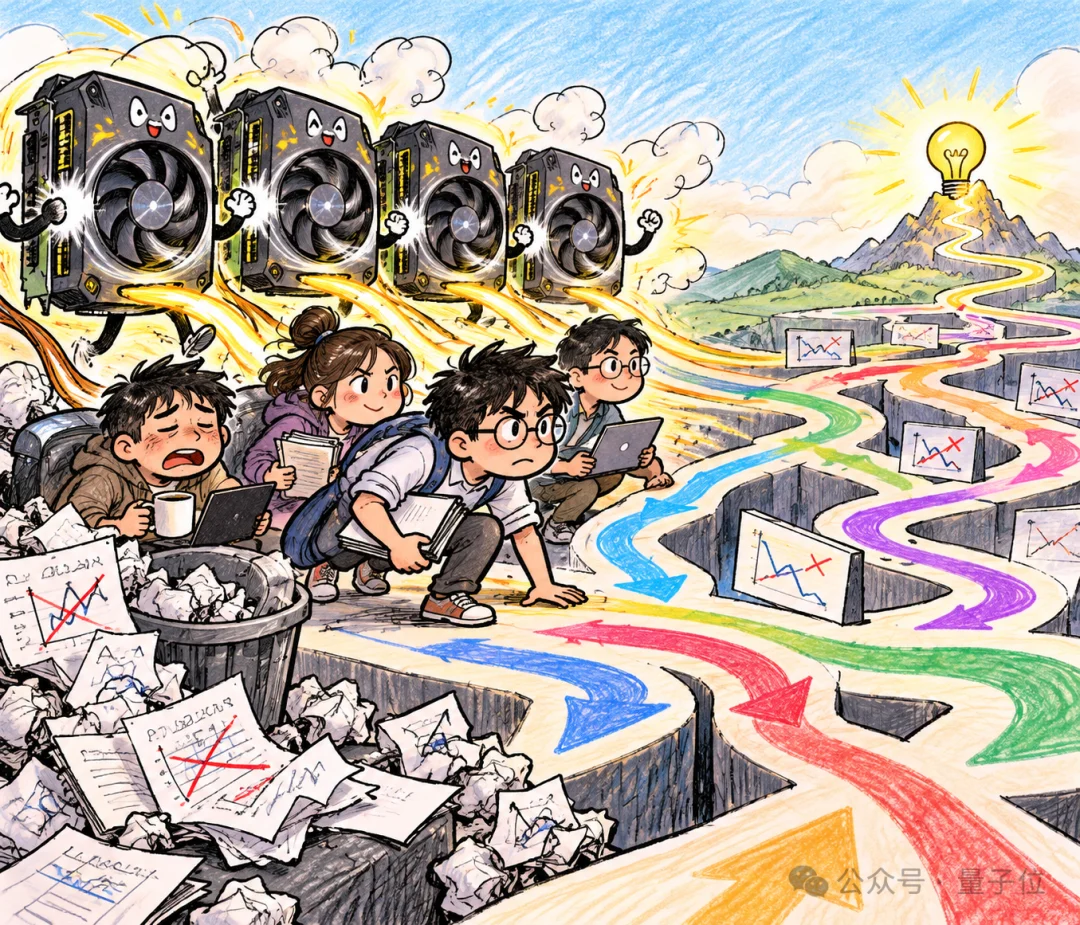 △AI制图
而从国家和地区来看,这种差距也依然存在。
CVPR发现,一个国家的研究者平均每篇论文调用的GPU越多,整体录用率也往往越高;
但比起是否用上了H100、H200这类最新旗舰卡,真正与录用率更紧密相关的,其实是研究者能否持续调动足够多的GPU。
这也就是说,光有一张顶级卡镇场子还完全不够。更重要的是,研究者手里究竟有多少卡可以反复开工,把那些最后没有出现在论文里的失败路线也一个个跑完。当然,这并不意味着CVPR偷偷划下了一条“4张卡录取线”。
他们还提前给作者们打了预防针:
作者交上来的算力表,只会由一个独立的委员会单独处理,审稿人、领域主席和高级领域主席根本看不到,更不会拿来决定论文录不录。
所以,“4张对2张”,只是论文结果出来后才被统计出的相关性,在4张GPU的中位数下面,还有不少用更少算力中稿的研究。
甚至有人只靠一张消费级GPU,就把CVPR的算力大奖抱回了家。
这篇论文叫CaricHarmony,来自英国萨里大学。
它要解决问题也非常有意思:
怎么让AI既能把人脸画得夸张变形,同时又能牢牢守住那张脸最核心的辨识度,让人一看就知道画的是谁?
为了拿捏好中间这个度,一些方法只能选择重新训练模型,或者为每个人单独微调,算力也就这么一轮轮烧了出去。
而CaricHarmony则干脆从信号冲突下手,让身份和形状沿着两条扩散路径分头行动,再由第三条路径将结果合起来。
这样一来,两个信号不用再挤在同一条路上互相干扰,模型也不用重新训练。
最终,CaricHarmony团队只靠着一张消费级RTX 4090,不到16秒,便画出了一张符合要求的漫画。
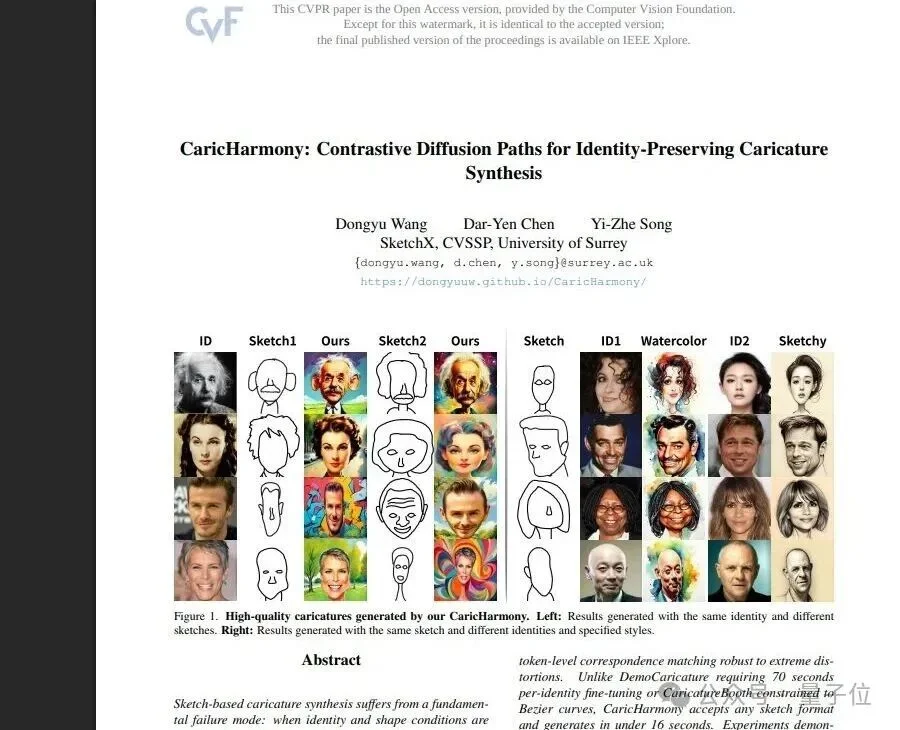 △CaricHarmony论文及部分漫画生成效果
也正是凭借这股设计上的巧劲,CaricHarmony最终从16000多篇投稿中脱颖而出,成为了全球仅有的18篇首届Compute Gold Star获奖论文之一。
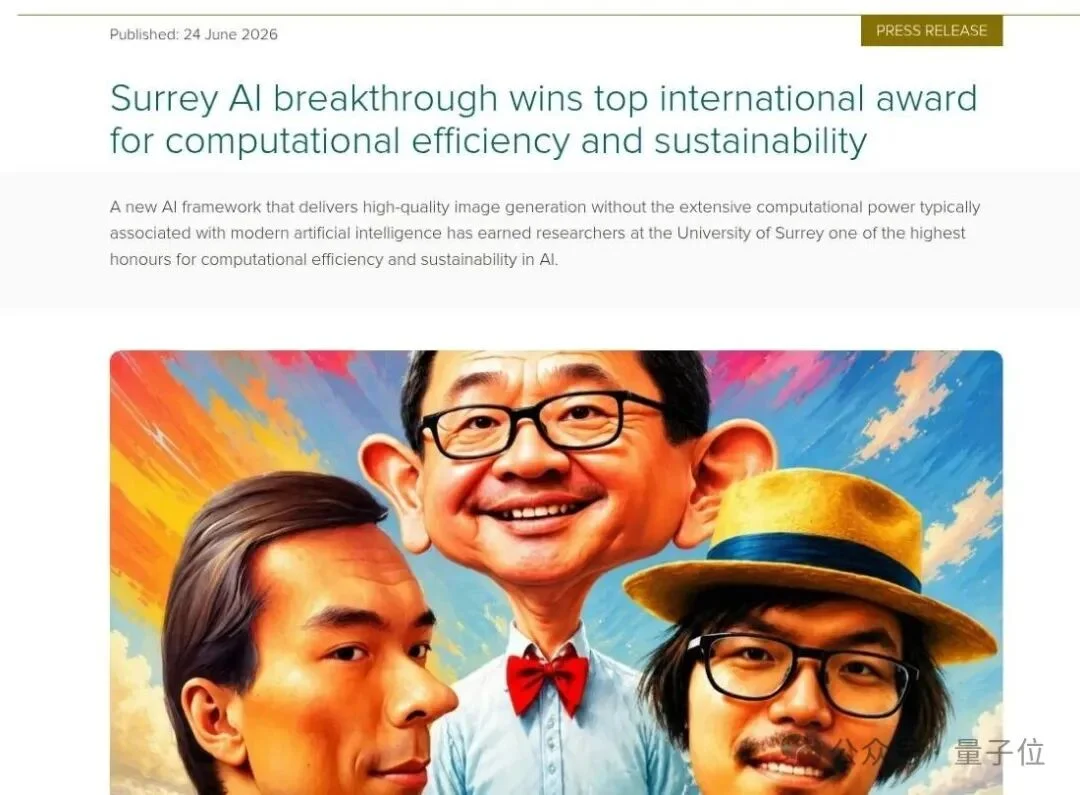 △萨里大学团队获得CVPR首届Compute Gold Star
由此可见,CVPR2026把这笔算力账摊开,也不只是想告诉大家“卡多赢面更大”。
它还专门把那些卡没烧多少,却靠方法创新玩出“四两拨千斤”的省卡高手请上了领奖台。
为此,大会一口气新设了三类奖项:
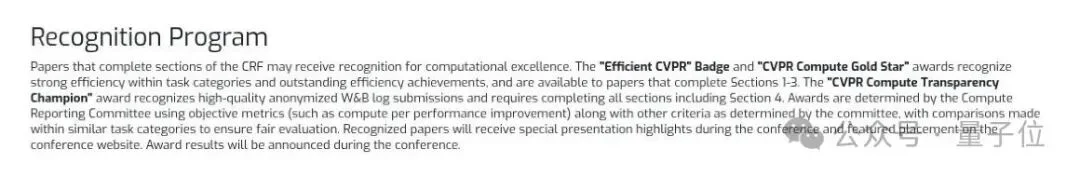 △专门奖励省卡创新
从此,“做出同样的效果,谁能少烧几张卡”这件事本身也成了一项值得被看见的创新。
其实吧,开始追问“这篇论文到底烧了多少卡”的顶会早已不止CVPR一家。
NeurIPS早就把算力塞进了强制论文检查表,作者不仅要交代实验用了什么CPU、GPU、内存和存储空间,还得尽量估出每项实验乃至整个项目一共烧掉了多少算力。
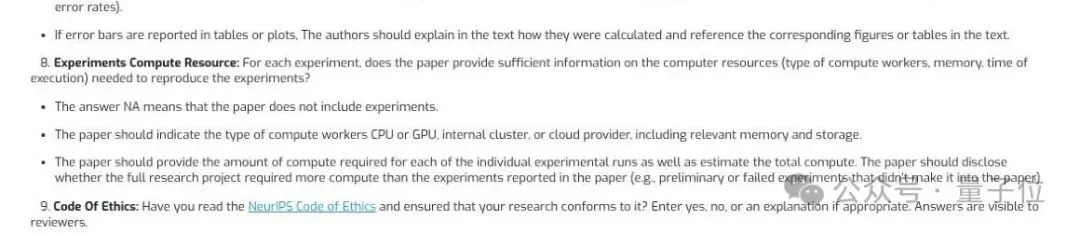 △NeurIPS要求
与此同时,AAAI也同样要求作者提交可复现的性检查表,将GPU、CPU型号、内存和相关软硬件环境交代清楚。
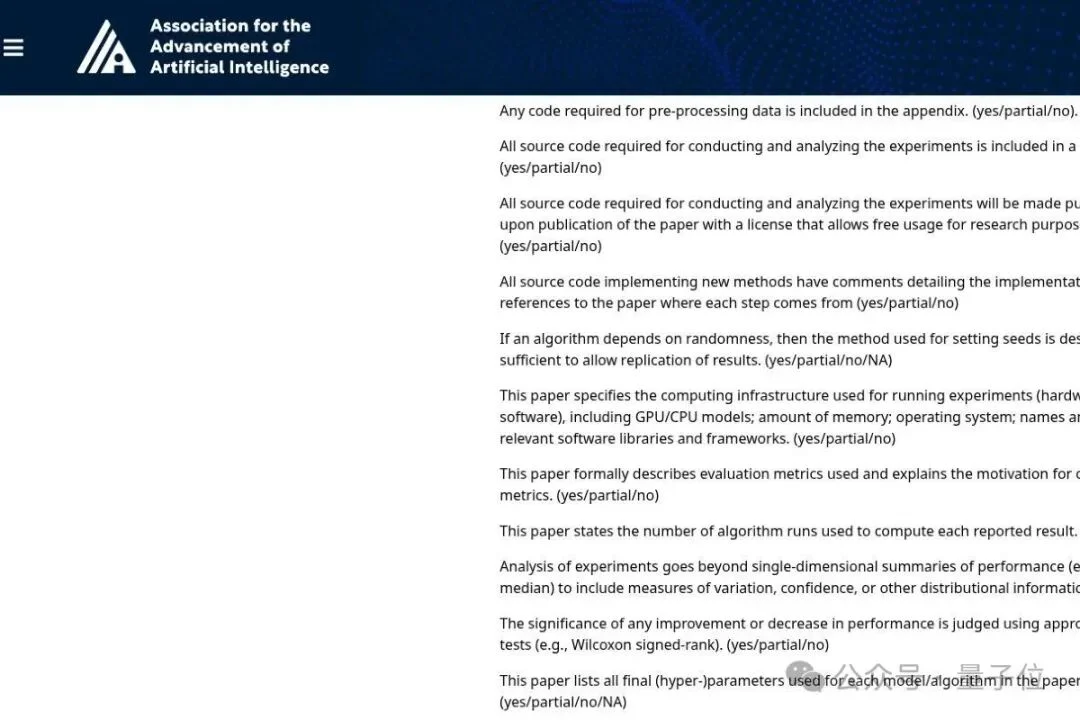 △AAAI要求
现在,CVPR2026这次又把这本算力账往前翻了一页。
它先将算力数据单独收集起来,再把一万多篇投稿放到一起比较,第一次将整个计算机视觉领域的算力差距清清楚楚地摆到了所有人面前。 得出的结论也很现实——
卡多不多、算力够不够跑,确实在悄悄给论文加码。
好在,顶会也没把“卡多”当成唯一答案;
“省卡”本身也开始成为一种值得被嘉奖的创新。
那些手里的卡不多,却能把每一张都用在刀刃上、靠方法创新玩出四两拨千斤的小伙伴们,也开始有了属于自己的领奖台。
参考链接:
[1]https://x.com/CVPR/status/2116983085149360626
[2]https://cvpr.thecvf.com/Conferences/2026/News/ComputeReport
[3]https://computereport.github.io/cvpr2026/
[4]https://openaccess.thecvf.com/content/CVPR2026/papers/Wang_CaricHarmony_Contrastive_Diffusion_Paths_for_Identity-Preserving_Caricature_Synthesis_CVPR_2026_paper.pdf
文章来自于"量子位",作者 "文婷"。

【开源免费】ai-comic-factory是一个利用AI生成漫画的创作工具。该项目通过大语言模型和扩散模型的组合使用,可以让没有任何绘画基础的用户完成属于自己的漫画创作。
项目地址:https://github.com/jbilcke-hf/ai-comic-factory?tab=readme-ov-file
在线使用:https://aicomicfactory.app/
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
