
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
国内AI4S领域头号玩家,又把模型实践往前推了一步……
深度原理 DeepPrinciple 团队,把 GLM-5.3 后训练成了一个科学模型,权重全开放,名字叫 Hydrogen-1.0。
简单跟大家说说背景。
DeepPrinciple 把自家的 GLM-5.3 拿来后训练,灌进化学、材料、生命科学的领域数据,再加上他们自己实验室的实验记录,训练出 Hydrogen-1.0。
权重开放,是说挂在 Hugging Face 和 ModelScope 上随便下,同时也在 NeuroSpark 上开了 API,还能在自家 AI 科学家产品 Mira 里直接用。
如果横向比较一下海外顶尖的AI组织和NeoLab,就能看出深度原理的技术判断,很前瞻。
OpenAI 用 AI agent 证明了强迫 Navier-Stokes 方程的有限时间奇点,还配了 Lean 形式化。
Anthropic 通过基因组分析和实验室验证,找到一个带 CRISPR 样重复序列的酶系统。
最新的共识是,模型已经能参与真实的科学发现,能提出可以被数学或实验验证的想法。
可惜这些模型的发现能力是闭源的,权重不外放,别人想复现、想改造、想接着往下做,都得看人家的脸色。
Hydrogen-1.0 干的事情,是把这条刚刚被证明能走通的路,用开源权重重新铺了一遍。
见过很多打着开源旗号的模型,开源的是名头;权重、数据、评测口径全都藏着掖着。
这次Hydrogen-1.0的发布就很有诚意了。
它把从领域知识到实验记录,再到发现轨迹的整条链路,都摊开了,连失败实验的记录都拿来当训练数据。
失败记录,是科研里最难拿、也最值钱的数据,愿意拿它出来训练的团队,至少说明他们真的相信这条路。
先看评测数据。
Hydrogen-1.0 在 FrontierScience-Research 上超过 GPT-6-Astra,在 GPQA-Diamonds 上比它的起点 GLM-5.3 高,基本追平开源前沿模型 Kimi-K3。
让我在意的,是发布页里那张性能对成本的图,横轴是输出侧 API 价格。
把能力和单位成本放在一起比,能看出水准,也能看出性价比。
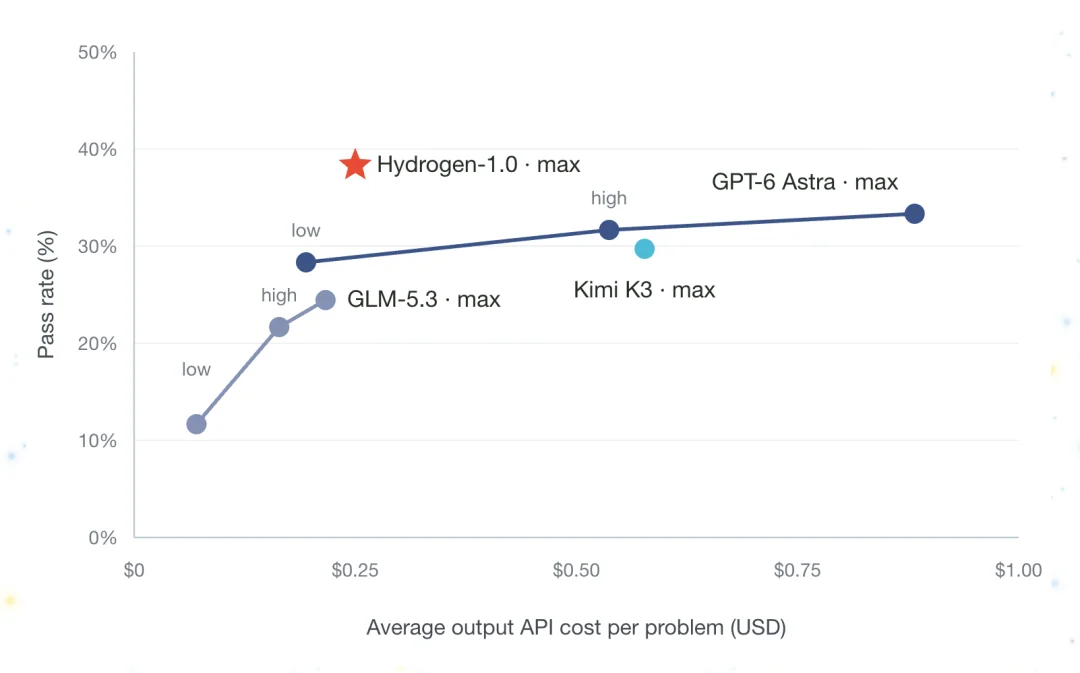
这种产品化算账的思维,有些研究团队意识不强,也造成了产业侧的落地难。
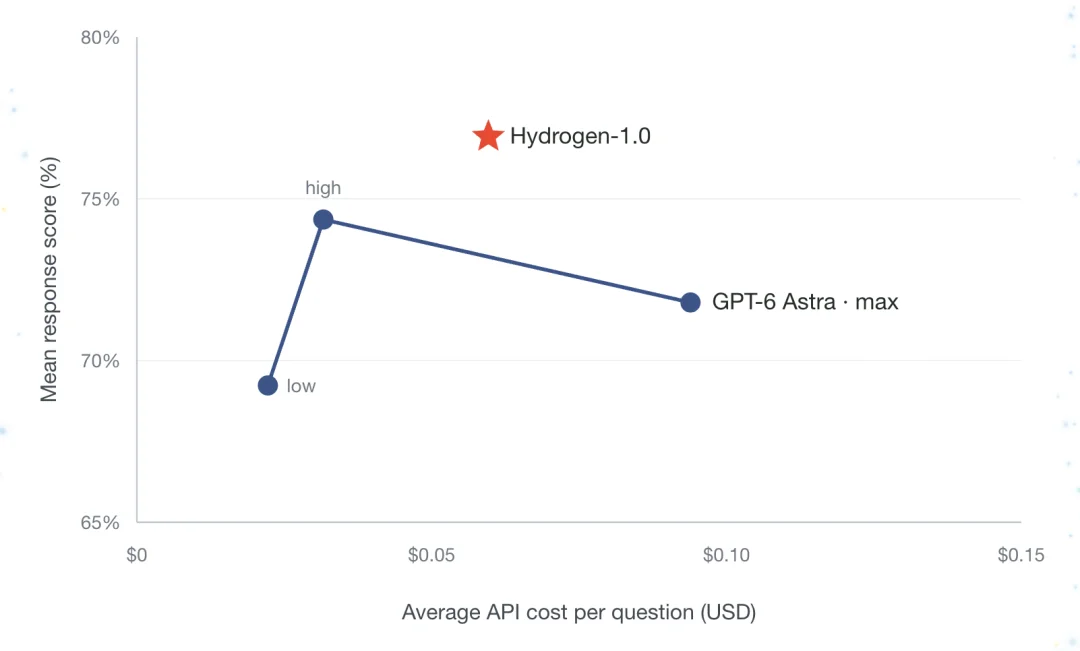
内部场景的评测,更有意思。
科学计算、单步正向反应预测、NMR 结构解析,三个他们团队天天用的场景,最高思考档下前两项比 GPT-6-Astra 高 5.13 和 4.76 个百分点,NMR 那项低 3.33。
发布页专门写了一句,不同任务的绝对分数差异反映的是内部题目难度,不能直接当成模型能力的横向比较。
能主动给自家数字画边界、承认某一块不如别人的,是认真做研究的人。
榜单数字撑不起一个新范式,让我觉得这个模型有点东西的,是那几个演示案例。
先说聚合物分子动力学。
给模型一个材料学问题,它自己写 Python 搭聚乙烯熔体,跑 GROMACS,跑到一半发现拓扑结构有错,自己检测、自己修、修完重启模拟。
最后给你一条 40 纳秒的轨迹,还能接着分析密度、分子堆积、扩散和链尺寸。
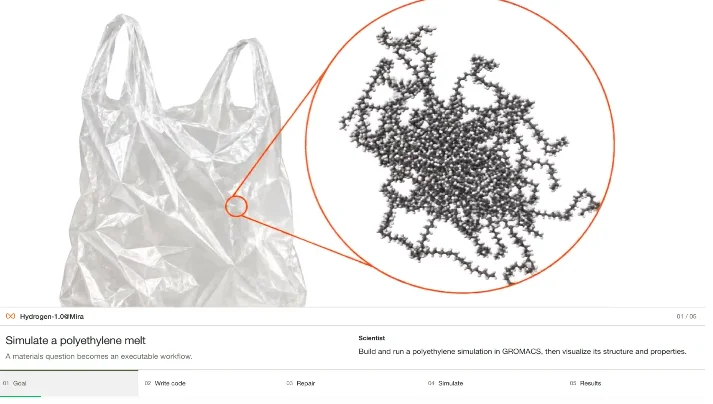
对于今天的模型,写代码不难,难的是程序跑起来出了错,能看懂报错、定位到拓扑定义的问题、再自己改掉。
这一步卡死了市面上绝大多数 coding 模型。
因为这背后不是背题,是在一条真实工具链里做调试,每一步都需要对底层物理和软件行为有理解。
另一个案例更有味道。
一个 Ireland-Claisen 重排反应网络,27 个分子结构、30 条反应记录,主路线每一步的电子势垒都比备选路线低。
模型把整个网络铺开,帮你找潜在瓶颈、比较竞争路线。这不是单步预测,是几十步的推理链,每一步都连着真实的化学数据。
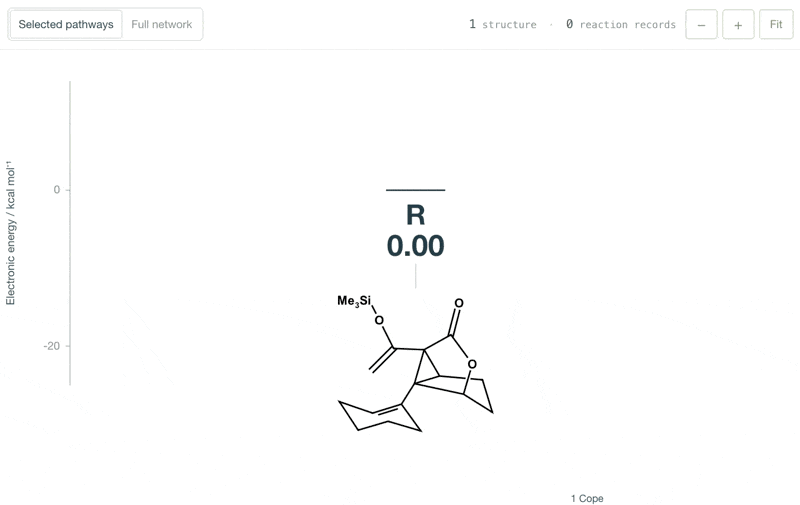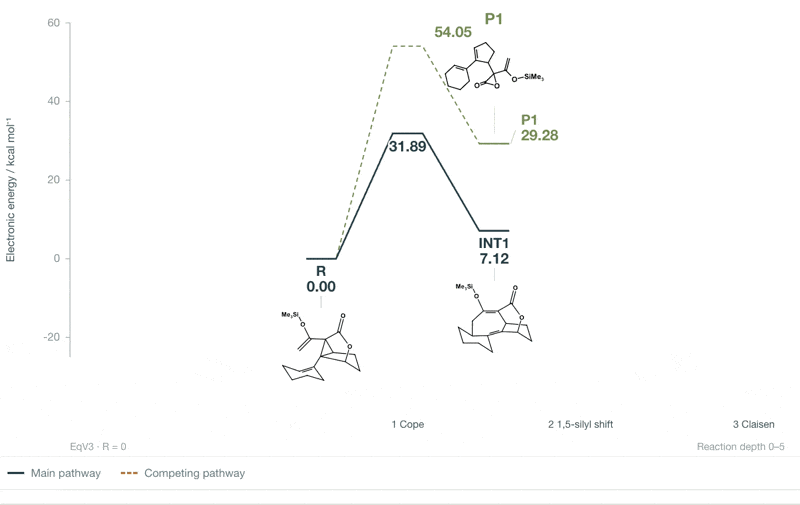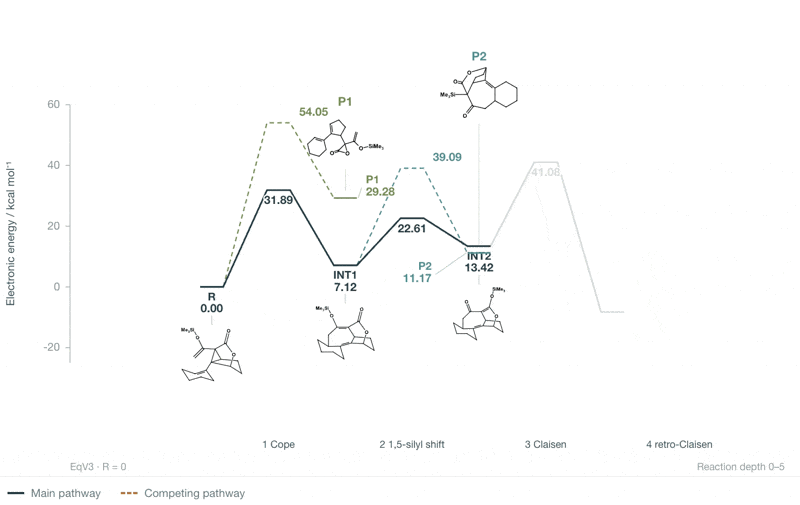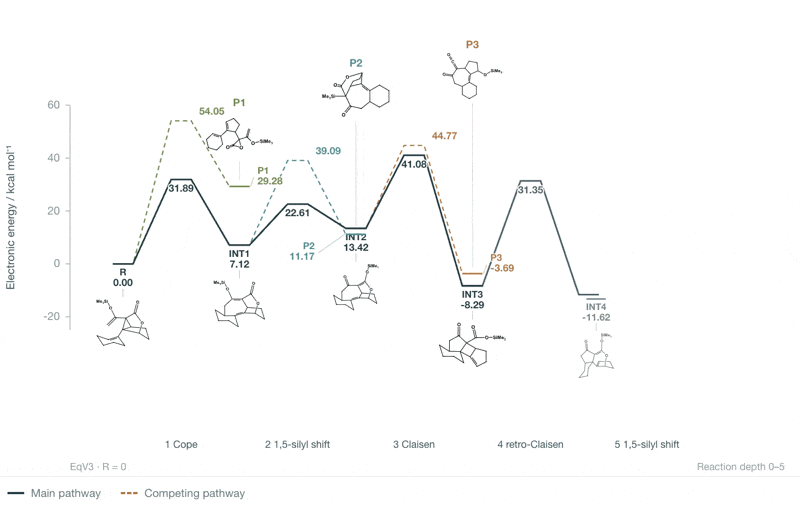
还有 NMR 结构解析。模型拿到一张氢谱,从 2-溴萘的 7 个可能单甲酰化产物出发,先看低场信号,再看拥挤的芳香区,逐个评估候选结构。
做过的人都知道,NMR 解析是研究生要练很久的功夫,要把谱图特征和结构化学对应起来。
最打动我的,是实验室编译这个设计。
一个 12 管 Suzuki 偶联实验,模型写出 JSON 协议,虚拟预演时抓住一个低级错误,吸液的时候没换新枪头。
这在真实实验室里意味着交叉污染,做过湿实验的人看到这里都会会心一笑,这是每个进实验室的人都踩过的坑。
模型自己把动作顺序改对,编译通过,才进入实际执行。
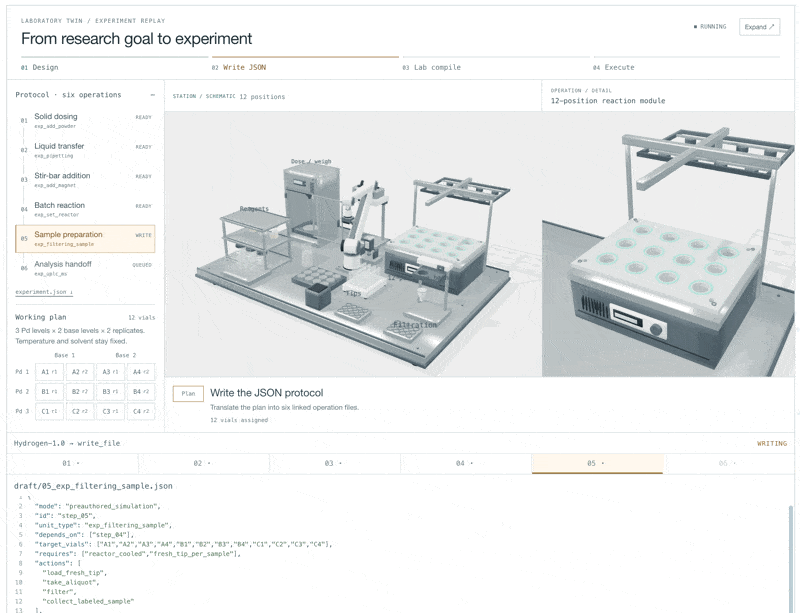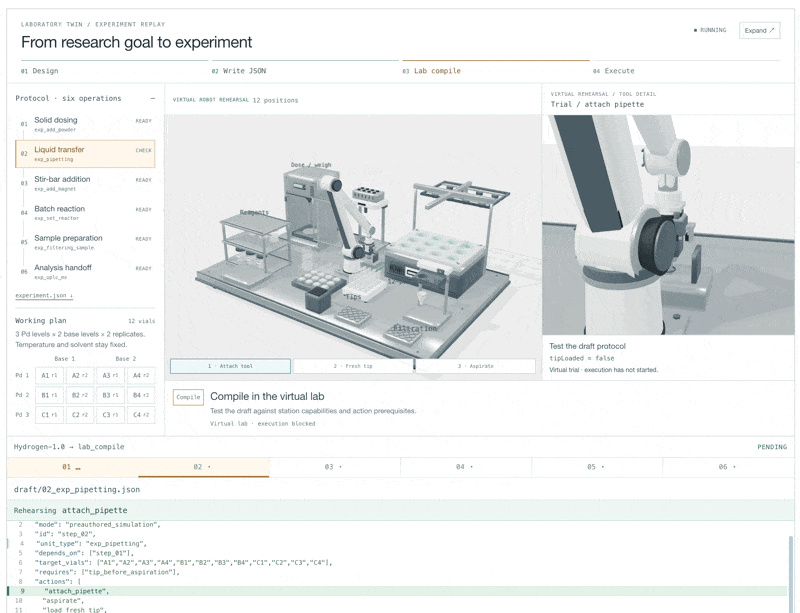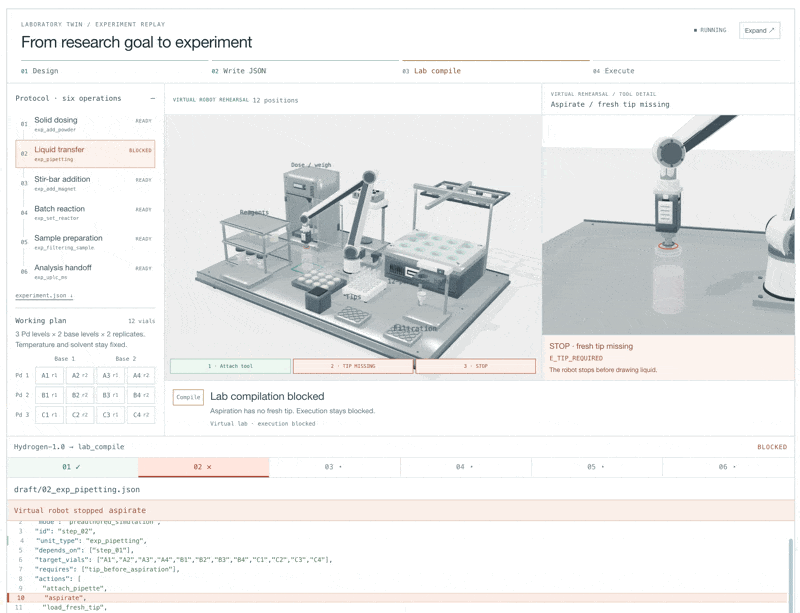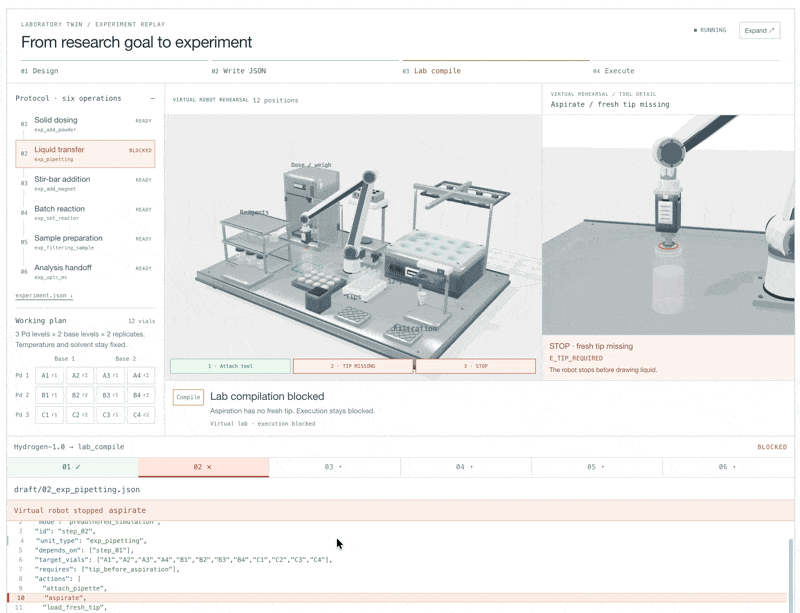
能在执行前拦住这种错误,说明它对实验流程的理解已经进入动作层面。发布页里那句话说得实在,执行前把错误拦住,能缓解 AI 自主性带来的安全问题。这个思路,比多考几分重要得多。
榜单和演示看完了,重头戏在训练。
Hydrogen-1.0 的管线是 SFT 加 RL。
SFT 提供推理、实验规划、协议设计、结果分析的工作示例,RL 让模型根据研究结果的反馈学会做更好的决策。
训练数据分四块,领域知识、科学家的任务级反馈、实验室记录、完整的发现轨迹。
这里我想多说两句。多数科学模型的训练数据是论文和教科书,干干净净的正确答案。
但是 Hydrogen-1.0 的数据里混着大量实验室记录,包括失败的尝试和修正过的假设。
看着反直觉,脏数据怎么训出好模型?
很快我想明白了:科学发现的真实过程本来就是这个样子,假设、实验、失败、修正、再试。
只喂干净答案,模型学到的是教科书里包装好的科学;喂全过程,模型学到的才是真实发生的科学。
他们专门讲了自己的电子实验记录本,配合 Mira 的智能体文档化,把实验从头到尾的上下文都留全,想研究什么、怎么做、发生了什么、下一步查什么。
从这种记录里学到的,是实验完整展开的过程,不是孤零零的最终结果。这是大多数只拿论文训练的科学模型给不了的。
训练工程上几个细节,越看越觉得有分量。
全模型 MoE 后训练,优化器用 Muon,FP32 主权重和动量在 CUDA 上放 CPU,只把当前要更新的主矩阵搬上 GPU,更新完写回;
在 ROCm 上更狠,把动量直接卸载到磁盘,前向反向计算时给长序列激活腾显存。
长序列用离线打包,不截断完整推理示例,损失只算在 assistant 输出上,按全局监督 token 数归一化。
动态稀疏注意力在多卡之间做因果约束,保证每个样本只看自己的因果前缀。
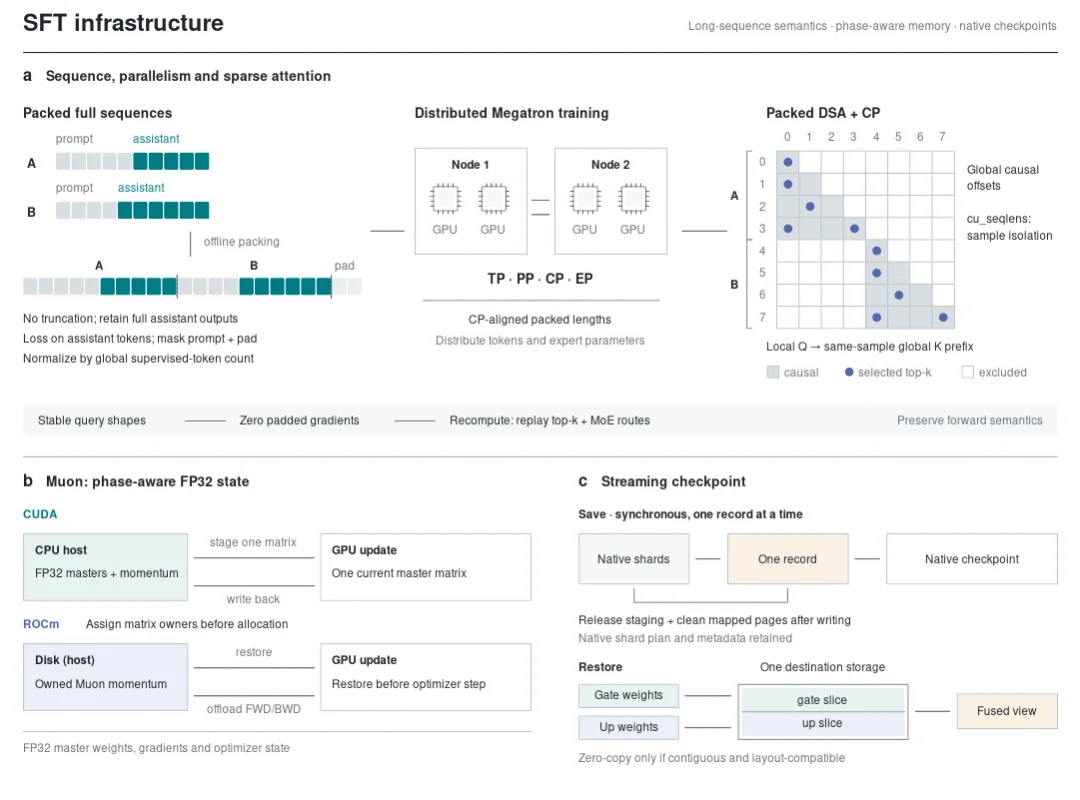
SFT 基础设施示意,长序列打包、稀疏注意力与优化器状态的调度方式
还有个特别有意思的设计,可恢复的强化学习 rollout。
GPU 池在生成和训练之间切换,没跑完的响应保留前缀,下一轮接着续写。
一个响应可能横跨多个策略版本,每个 token 都记录自己生成那一刻的真实行为 log-prob,重要性修正按 token 对齐。
这就解决了一个老大难问题,长序列生成慢,整个 rollout 周期都会卡住,现在没跑完的活可以跨轮接着干。
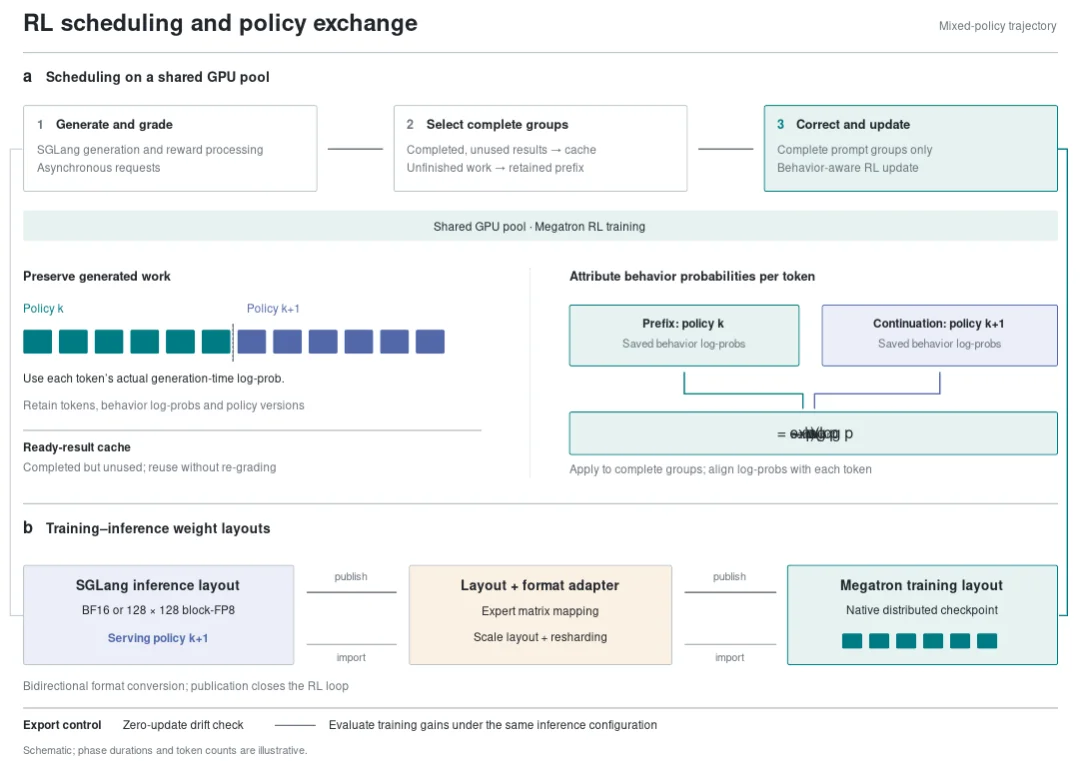
图2:可恢复强化学习与训练推理权重交换示意(来源:Deep Principle 发布页)
还有一个小地方,也挺见功力。
训练和推理用的权重布局、精度格式都不一样,训练是 BF16,推理是 128 乘 128 分块的 FP8,中间用一个双向适配器衔接。
他们甚至在归因训练收益之前,先做零梯度更新的导出和量化漂移检查,再用同一套推理配置去评估训练效果。
做评测的人看到这段会心一笑,太多团队训练归训练、上线归上线,两套配置各跑各的,最后数字打架还找不到原因。这种自证,是工程上最值钱的东西。
单个细节拿出来都是工程优化,串在一起,能看出这是做长期主义的事。
为了把长序列和 RL 跑起来,连优化器状态放哪里、磁盘和显存怎么交换都重新设计了一遍。
从这种基建投入,也能看出来深度原理他们,认定科学模型这条路值得走下去。
最后聊点更长期的。
有一个「寻找新材料」的实验,很有意思,我特意留到最后。
过渡金属配合物设计任务里,每个模型从相同的初始种群出发,五轮迭代,每轮推荐一个新配合物,只接收自己推荐的结果作为反馈。
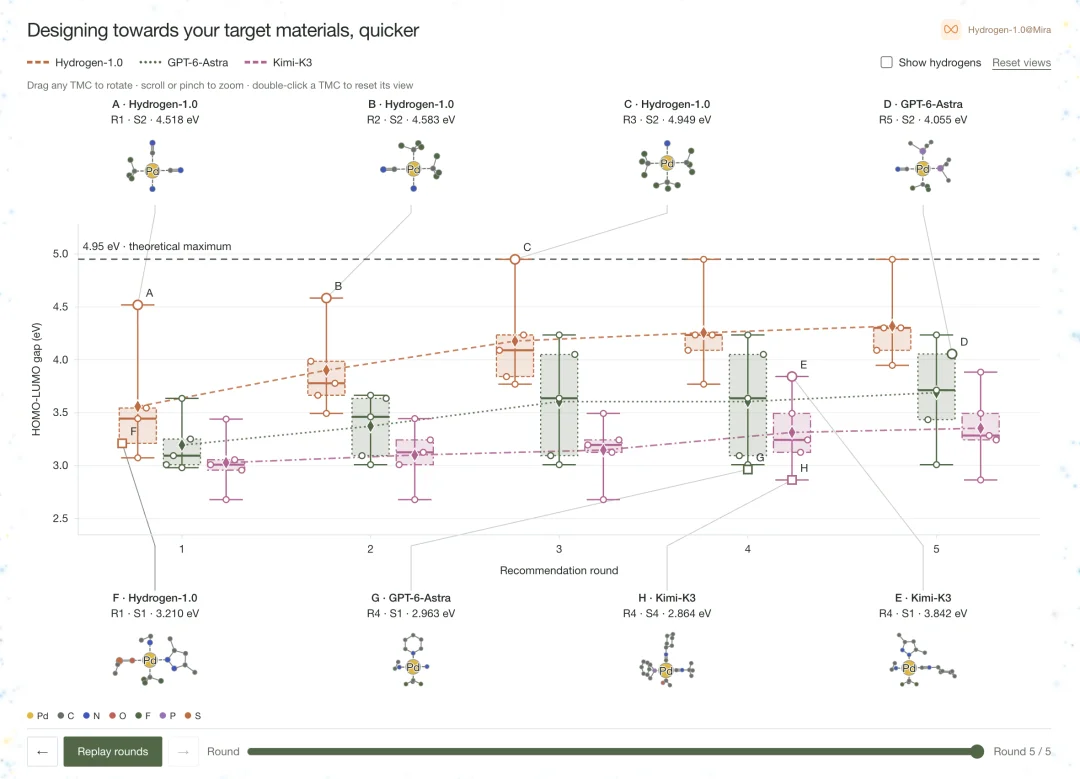
第五轮,Hydrogen-1.0 的最佳 HOMO-LUMO 带隙到 4.318 eV,GPT-6-Astra 是 3.689,Kimi-K3 是 3.353。
数字看着不大,背后的东西却不小。
这是模型在只有自己反馈的情况下,一步步学会往目标性质靠拢。
换句话说,它开始表现出一种接近直觉的东西,知道哪些候选值得探索,哪些观测值得做,一条路走不通的时候怎么掉头。
深度原理官方有一句话,我特别喜欢:「科学是一个开放式的探索,AI 可以无限地探索和创造价值。」
我只觉得,科研里最贵的东西从来不是算力,是判断力。
该试什么、不该试什么、哪个实验值得做、哪个假设该放弃,这些决定耗掉了无数研究者的时间和热情。
如果模型能从完整轨迹里学到一点这种判断力,哪怕只是皮毛,对科研效率的改善都可能是数量级的。
当然,边界也要说清楚。
目前的评测大多来自他们内部场景,领先幅度是几个百分点,需要更多第三方复现;NMR 那一项,他们自己承认不如 Astra。
科学模型离真正替代科研决策,还有很多值得见证的路要走。
而一个信号是,科学发现的能力,正在第一次以开源权重的方式,被交到所有人手里。
以后任何一个实验室,不管规模大小,都能下载一个会设计实验、会写协议、会修流程、会从失败里学习的模型,在自己的数据上接着训。
随着模型越来越多参与发现,它们要学习的数据里,会出现越来越多它们自己帮助做出的发现。
模型要从明天的观察里学习,包括它自己创造的明天。这个闭环一旦转起来,科学进步的速度会超出所有人的预期。
小时候,我们很多人的梦想是成为一名科学家。
也许,这就是最好的时代。
文章来自于微信公众号 “AI异类弗兰克”,作者 “AI异类弗兰克”

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
