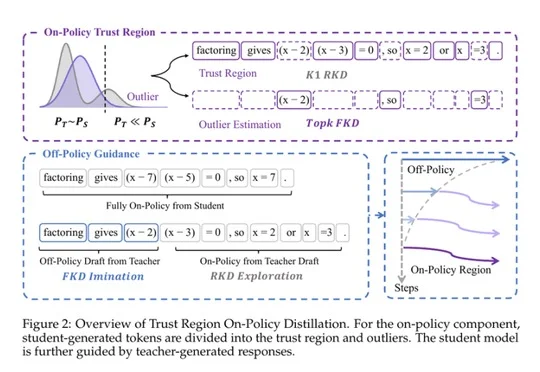
大模型Scaling撞上成本墙:三星提出TrOPD新方法,把前沿智能塞进数亿终端
大模型Scaling撞上成本墙:三星提出TrOPD新方法,把前沿智能塞进数亿终端三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
来自主题: AI技术研报
7753 点击 2026-09-18 15:48

 搜索
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
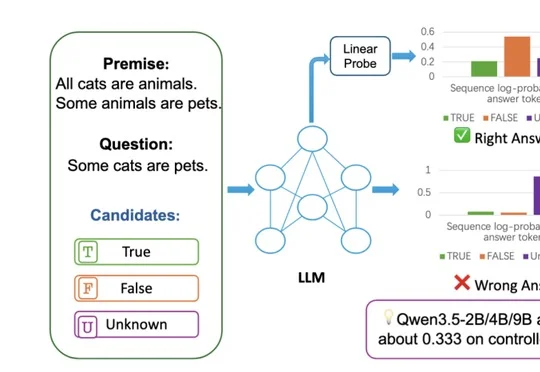
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
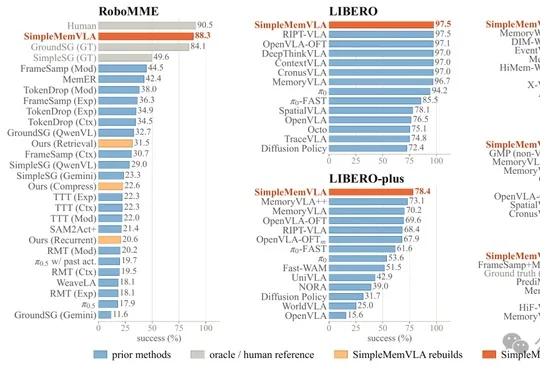
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
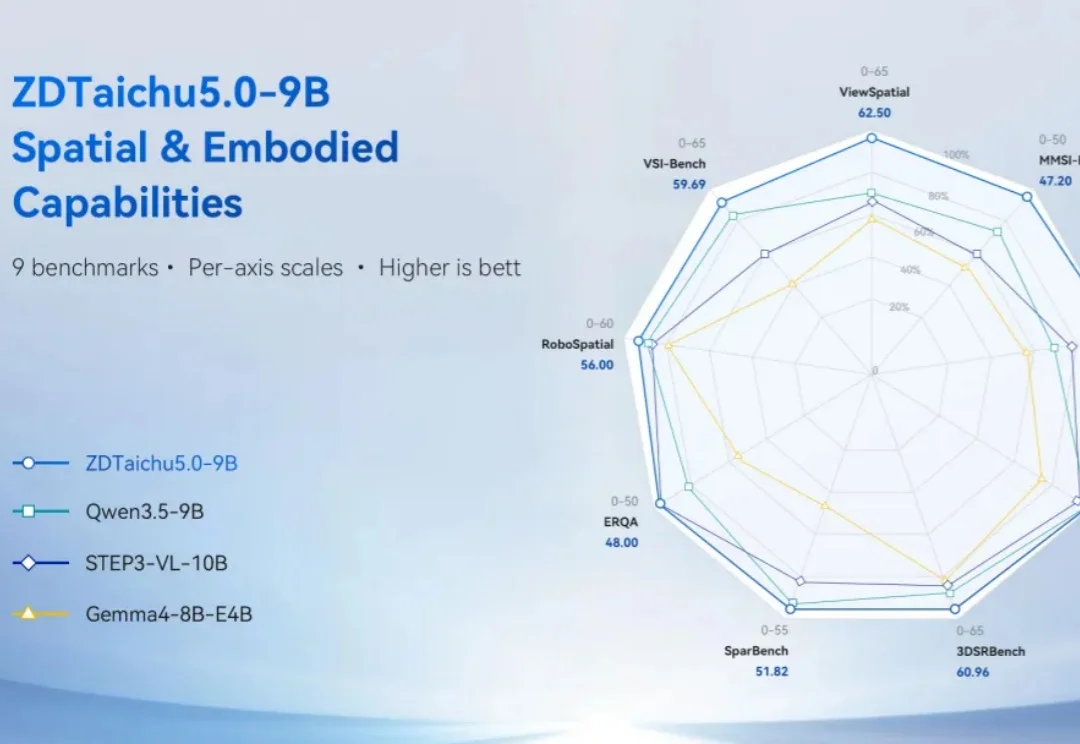
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。
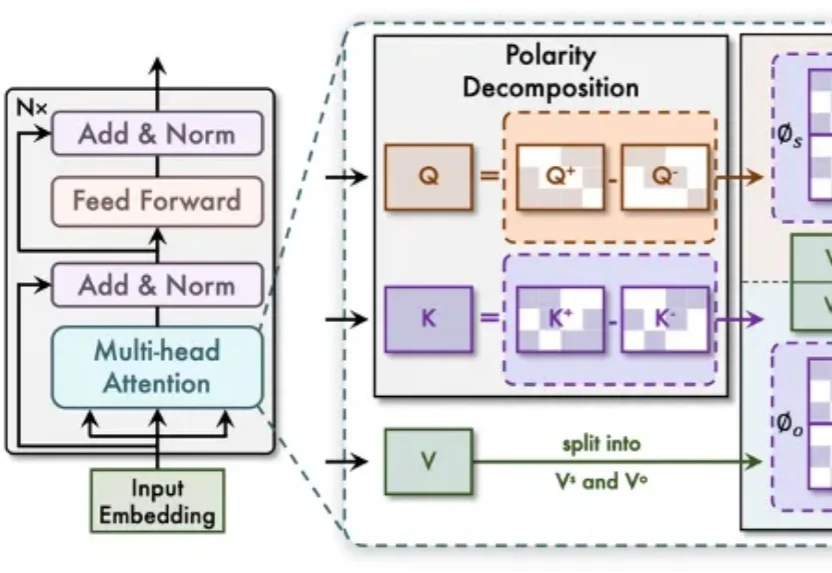
继 ICLR 2025 的 PolaFormer 之后,哈工大(深圳)与鹏城实验室合作的扩展版本 PolaFormer++ 近日被 IEEE TPAMI 正式接收。新版本在理论框架、特征映射设计和实验覆盖面上全面升级:首次给出判定特征映射是否具备「降熵尖锐性」的理论判据,并提出极性感知的通道级尖锐(PaCS)特征映射,在六大类视觉核心任务上全面验证了线性注意力的潜力。
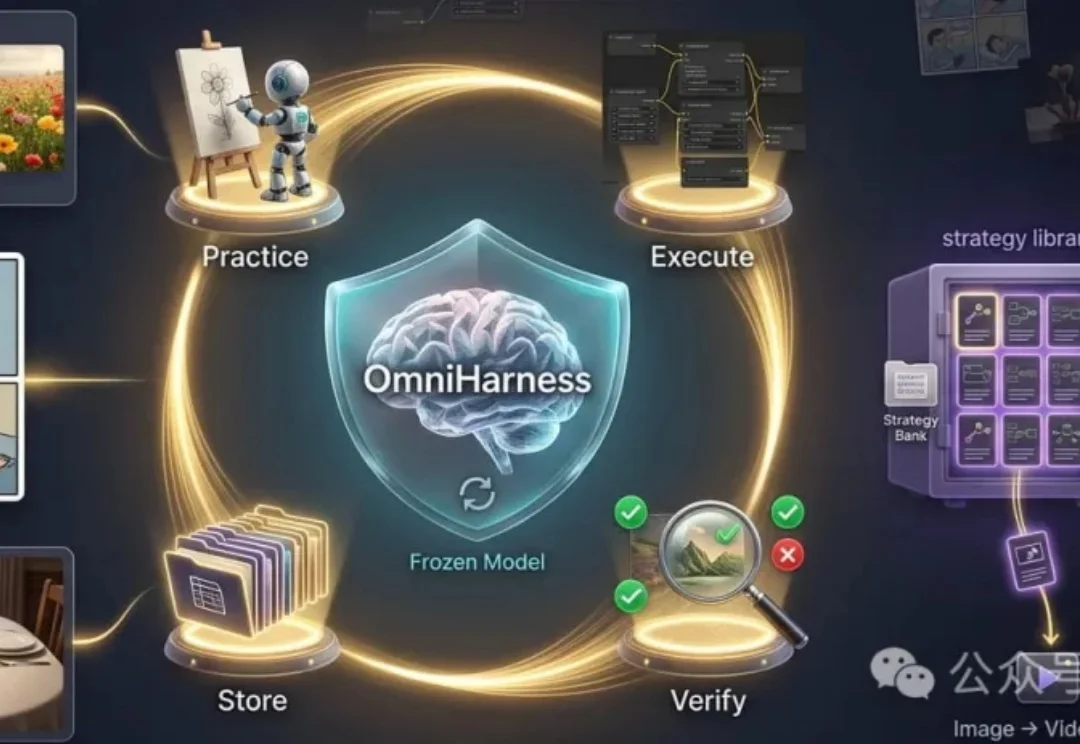
AI完成任务之后,还能留下什么?
谷歌,可能已经破解了RSI!
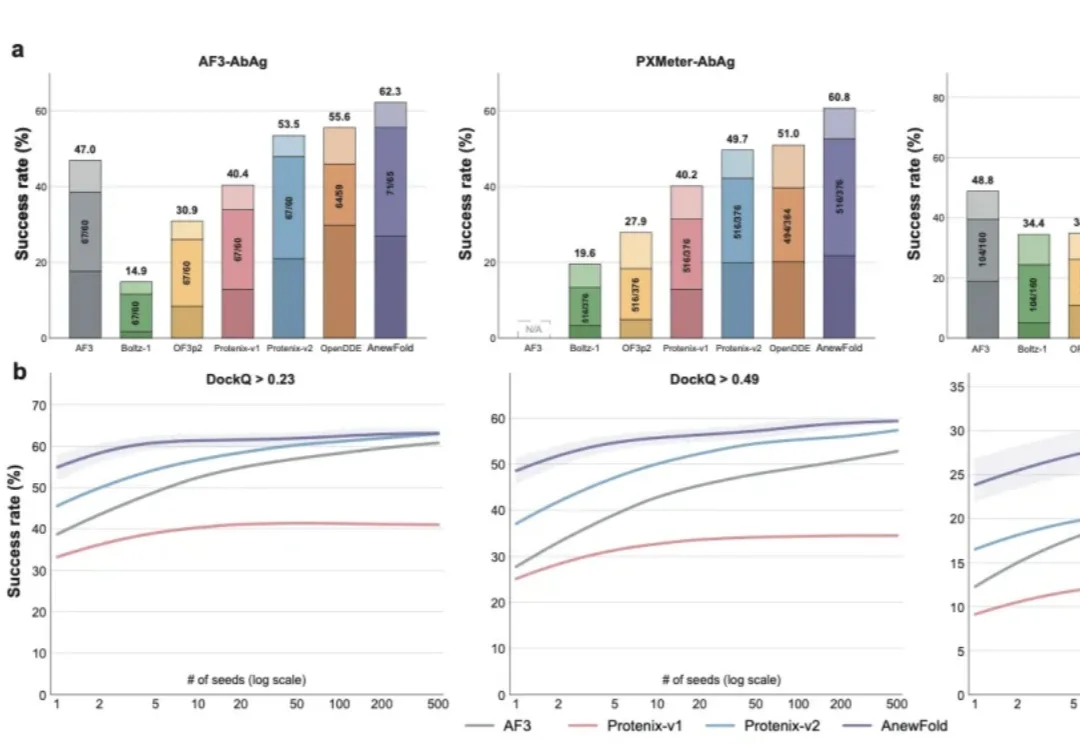
一笔融资、一份技术报告,让一个过去五年鲜少公开发声的团队,逐渐显露出更完整的面貌。
9 月 3 日,OpenAI 正式发布 GPT-6 Astra。在 ARC-AGI-3(一个考验 AI 能否在陌生环境中自主探索、理解规则并规划行动的 Benchmark),Astra 拿下 99.9%,并在 96% 的关卡中达到或超过人类的行动效率基准。
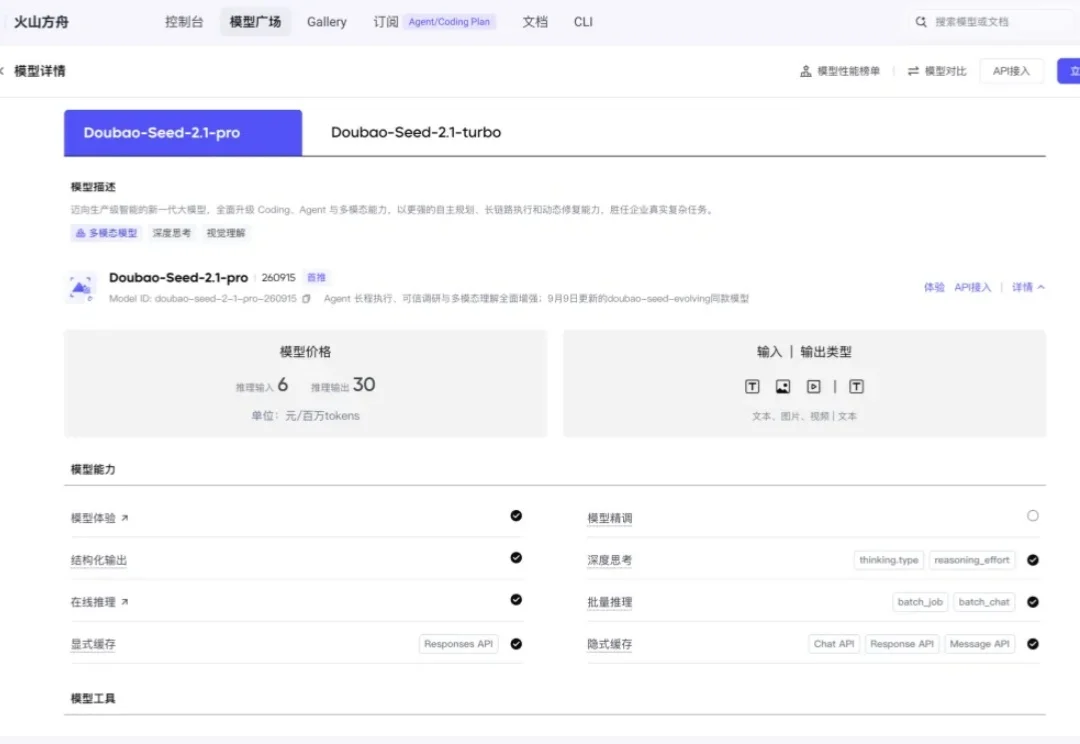
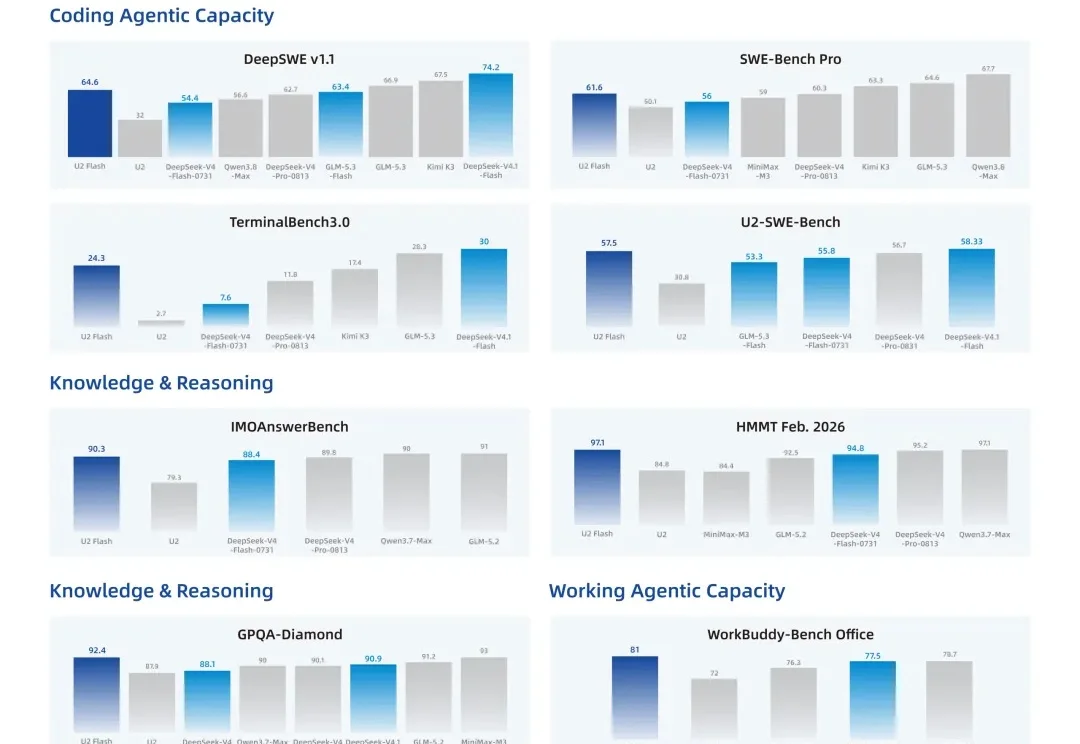
最近Seed-2.1-pro又更新了。
RSI,彻底火了。
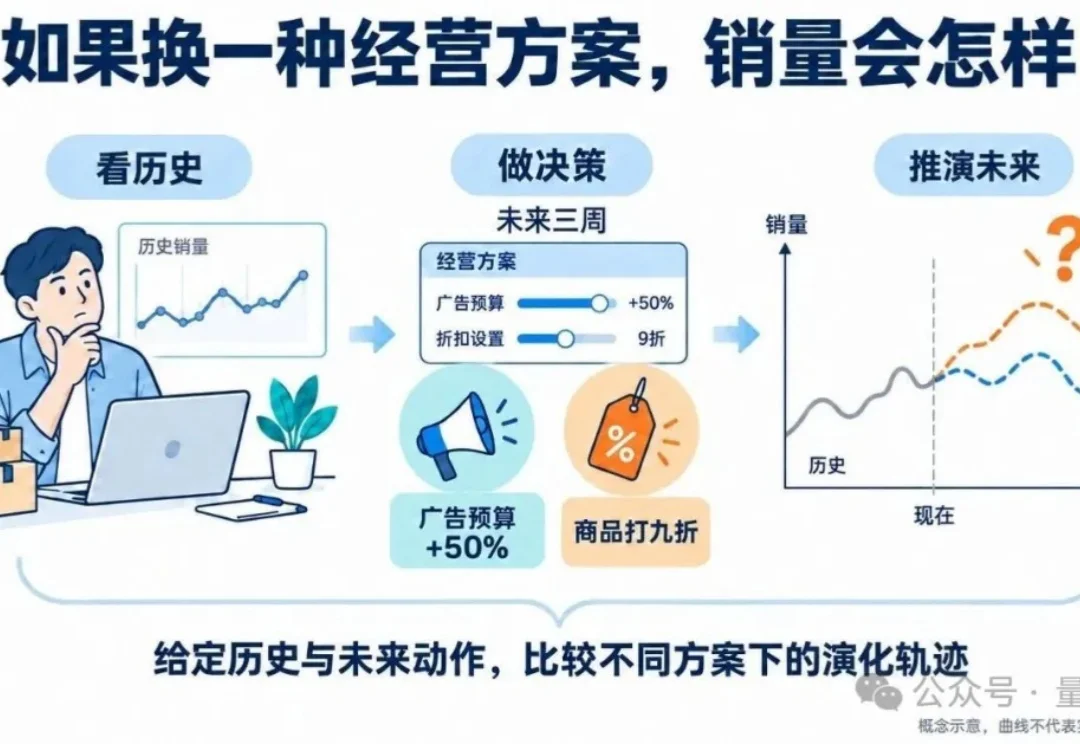
真实世界的时间序列,不仅被外部事件冲击,也被人为决策持续重塑。
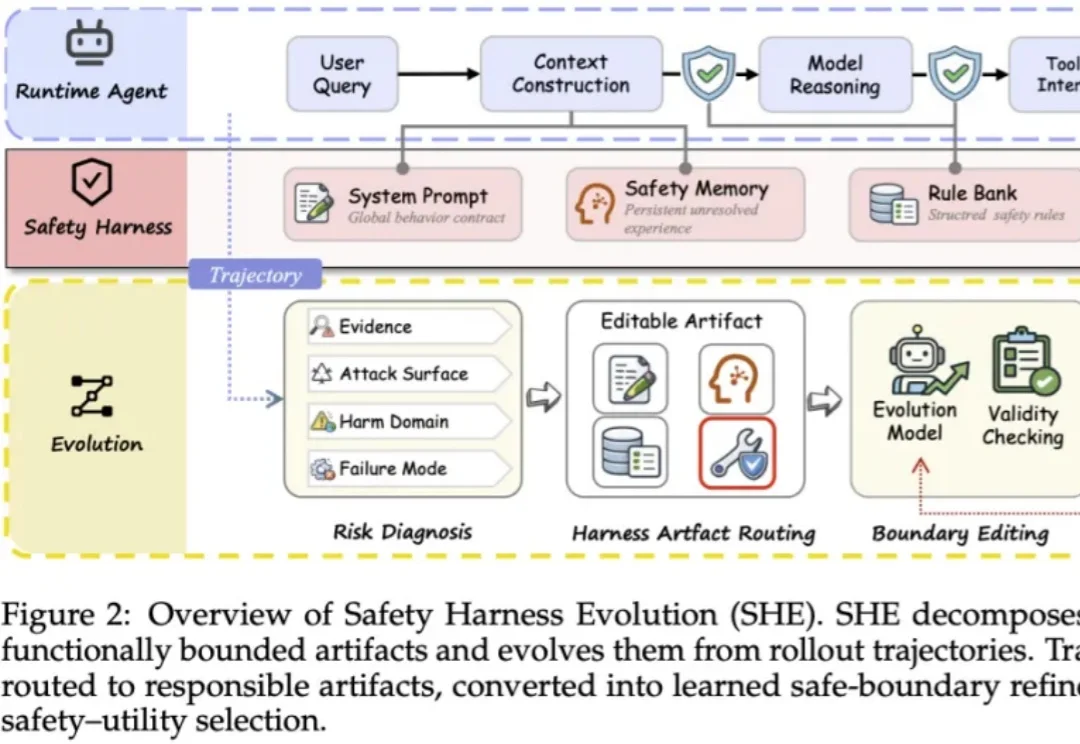
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
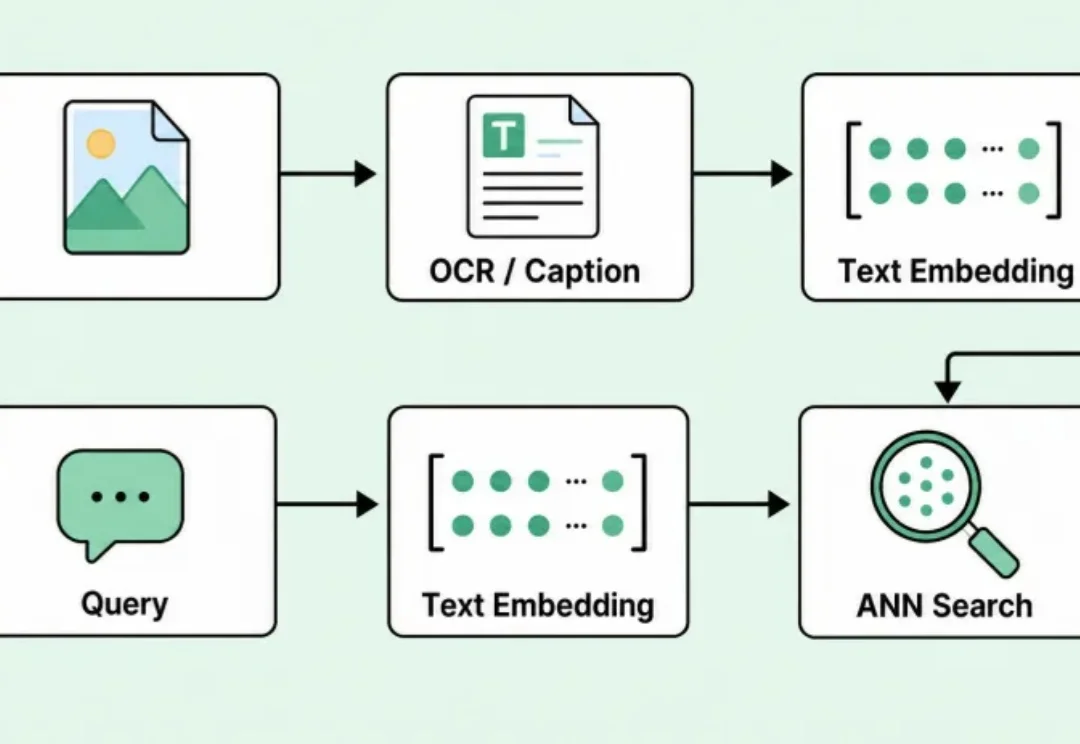
前不久,微信视觉团队开源了WeMM-Embedding。
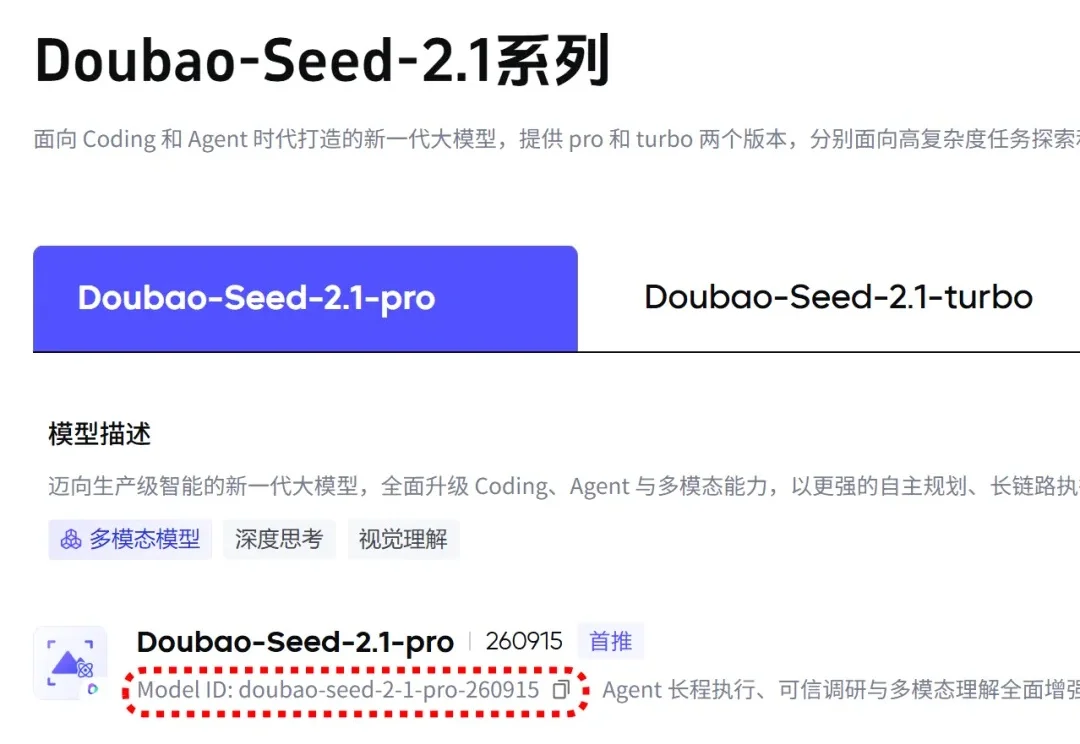
盼了三个月,今天 Seed-2.1-pro 终于迭代了 图片
43页财报一句话变带图表网页。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
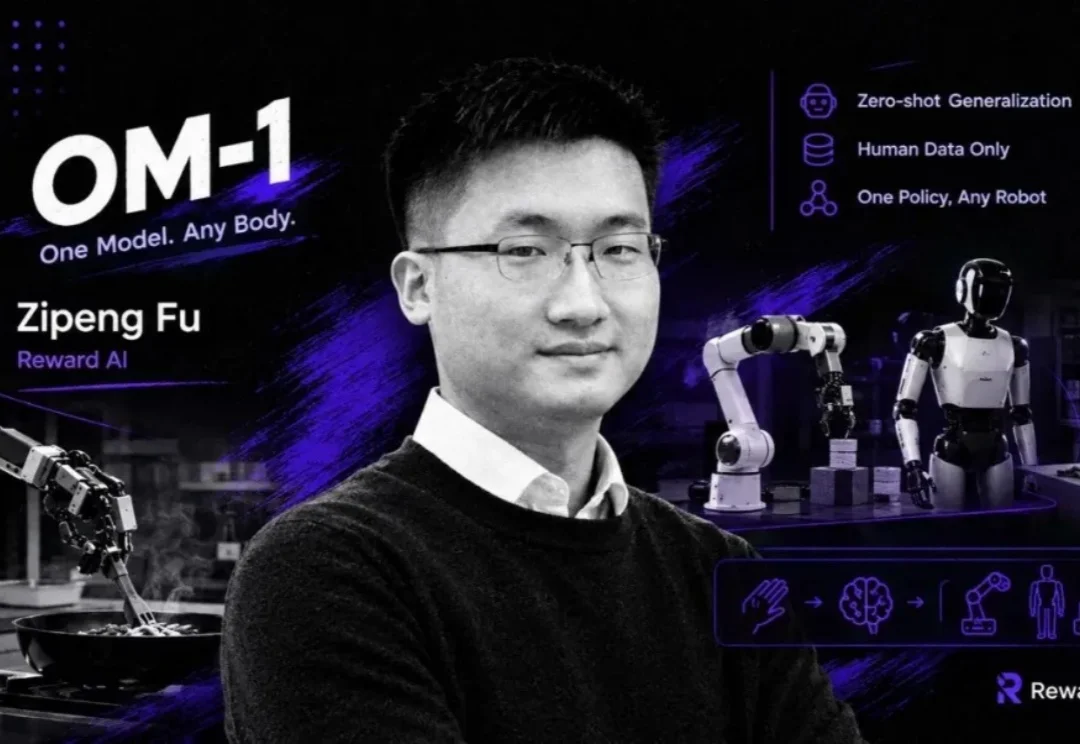
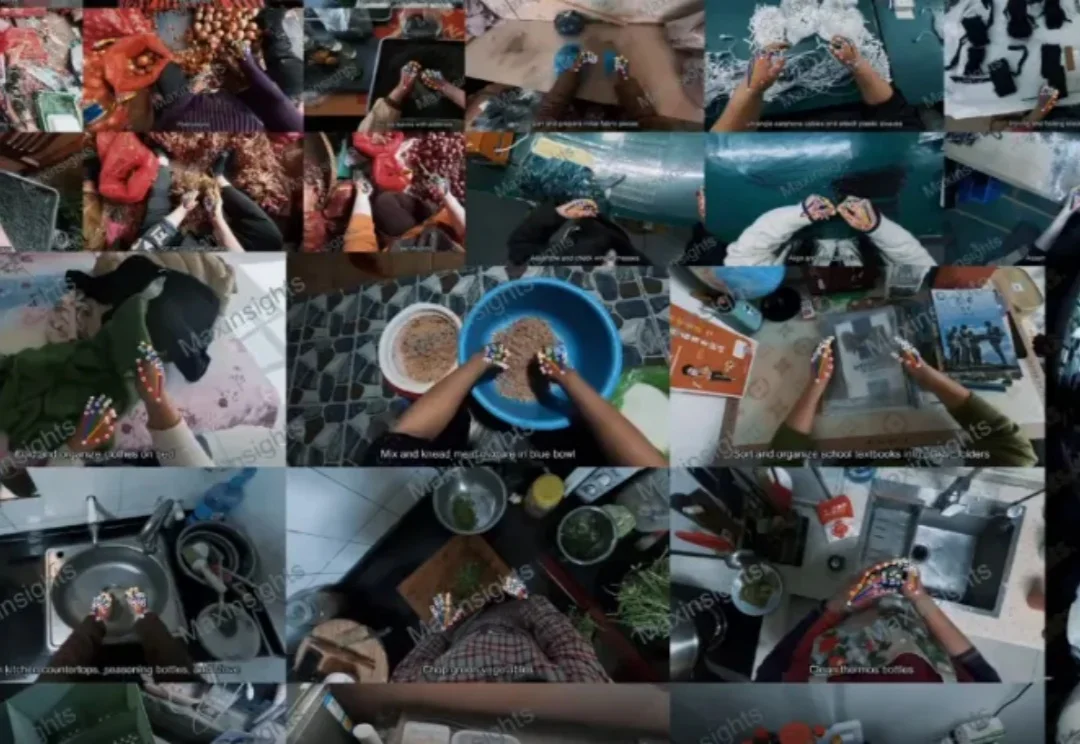
近期,由斯坦福大学计算机科学博士符梓鹏(Zipeng Fu)联合创立的新团队Reward AI,正式发布通用机器人策略OM-1(Omnibody Model 1),并公布了完整的Omnibody技术栈。
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
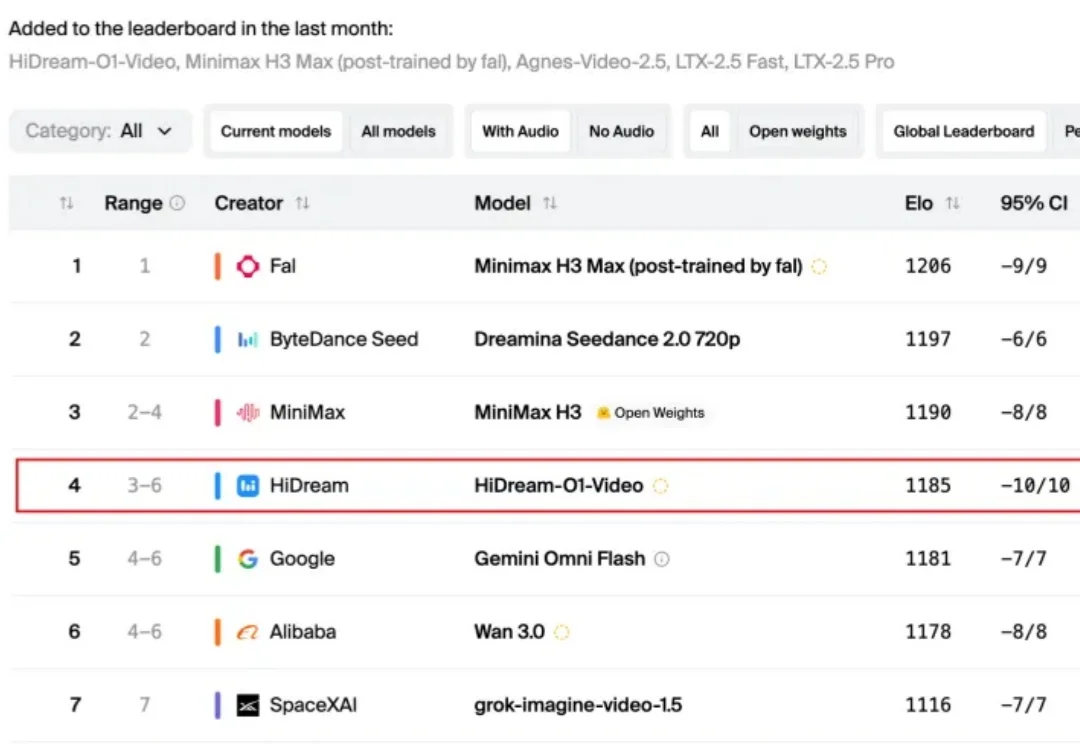
最近几个月,AI 视频赛道开始热起来了: Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
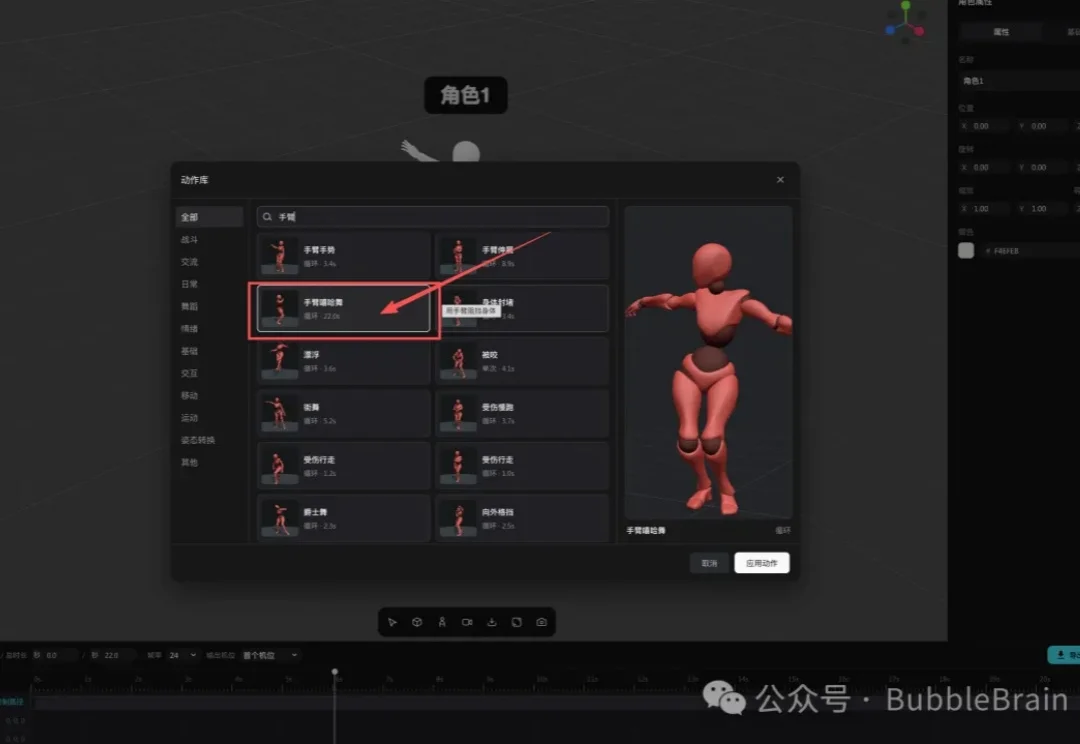
Seedance 2.5 让我这个半吊子的AI视频创作者都能上瘾玩上一个多月,就不用再多余说表现有多强了吧。
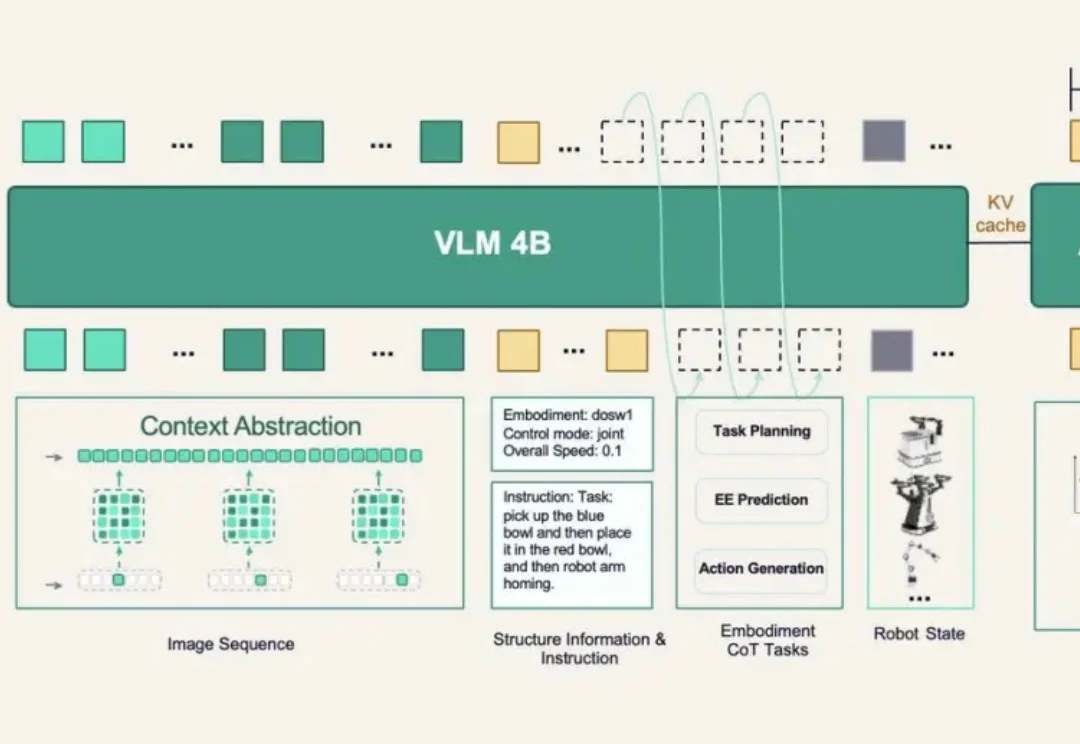
具身智能最近又多了一张榜单,而排在第一的,还是一个熟悉的名字:原力灵机 DM0.5。
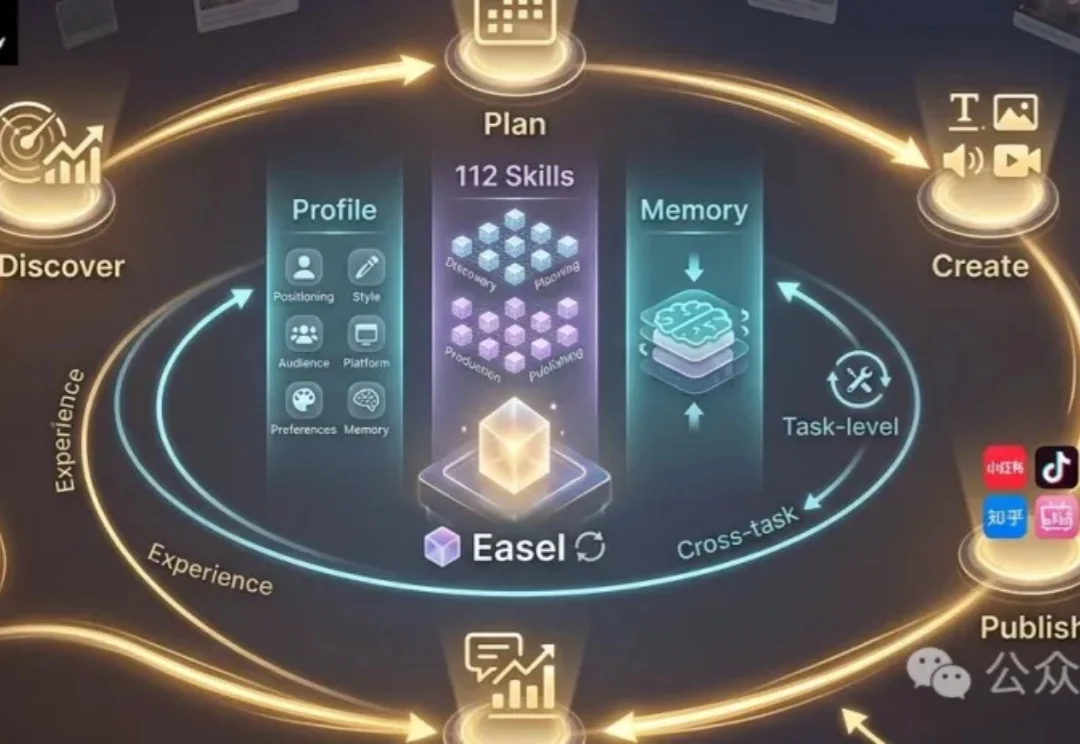
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
一个 Agent 第一次没把任务做对。
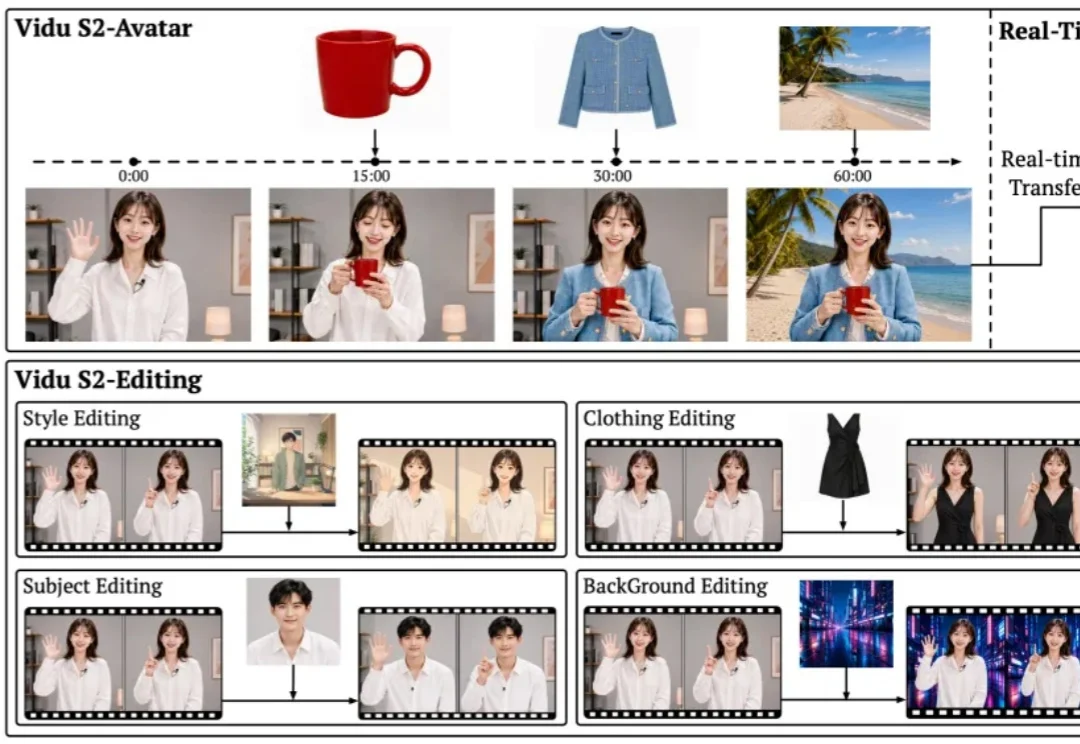
AI 视频,正在变成一个可以边播、边演、边改的实时系统。
想象一下这个场景:一场多人线上会议,有人说话时画面自动聚焦到发言者;一段综艺素材,后期系统能自动识别谁在讲话并生成字幕;一段监控录像,系统能在人群中持续追踪正在说话的那个人。
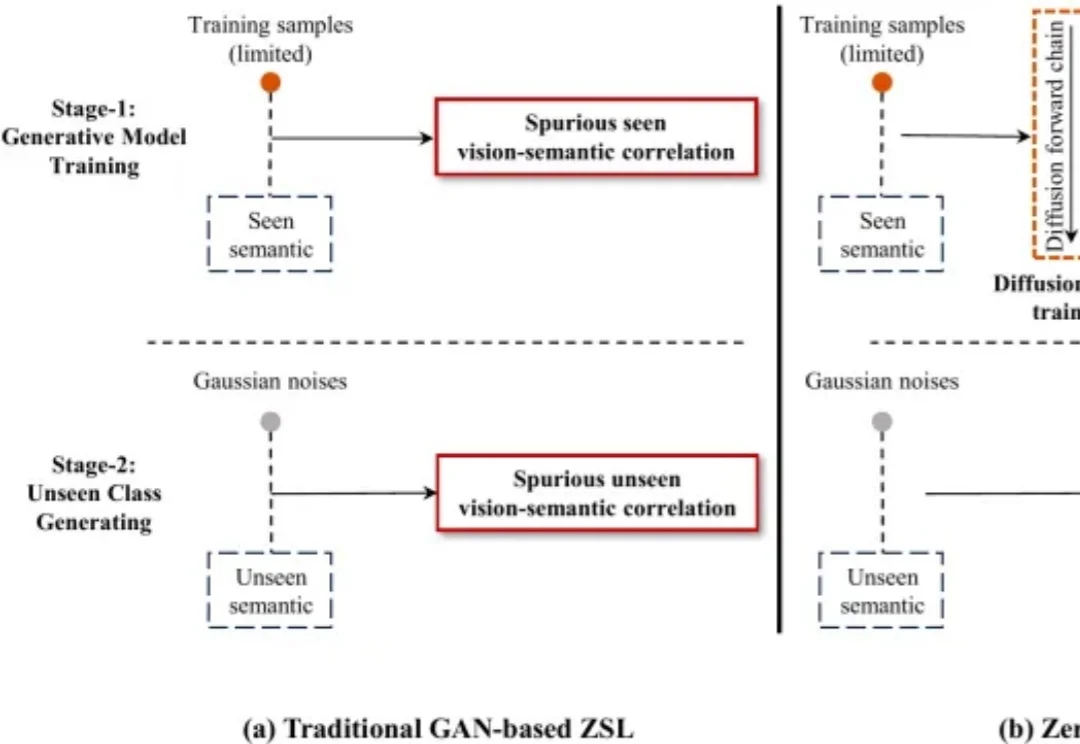
零样本学习的目标,是让模型识别训练时从未出现过的类别。
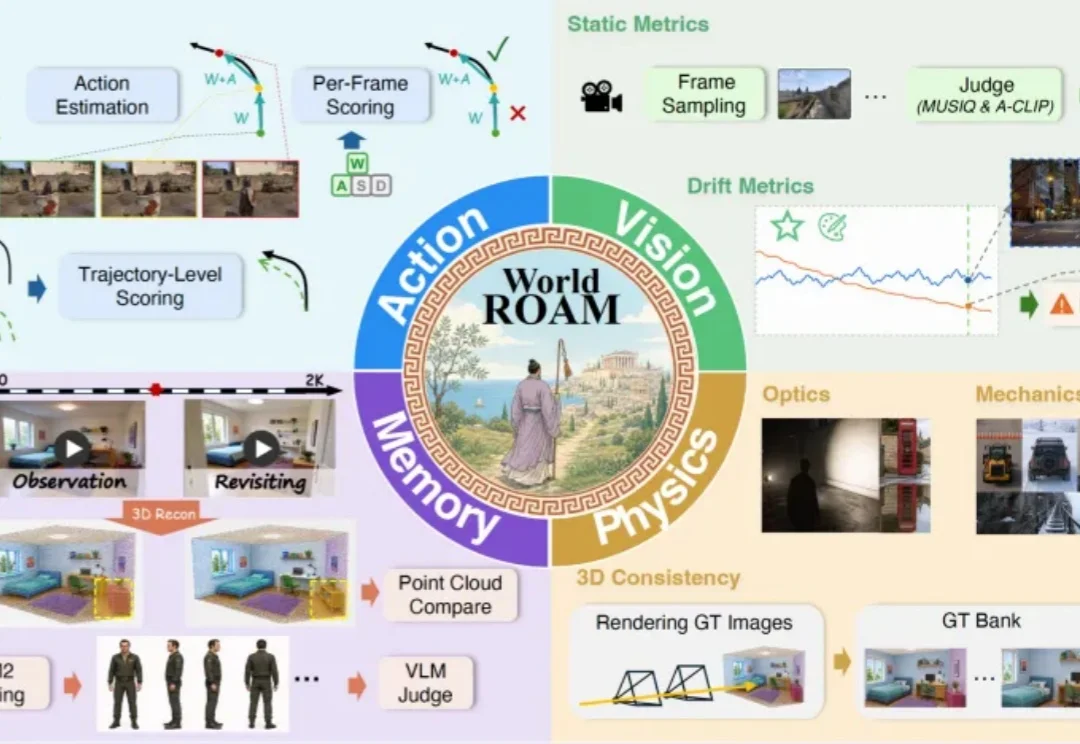
随着 Genie 3 的发布,可交互世界模型真正走到台前:用户不再只是观看生成视频,而是可以输入动作实时改变一个持续演化的世界。世界模型开始从「生成一段视频」走向「模拟一个可交互世界」,但能走进去,不等于经得起探索。模型能否持续响应控制、维持视觉与空间一致、遵守物理规律并记住来路,仍缺少系统评测。
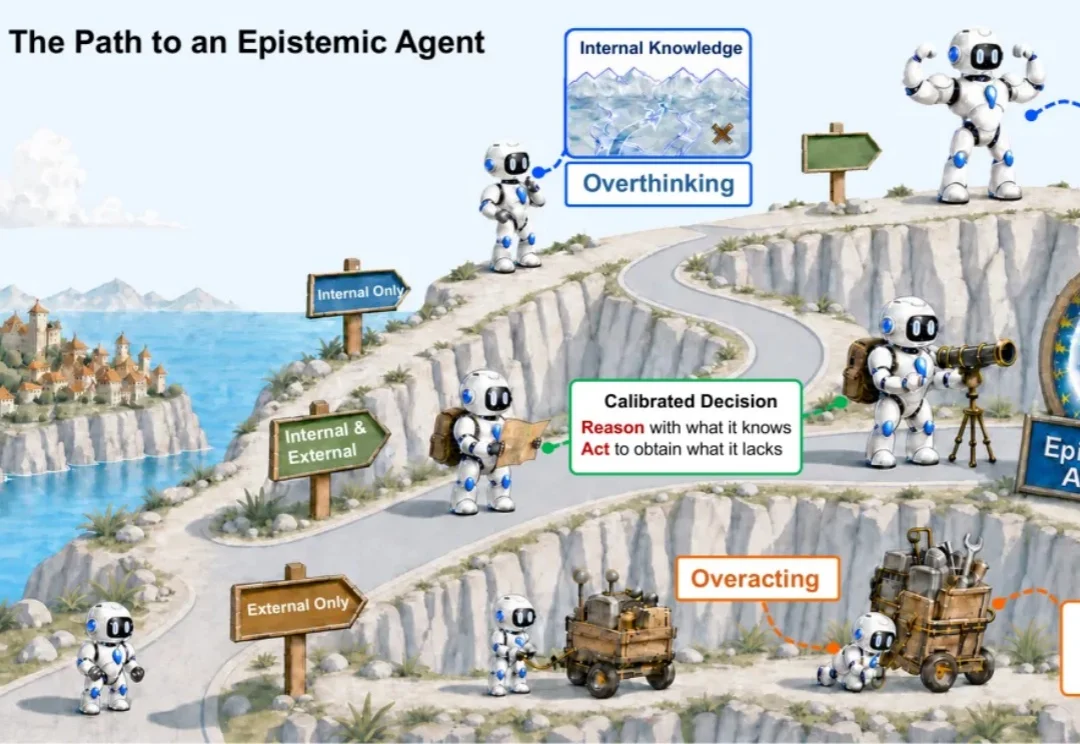
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。