Meshy: 角色驱动下SPMD范式的RL训练框架
Meshy: 角色驱动下SPMD范式的RL训练框架在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
搜索
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
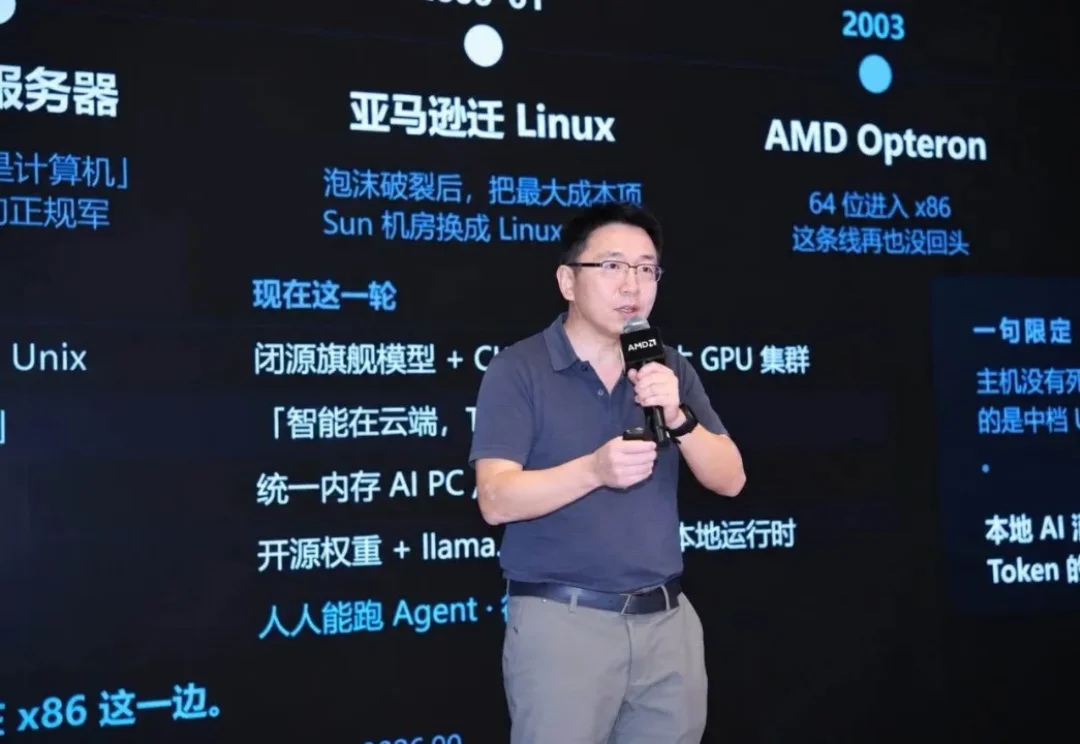
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
今年2月,华尔街差一点就给SaaS办了场葬礼。
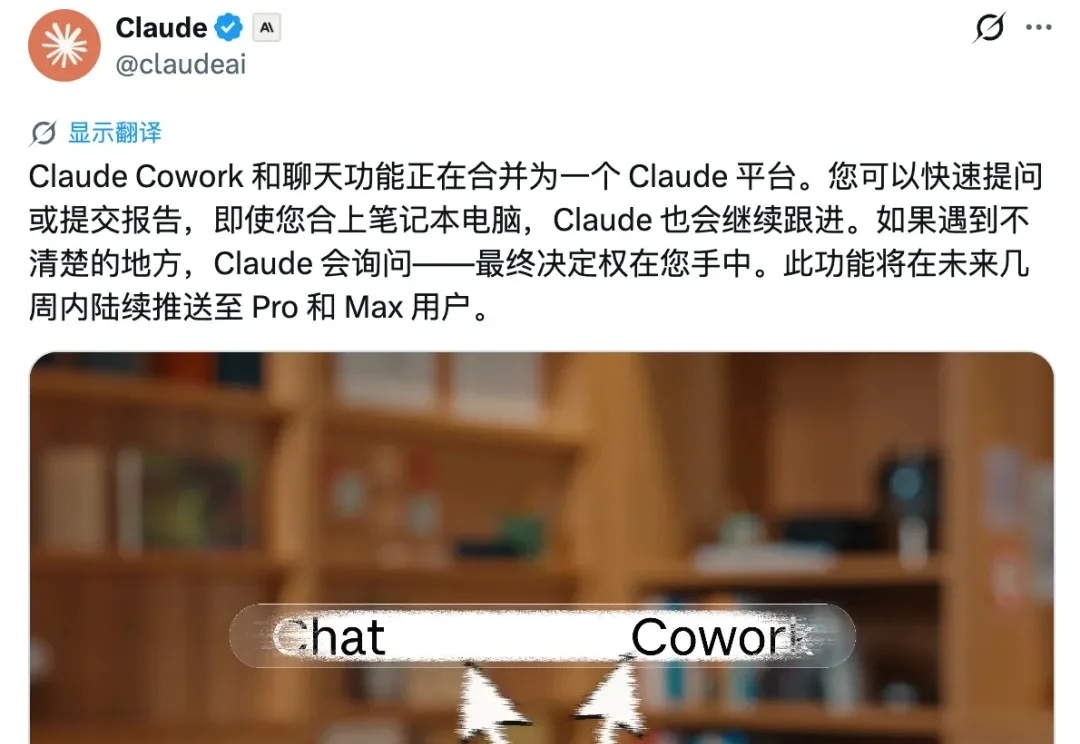
Claude 的「大一统」时刻终于来了。
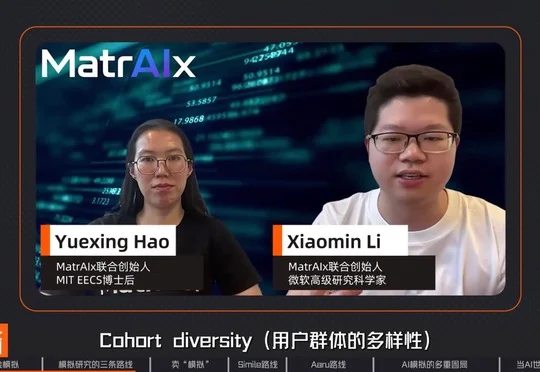
AI Simulation赛道持续升温,Simile估值达20亿美元、由00后创办的Aaru估值近10亿美元、MatrAIx构建83亿虚拟人格,企业通过让AI Agent模拟人类行为来测试产品和预测尚未发生的未来,但这门生意仍面临验证标准、预测精度和规模化等核心难题。
完美是完成的敌人。
就在上周,黄仁勋在高盛科技大会上说了一句让整个 AI 圈亢奋的话: 网络安全,很可能是 AI 的下一个杀手级应用。
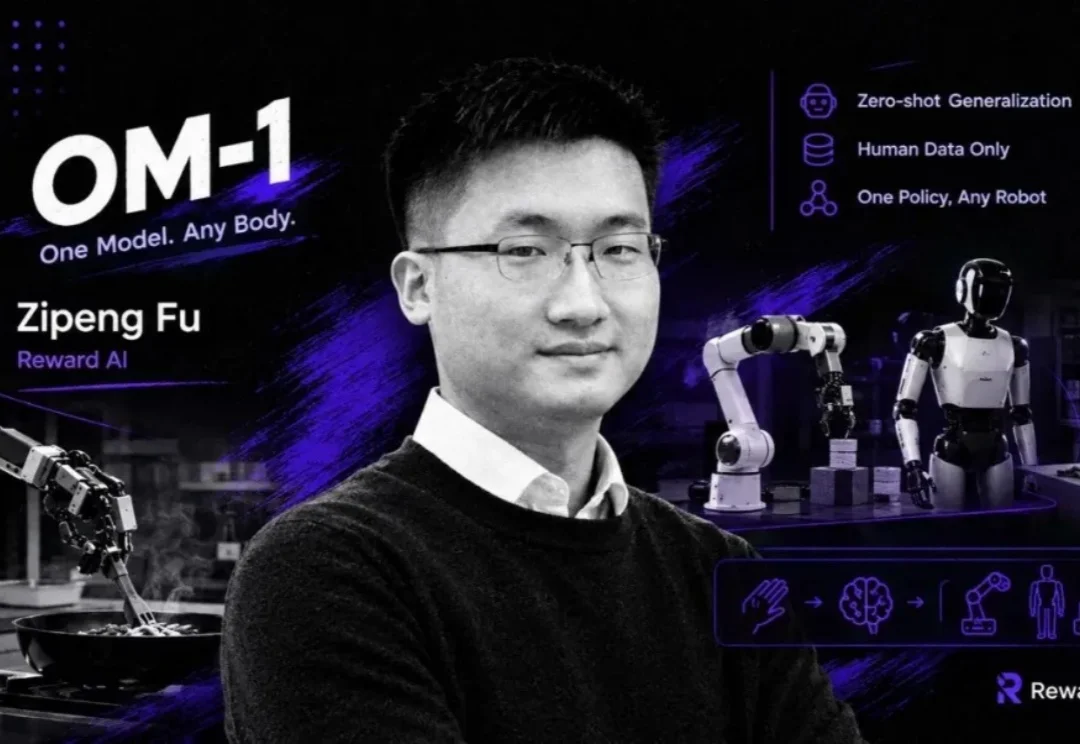
近期,由斯坦福大学计算机科学博士符梓鹏(Zipeng Fu)联合创立的新团队Reward AI,正式发布通用机器人策略OM-1(Omnibody Model 1),并公布了完整的Omnibody技术栈。
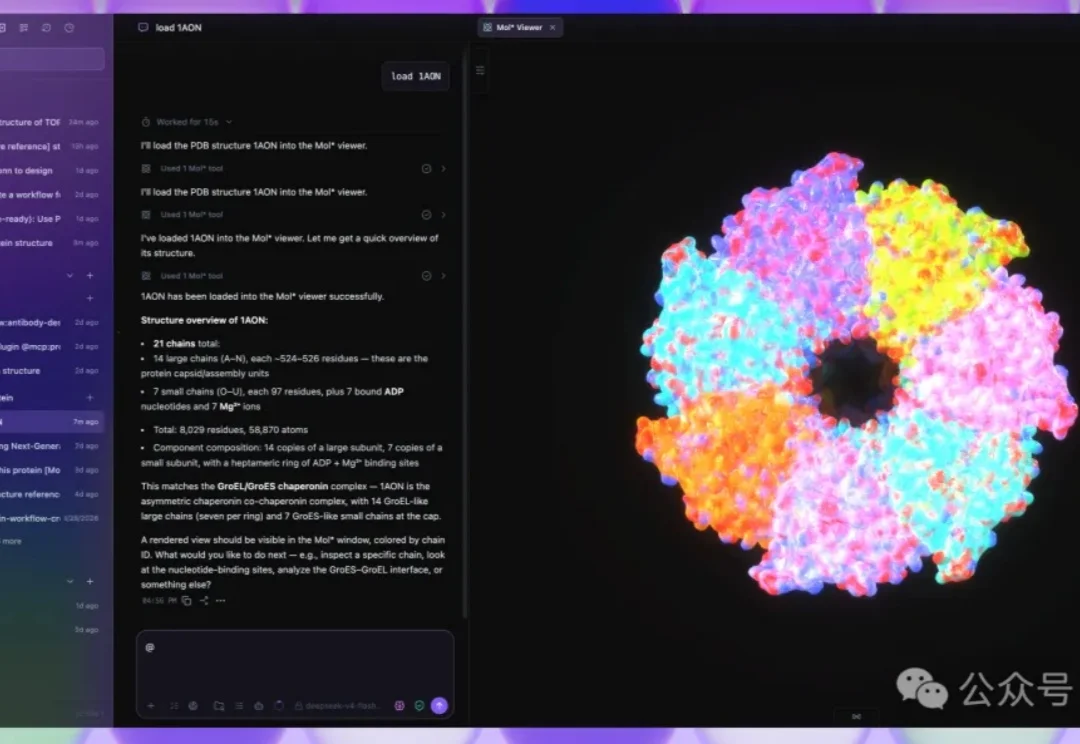
AI for Science的竞争,正在向科研闭环延伸。
美国当地时间9月14日消息,据外媒报道,OpenAI正在推进一项代号为“Lily计划”(Project Lily)的内部项目。