
清华一作1B暴打405B巨无霸,7B逆袭DeepSeek R1!测试时Scaling封神
清华一作1B暴打405B巨无霸,7B逆袭DeepSeek R1!测试时Scaling封神【新智元导读】仅凭测试时Scaling,1B模型竟完胜405B!多机构联手巧妙应用计算最优TTS策略,不仅0.5B模型在数学任务上碾压GPT-4o,7B模型更是力压o1、DeepSeek R1这样的顶尖选手。
来自主题: AI技术研报
9298 点击 2025-02-13 14:18

 搜索
【新智元导读】仅凭测试时Scaling,1B模型竟完胜405B!多机构联手巧妙应用计算最优TTS策略,不仅0.5B模型在数学任务上碾压GPT-4o,7B模型更是力压o1、DeepSeek R1这样的顶尖选手。
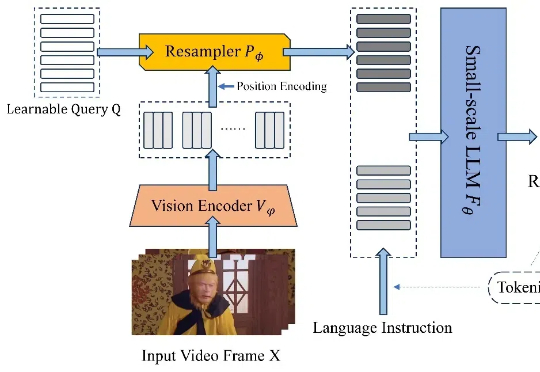
近日,北京航空航天大学的研究团队基于 TinyLLaVA_Factory 的原项目,推出小尺寸简易视频理解框架 TinyLLaVA-Video,其模型,代码以及训练数据全部开源。在计算资源需求显著降低的前提下,训练出的整体参数量不超过 4B 的模型在多个视频理解 benchmark 上优于现有的 7B + 模型。
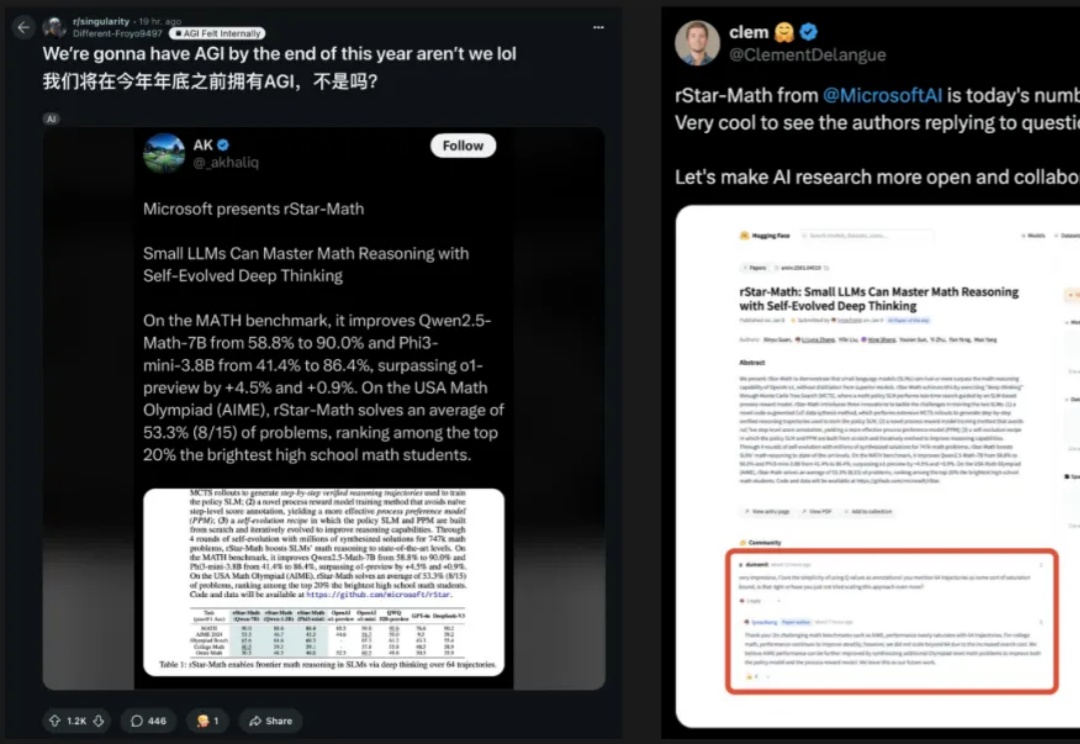
小模型也能击败o1?微软全华人团队提出rStar-Math算法,三大革命性技术突破,不仅让SLM在数学推理能力上刷新SOTA,更是挤进了全美20%顶尖高中生榜单。
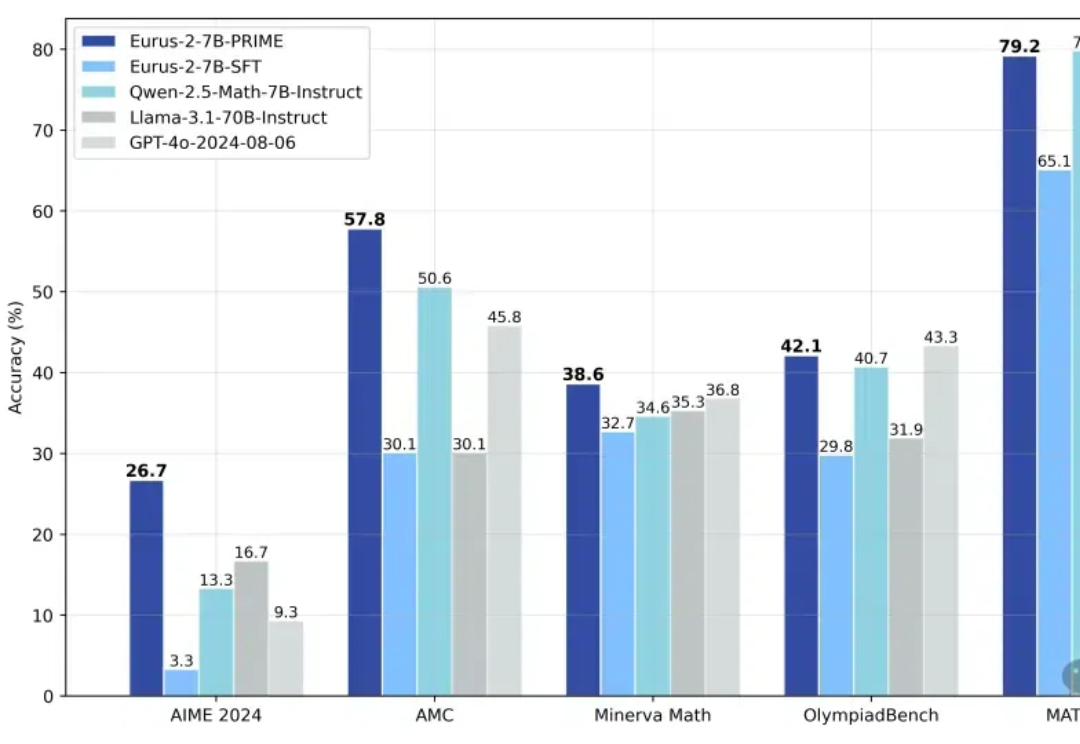
OpenAI o1和o3模型的发布证明了强化学习能够让大模型拥有像人一样的快速迭代试错、深度思考的高阶推理能力,在基于模仿学习的Scaling Law逐渐受到质疑的今天,基于探索的强化学习有望带来新的Scaling Law。
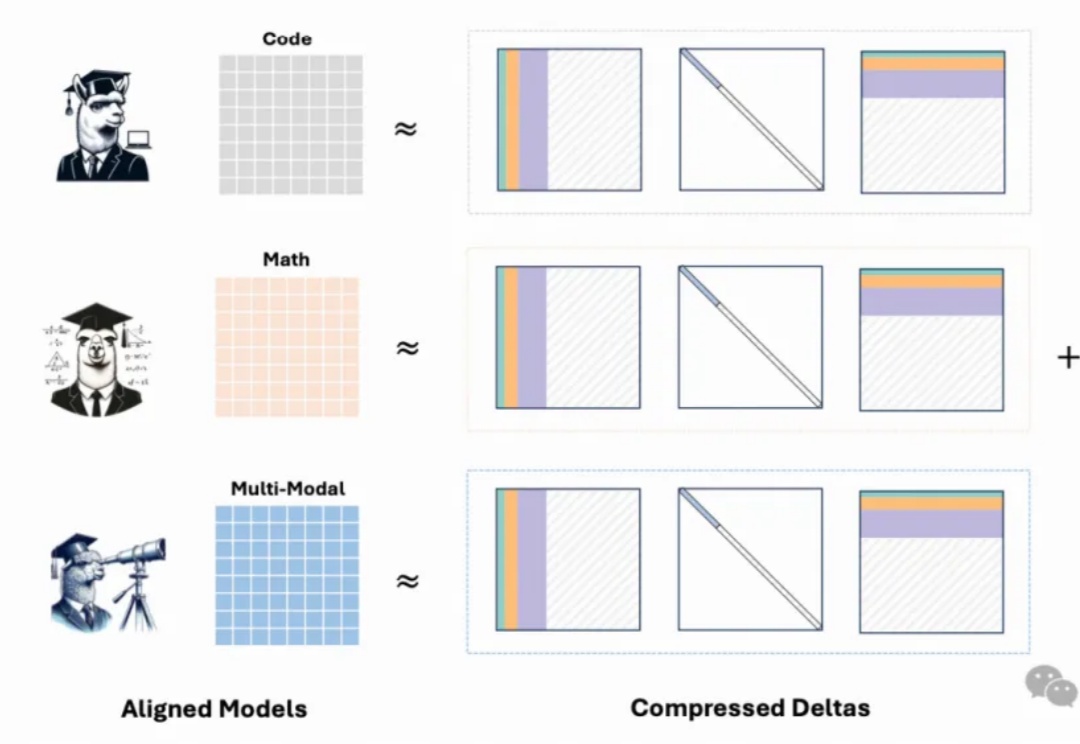
最新模型增量压缩技术,一个80G的A100 GPU能够轻松加载多达50个7B模型,节省显存约8倍,同时模型性能几乎与压缩前的微调模型相当。
消除激活值(outliers),大语言模型低比特量化有新招了—— 自动化所、清华、港城大团队最近有一篇论文入选了NeurIPS 2024(Oral Presentation),他们针对LLM权重激活量化提出了两种正交变换,有效降低了outliers现象,达到了4-bit的新SOTA。
工具调用是 AI 智能体的关键功能之一,AI 智能体根据场景变化动态地选择和调用合适的工具,从而实现对复杂任务的自动化处理。例如,在智能办公场景中,模型可同时调用文档编辑工具、数据处理工具和通信工具,完成文档撰写、数据统计和信息沟通等多项任务。
苹果最新杀入开源大模型战场,而且比其他公司更开放。 推出7B模型,不仅效果与Llama 3 8B相当,而且一次性开源了全部训练过程和资源。大模型,AI,苹果AI,苹果开源模型

Mistral AI两款全新7B模型宣战OpenAI,对标更长的代码分析和更高效的数学推理。
只需激活60%的参数,就能实现与全激活稠密模型相当的性能。