启发学习:让大模型认知从外化到内生
启发学习:让大模型认知从外化到内生过去两年,大模型几乎重写了人机协作的默认想象:写代码、查资料、做分析,似乎都能 “一问即答”。但仔细看会发现,当下很多能力并不是模型自己长出来的,而是人为地在外面包了一层又一层框架。
来自主题: AI技术研报
9017 点击 2026-08-28 10:01

 搜索
过去两年,大模型几乎重写了人机协作的默认想象:写代码、查资料、做分析,似乎都能 “一问即答”。但仔细看会发现,当下很多能力并不是模型自己长出来的,而是人为地在外面包了一层又一层框架。
这几天 ox-alpha 用爽了吧...正如很多人猜的那样,这个模型来自智谱,正式名称为 glm-5.3-flash,支持多模态,但很多人没猜到的是:这个乱杀的模型只有 321B,且与 glm-5.3 不同,是完全的新架构
这是前OpenAI推理模型一号位Jerry Tworek抛出的最新暴论。他2019年进的OpenAI,一待就是七年。当年强化学习死活scale不动,是他死死咬住不放硬推上去的,o1和o3这两代大杀器都是他亲自带队砸出来的。
8月26日,据彭博社报道,智谱AI确认,近期匿名上线的Ox Alpha由其开发,是GLM系列的新一代模型。Ox意为“牛”,恰逢电影《牛来》走红,因此中文开发者社区把Ox Alpha叫作“牛来大模型”。
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分
2024 年末,Physical Intelligence 的实验室里,一台机器人正在接受叠衣服测试。
哇,Generalist的融资进度条怕是开了2倍速外挂,这也发展得太快了吧!
从 Scale AI到 Surge AI,再到异军突起的 Mercor,在北美,一批AI Data公司的价值已经被验证。
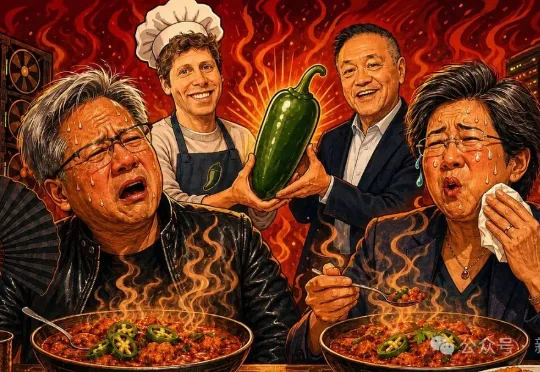
就在刚刚,OpenAI首颗自研芯片Jalapeño「墨西哥辣椒」,交出了首批实测成绩单——AI推理性能,全面反超英伟达GB200和GB300。实测速度直接起飞!Jalapeño一秒能狂吐1459个Token,英伟达GB200只有535个,连一半都不到。
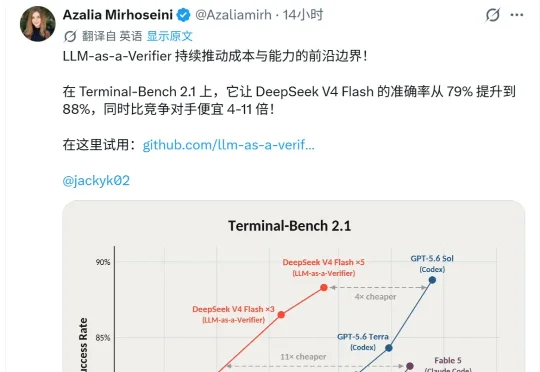
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。