
Claude一举扫清2000阶以下哈达玛矩阵!AI开始清空数学“待解列表”
Claude一举扫清2000阶以下哈达玛矩阵!AI开始清空数学“待解列表”前不久用Fable 5推翻雅可比猜想的Anthropic研究员,又吭哧吭哧和两个人类伙伴带着Claude,做出了668阶哈达玛矩阵!(好数学家不挑AI模型,doge)不过这人每次有成果都不明说,发一堆只有内行才看得懂的东西。
来自主题: AI资讯
8680 点击 2026-08-14 16:40

 搜索
前不久用Fable 5推翻雅可比猜想的Anthropic研究员,又吭哧吭哧和两个人类伙伴带着Claude,做出了668阶哈达玛矩阵!(好数学家不挑AI模型,doge)不过这人每次有成果都不明说,发一堆只有内行才看得懂的东西。

刚刚,阿里千问大模型团队开放Qwen3.8-2.4T-A95B模型权重! Qwen3.8-Max是基于Qwen3.8-2.4T-A95B的官方版本,于8月3日发布,拥有更多功能,例如视觉输入功能、无需思考即可使用、默认支持1百万上下文长度处理、内置官方工具等。

昨晚 AI 圈又炸了。阿里开源Qwen3.8-2.4T-A95B,DeepSeek V4 Pro正式版发布,马斯克推出最新一代旗舰模型Grok 4.6。7 月 16 日,Grok 4.5 才刚发布。短短 27 天,Grok 4.6 就来了。

就在刚刚,DeepSeek V4 Pro 正式版来了。最新的模型与价格页面显示,deepseek-v4-pro 对应模型版本已经更新为 DeepSeek-V4-Pro-0813。从目前公布的信息来看,deepseek-v4-pro 支持 1M 上下文长度,最大输出长度达到 384K Token,同时支持非思考模式和思考模式,其中思考模式默认开启。

8月,AI战况已彻底焦灼。

GPT-5.6和Fable 5联手,解决了一道悬置25年的数学难题。微软研究院首席研究员Dimitris Papailiopoulos,证明了一个多项式时间算法,能让MIMO检测精确命中最大似然阈值。

今天,英国《金融时报》援引知情人士报道,字节跳动正在训练一个参数量高达10万亿的AI模型。而这一数字,在昨日晚间的晚点LatePost独家报道中还是“超5万亿”。即使是5万亿,这一模型的规模也已经超过目前中国已发布的最大模型Kimi K3,接近Anthropic的Fable 5;如果是10万亿,那字节的新模型规模将超越约有8万亿参数的Mythos 5。
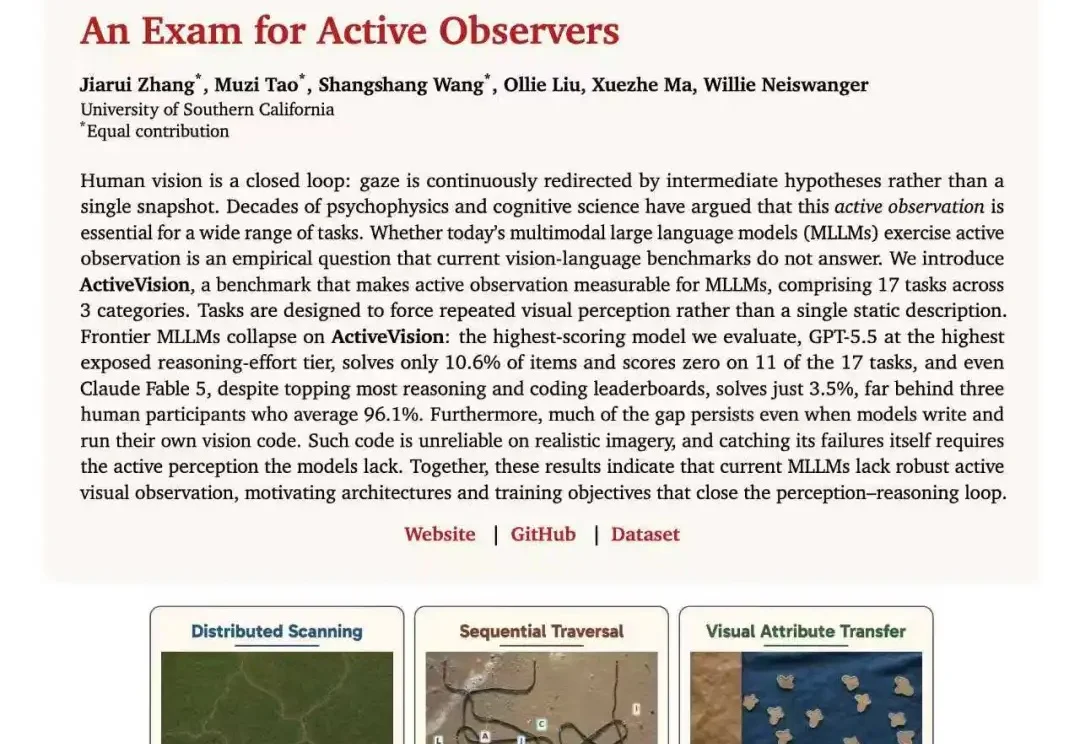
人类看图时,不会先在大脑中拍下一张「截图」,再闭眼推理。思考过程会不断引导我们的目光:找到一个线索,形成一个假设,再回到图像里验证它。

Claude这次,真把AI编程榜单打出断层了!就在刚刚刷新的MirrorCode排行榜上,Claude Fable 5以64%的绝对成功率再次登顶。 排在第四的GPT-5.5更惨。不仅成绩只有10%,甚至还被自家前辈GPT-5.4按在地上摩擦。

10项数学难题,24小时反转。