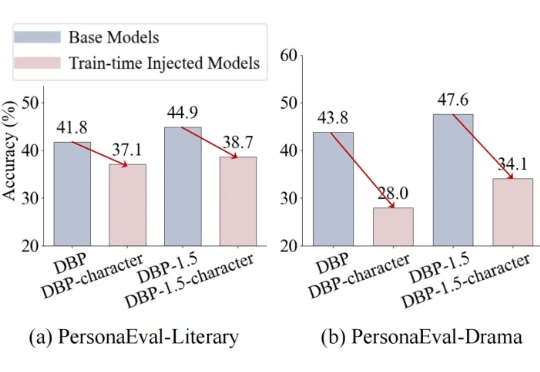
大模型给自己当裁判并不靠谱!上海交通大学新研究揭示LLM-as-a-judge机制缺陷
大模型给自己当裁判并不靠谱!上海交通大学新研究揭示LLM-as-a-judge机制缺陷大语言模型(LLM)正从工具进化为“裁判”(LLM-as-a-judge),开始大规模地评判由AI自己生成的内容。这种高效的评估范式,其可靠性与人类判断的一致性,却很少被深入验证。
来自主题: AI技术研报
8599 点击 2025-08-17 13:16

 搜索
大语言模型(LLM)正从工具进化为“裁判”(LLM-as-a-judge),开始大规模地评判由AI自己生成的内容。这种高效的评估范式,其可靠性与人类判断的一致性,却很少被深入验证。

2025 年,人工智能的叙事已经不再靠“模型突破”来驱动,而是进入了“应用激战区”。 硅谷著名孵化器 Y Combinator 在官网上直言——“2025 年有望成为 AI Agent 之年。”

前几天发现一个有意思的应用 Macaron,靠颜值就吸引了我,整个设计风格非常的阳光而且高级,尤其是里面的图标,很好看。

“一句话做应用”,虽说这个概念已经并不新鲜。但说实话,市面上能真正达到交付标准的产品寥寥无几。
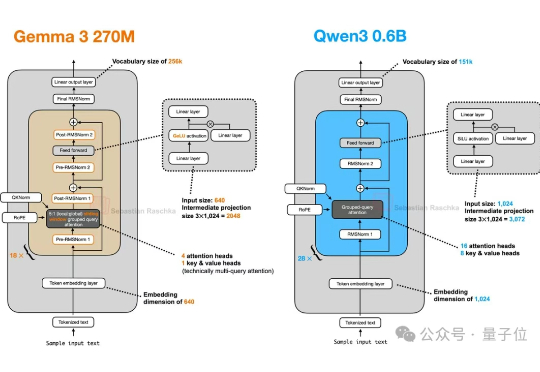
谷歌开源Gemma 3 270M闪亮登场!只需几分钟即可完成微调,指令遵循和文本结构化能力更是惊艳,性能超越Qwen 2.5同级模型。
首个开源多模态Deep Research Agent来了。整合了网页浏览、图像搜索、代码解释器、内部 OCR 等多种工具,通过全自动流程生成高质量推理轨迹,并用冷启动微调和强化学习优化决策,使模型在任务中能自主选择合适的工具组合和推理路径。
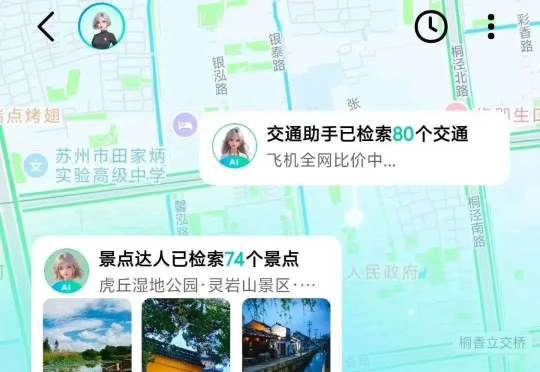
10亿用户App转向AI原生应用,大船如何掉头?高德最近打了个样,用AI重构底层技术栈,建立主-从Agent架构,将千问大模型与空间智能结合,展现出了新范式的强大威力,给用户带去了极大便利。
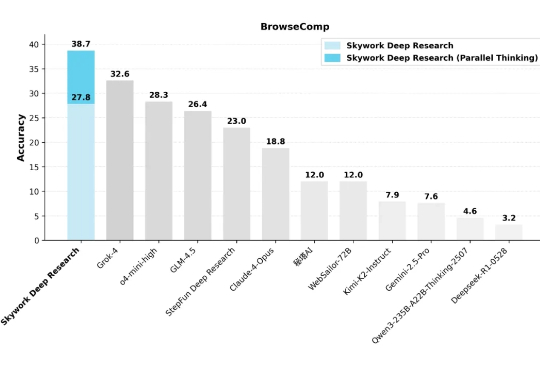
疯狂的七月已经落下了帷幕,如果用一个词来形容国产大模型,「开源」无疑是当之无愧的高频词汇。
在生成式 AI 时代,全球数据总量正以惊人速度增长,据 IDC 预测,2025 年将突破 180ZB,其中 80% 为非结构化内容,传统数据分析在应对多模态信息和打破结构化数据技术壁垒方面尽显乏力,“人工找数 + 手动分析” 的模式严重抑制甚至沉没了数据价值。
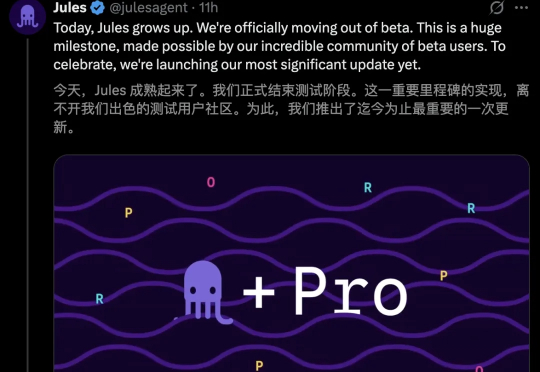
8月6日,谷歌正式发布编程智能体Jules,摘掉了「测试版」标签。Jules具备异步执行能力,依托Gemini2.5Pro模型,可独立修复Bug、更新代码并深度集成GitHub,大幅提升开发效率。