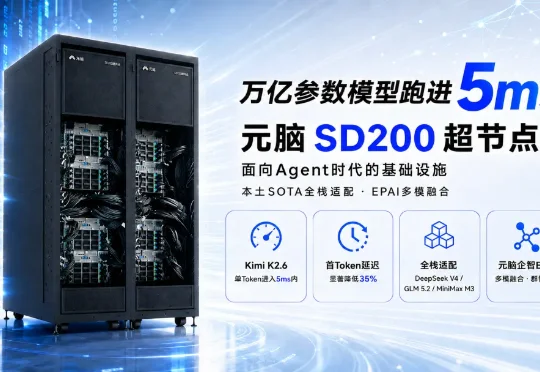
元脑SD200超节点刷新大模型Token速度,万亿参数模型跑进5ms!
元脑SD200超节点刷新大模型Token速度,万亿参数模型跑进5ms!浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
搜索
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
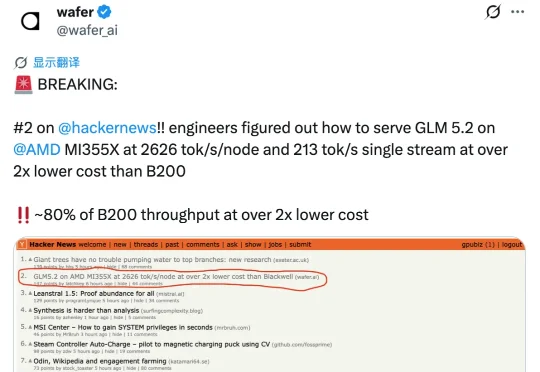
GLM 5.2,用AMD芯片也能跑出来了,而且成本只要英伟达的一半。这是推理优化公司Wafer这周公布的一组数据。Wafer用AMD的MI355X芯片跑最新开源模型GLM 5.2,单节点吞吐做到2626 tok/s,单流吞吐也跑到了213 tok/s。
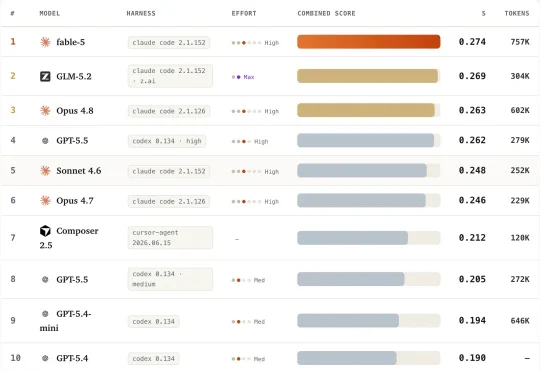
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
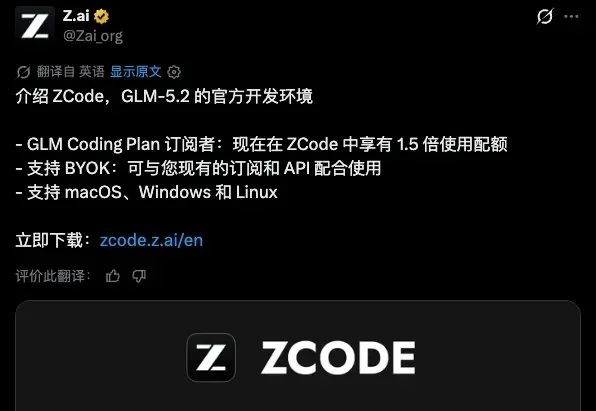
上个月 GLM 5.2 发布的时候,我写过一篇文章,说智谱家出了个叫 ZCode 的编程工具,专门给 GLM 5.2 做开发环境。当时就是简单上手体验了一下,觉得还行,是个正经的 AI 编程产品。
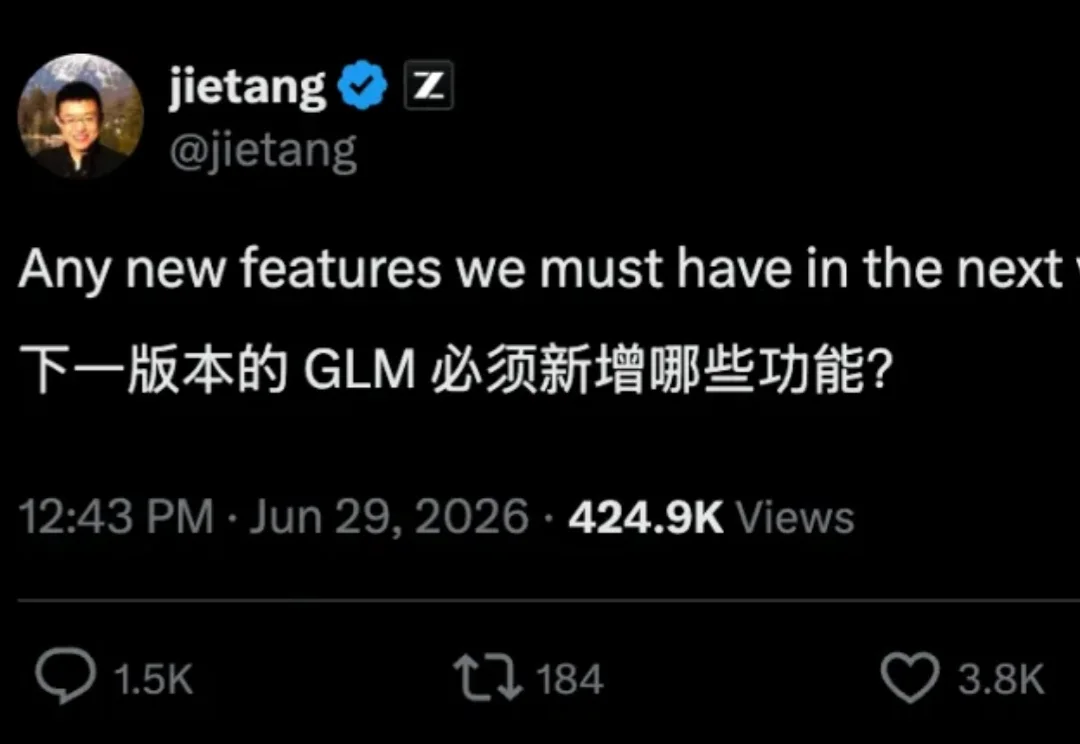
最近,清华教授、智谱灵魂人物唐杰聊得有点high。
这个周末,智谱没闲着。
Anthropic增加绿卡认证后,最开心是智谱,直接原地化身战狼,高呼「前沿智能属于所有人」,提前把专注Coding的GLM5.2发了。
昨夜,全球最大的 AI 开源社区 Hugging Face 官宣了一项前所未有的决定:自掏腰包为智谱 AI 最新开源的旗舰模型 GLM-5.2 提供长达 6 小时的全球免费算力支持。这是 Hugging Face 第一次真金白银为国产模型开这种 “专属 VIP 通道”,海外网友纷纷直呼这波 “倒贴” 好!
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。
大家好,我是袋鼠帝。 如果你家的猫狗真的能说话,它们开口第一句会说什么?