
超越Sora极限,120秒超长AI视频模型诞生!
超越Sora极限,120秒超长AI视频模型诞生!UT奥斯丁等机构提出了一种名为StreamingT2V的技术,让AI视频的长度扩展至近乎无限,而且一致性,动作幅度也非常好!
来自主题: AI资讯
10967 点击 2024-03-26 14:15

 搜索
UT奥斯丁等机构提出了一种名为StreamingT2V的技术,让AI视频的长度扩展至近乎无限,而且一致性,动作幅度也非常好!
最新消息,Stable Diffusion核心研究团队已集体辞职!名单包括研究团队领导、论文一作Robin Rombach,共同一作Andreas Blattmann,以及另一位作者Dominik Lorenz。
本文编译自播客节目a16z。Stability AI的科学家Andreas Blattmann和Robin Rombach与a16z的合伙人Anjney Midha共同探讨从文本到视频人工智能的前沿世界。
大模型对齐新方法,让数学推理能力直接提升9%。
近期,DiT(Diffusion Transformer)论文的作者谢赛宁在朋友圈分享了他对 Sora 的看法,其中核心资源的排序是——人才第一、数据第二、算力第三,其他都没有什么是不可替代的。

单图 3D 说话人视频合成 (One-shot 3D Talking Face Generation) 可以被视作解决这一难题的下一代虚拟人技术。它旨在从单张图片中重建出目标人的三维化身 (3D Avatar)
最近,来自Meta和UC伯克利的研究人员,发布了一种最新的音频到人像模型。操作简单,输出极致逼真。
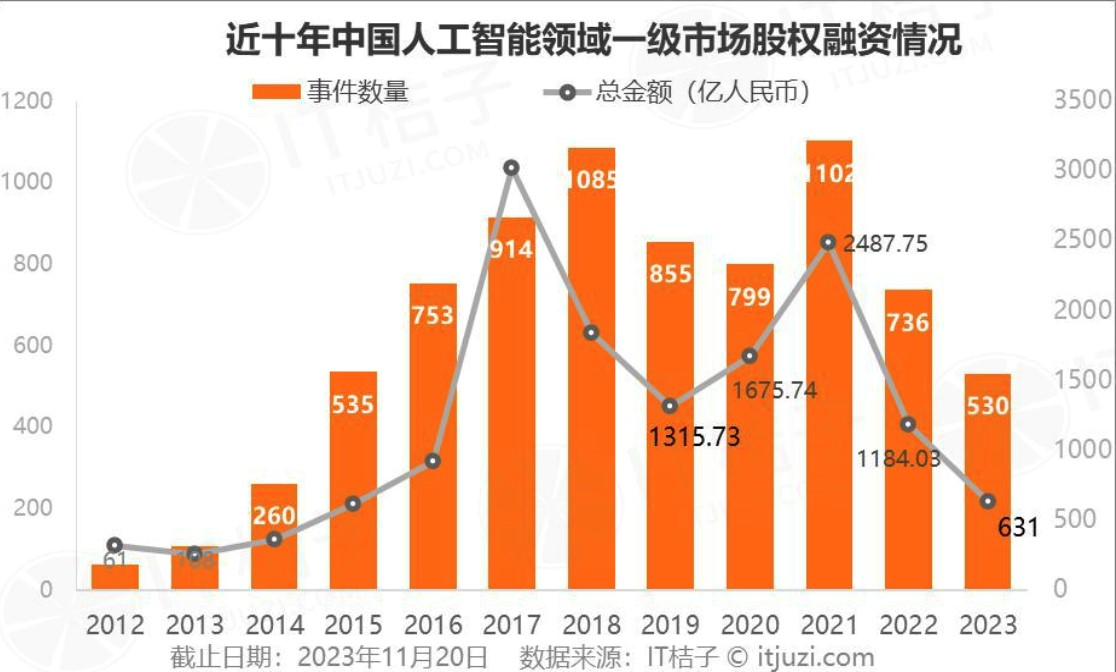
据The information的Creator Economy Database最新数据,在数据库覆盖的350多家全球创业公司中,2023年募得资金量继续螺旋式下降,至约17亿美元,其中人工智能初创企业在融资份额中占比最大,超3.24亿美元。
主题驱动的文本到图像生成,通常需要在多张包含该主题(如人物、风格)的数据集上进行训练,这类方法中的代表工作包括 DreamBooth、Textual Inversion、LoRAs 等,但这类方案因为需要更新整个网络或较长时间的定制化训练,往往无法很有效地兼容社区已有的模型,并无法在真实场景中快速且低成本应用。

1月13日-15日,阿里云和天猫联合举办了一场Create@AI创客松,以「AI电商」为赛题,面向有志于利用AI助力电商经营的创新团队及公司征集优秀方案,深化AI技术在电商场景中的应用。