AI资讯新闻榜单内容搜索-SI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SI
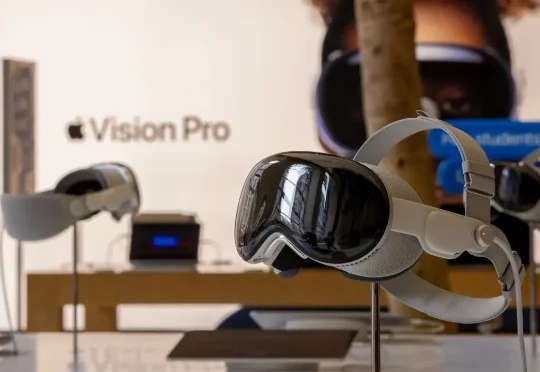
突发!苹果Vision Pro负责人保罗·米德离职,加入OpenAI

突发!苹果Vision Pro负责人保罗·米德离职,加入OpenAI

突发!苹果Vision Pro负责人保罗·米德离职,加入OpenAI

据彭博社记者古尔曼报道,苹果公司负责Vision Pro头显和智能眼镜业务的负责人保罗·米德(Paul Meade)即将离职,转而加入OpenAI。米德在苹果担任视觉产品事业部的硬件工程副总裁。古尔曼称,米德将于下周离开苹果,加入OpenAI的硬件部门,负责OpenAI即将推出的设备系列。

来自主题: AI资讯
8895 点击    2026-06-27 14:15
大模型搜索总偷懒?IQuest等联合推出FORT,30B开源搜索Agent刷新同规模SOTA

大模型搜索总偷懒?IQuest等联合推出FORT,30B开源搜索Agent刷新同规模SOTA

大模型搜索总偷懒?IQuest等联合推出FORT,30B开源搜索Agent刷新同规模SOTA

来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。

来自主题: AI技术研报
9898 点击    2026-06-27 11:27
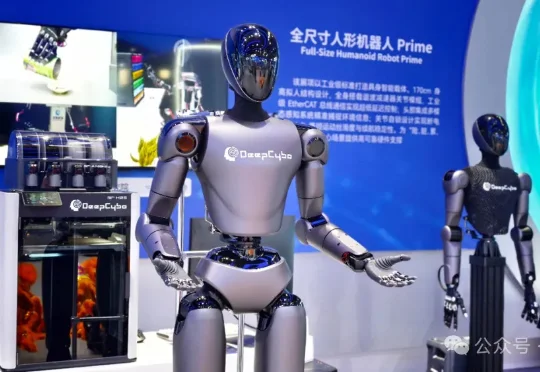
英伟达All in的物理AI路线,居然是中国黑马提前一年就定义好了

英伟达All in的物理AI路线,居然是中国黑马提前一年就定义好了

英伟达All in的物理AI路线,居然是中国黑马提前一年就定义好了

当全球具身智能行业还在争论技术路线时,一家中国公司已经率先定义并跑通了自己的答案。深度机智提出的「人类学习」路线——以人类数据为起点、动作建模为中心、机器人为 AI 而生——正在被英伟达、Physical Intelligence 等海外头部机构沿同一方向跟进。

来自主题: AI资讯
8951 点击    2026-06-27 11:26
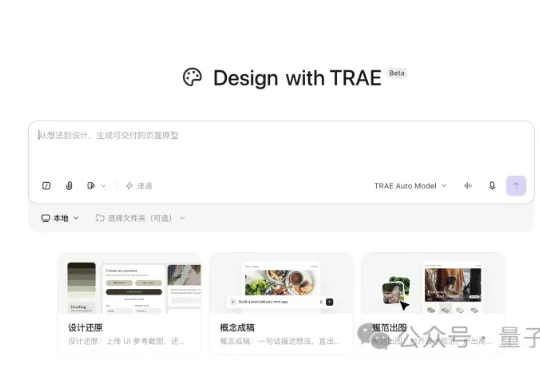
从需求到设计到代码,一个软件全搞定!TRAE Work Design实测来了

从需求到设计到代码,一个软件全搞定!TRAE Work Design实测来了

从需求到设计到代码,一个软件全搞定!TRAE Work Design实测来了

TRAE Work上新了一个Design模式,专门搞设计的。之前TRAE Work已经有Work模式聊需求、Code模式写代码,现在补上了Design——需求→设计→代码,全链路在一个平台里跑通了。

来自主题: AI资讯
11676 点击    2026-06-26 17:10
让机器人学会「预判接触」:它石智航牵头四大顶尖机构发布TacForeSight,破解精细操作难题

让机器人学会「预判接触」:它石智航牵头四大顶尖机构发布TacForeSight,破解精细操作难题

让机器人学会「预判接触」:它石智航牵头四大顶尖机构发布TacForeSight,破解精细操作难题

机器人已经学会看见世界,也开始学会摸到世界。但对于真实接触操作而言,仅仅感知当前状态远远不够,机器人还需要预测物理世界接下来会如何变化。擦拭、插接、拧紧,这些人类几乎凭感觉就能完成的动作,对机器人来说却并非易事:接触力度会变化,物体位置会偏移,反馈慢一步,就可能打滑、卡住或丢失。

来自主题: AI技术研报
8240 点击    2026-06-25 15:24
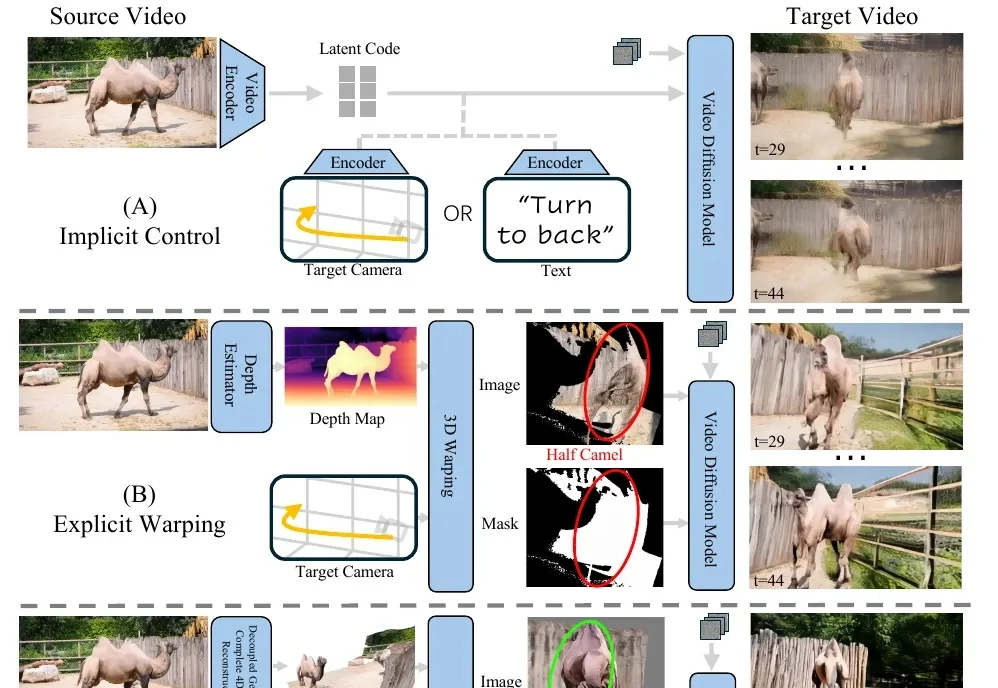
SIGGRAPH 2026 | 无需训练,一段单目视频解锁任意运镜与「子弹时间」

SIGGRAPH 2026 | 无需训练,一段单目视频解锁任意运镜与「子弹时间」

SIGGRAPH 2026 | 无需训练,一段单目视频解锁任意运镜与「子弹时间」

给定一段普通单目视频,FreeOrbit4D 可沿任意指定相机轨迹「重拍」整个动态场景,包括影视级的「子弹时间」环绕镜头。

来自主题: AI技术研报
9391 点击    2026-06-25 15:01
刚刚,OpenAI发布首款AI芯片,九个月完成流片

刚刚,OpenAI发布首款AI芯片,九个月完成流片

刚刚,OpenAI发布首款AI芯片,九个月完成流片

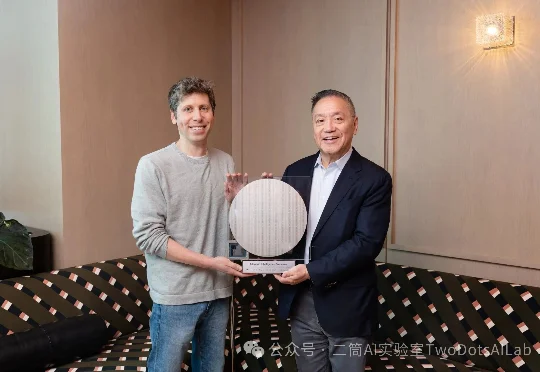
美国当地时间6月24日,OpenAI与博通联合发布了双方合作的首款定制芯片Jalapeño。这是一款专用集成电路(ASIC),专门针对大语言模型的推理任务而设计,也标志着OpenAI正式进军AI芯片领域。

来自主题: AI资讯
11447 点击    2026-06-25 00:11
直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能

直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能

直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能

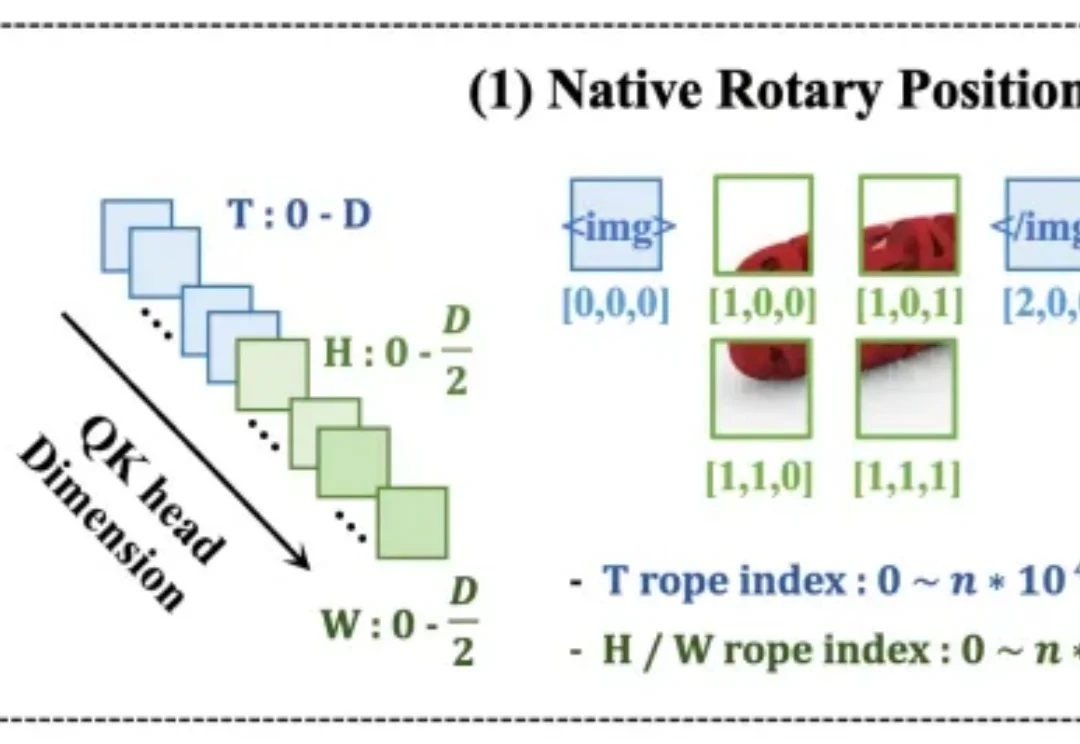
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。

来自主题: AI技术研报
8739 点击    2026-06-24 16:06
斯坦福改变了LLM的生成顺序,Google把它做了出来。DiffusionGemma技术报告来了

斯坦福改变了LLM的生成顺序,Google把它做了出来。DiffusionGemma技术报告来了

斯坦福改变了LLM的生成顺序,Google把它做了出来。DiffusionGemma技术报告来了

Google DeepMind在6月份对外分享了DiffusionGemma的技术报告,明确指向了一条与现有主流完全不同的演进道路。当大家都在绞尽脑汁让大模型逐词吐字的速度变快时,谷歌干脆把生成顺序改了。

来自主题: AI技术研报
8842 点击    2026-06-24 09:54