AlphaGo之父把AI扔进23年的人造社会:智能体3块最硬骨头全在这
AlphaGo之父把AI扔进23年的人造社会:智能体3块最硬骨头全在这从Atari到AlphaGo,从AlphaStar到SIMA,DeepMind用游戏做AI研究已走过十余年,每换一个战场,研究问题就升一个量级。这一次的战场是EVE Online:一个跑了23年、从未重置的活宇宙。
来自主题: AI资讯
13697 点击 2026-05-23 13:48

 搜索
从Atari到AlphaGo,从AlphaStar到SIMA,DeepMind用游戏做AI研究已走过十余年,每换一个战场,研究问题就升一个量级。这一次的战场是EVE Online:一个跑了23年、从未重置的活宇宙。
Jim Fan 押注的这条 “先预测世界,再生成动作” 的新路,正是当下具身智能领域最炙手可热的下一代范式 —— 世界动作模型(World Action Models,简称 WAM)。虽然 WAM 正在迅速成为各大顶尖实验室的核心发力点,但业界至今仍然缺乏对它的统一标准和系统梳理。近期,复旦大学可信具身智能研究院,上海创智学院,新加坡国立大学发表了首篇 WAM 的详细综述。
李飞飞团队最新发布ESI-Bench——一个专门用来评测具身空间智能的新基准。过去的空间智能评测默认给模型最优观测,而ESI-Bench第一个把观察者变成行动者,闭合了感知-行动回路。
很多人知道,苹果 Vision pro 是 VR 眼镜的市场标杆产品,Meta和Google都曾大举进军AI眼镜,但鲜有人知的是,2025年冲到北美第一的 XR 眼镜,是一家很低调的公司——VITURE。
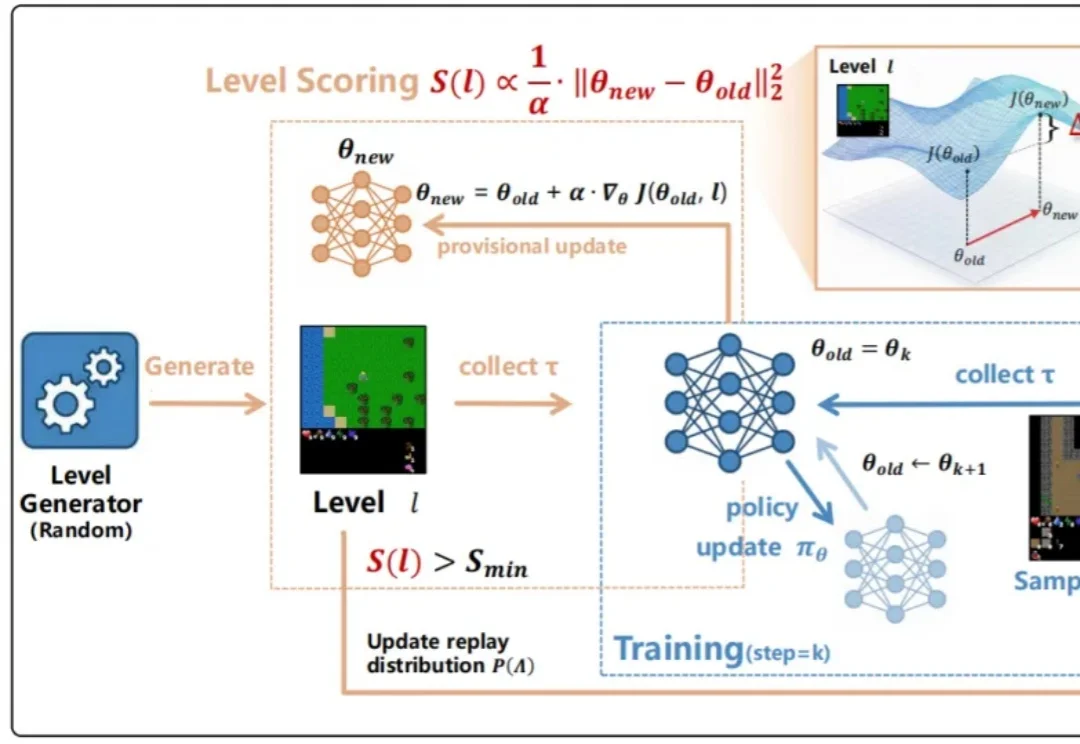
训练强化学习智能体时,一个常见问题是:有些 level 太简单,智能体跑几遍就会;有些 level 又太难,智能体几乎得不到有效反馈。前者只是在重复已有能力,后者则会把训练预算消耗在无效探索上。真正有价值的训练环境,往往位于二者之间。
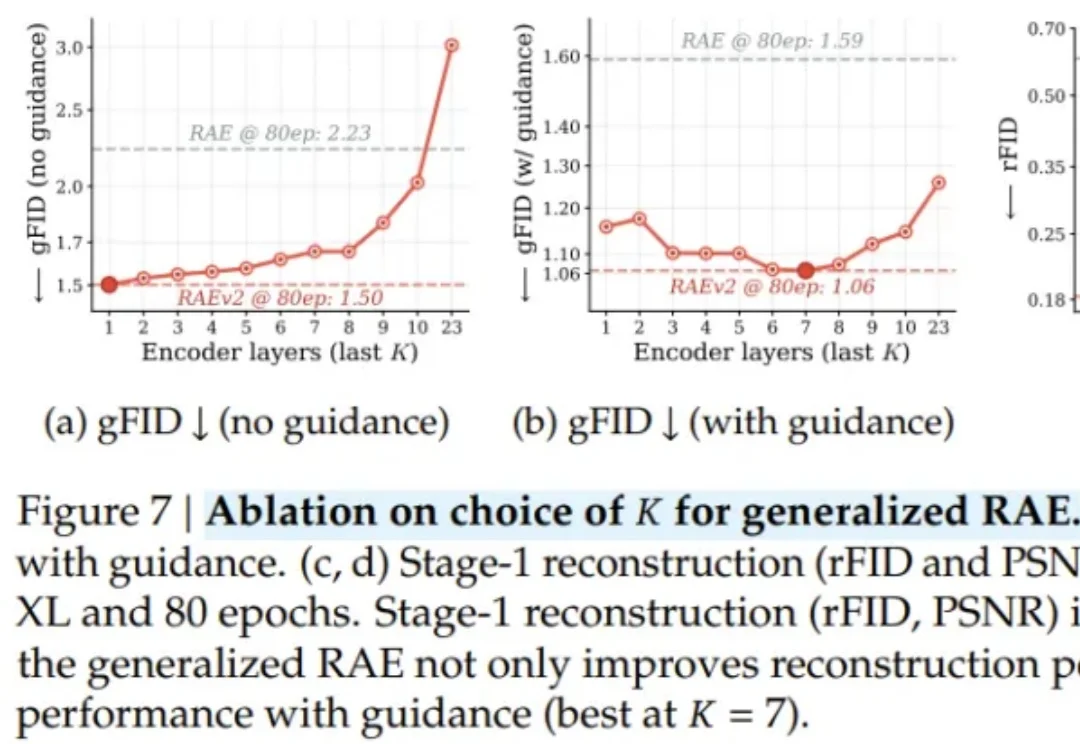
AI 图像生成通常遵循「能力越强、代价越高」的铁律;与此同时,学界却在悄悄质疑另一个更根本的浪费:传统 VAE 对图像语义几乎一无所知,而 DINOv2、SigLIP 等视觉编码器早已从数亿张图片中习得了丰富的视觉常识。图像生成模型,真的需要从零开始「发明」对图像的理解吗?
大家好,我是袋鼠帝 作为一名后端程序员,我略懂前端,但是对于UI设计是一窍不通。
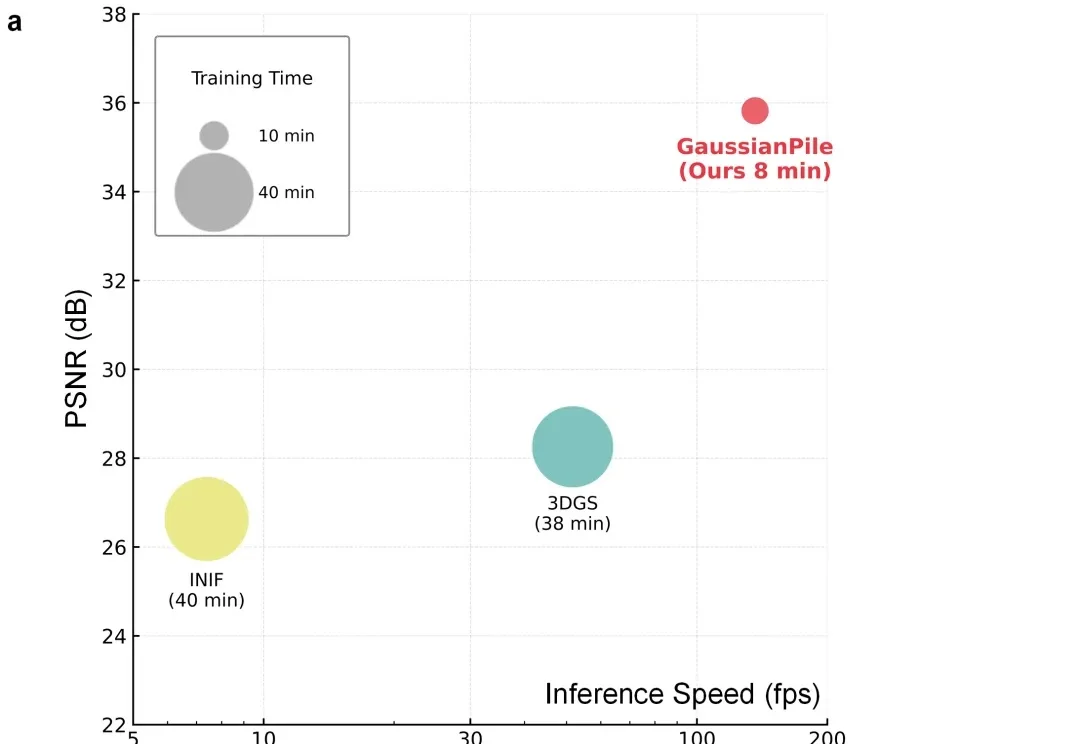
近年来,3D Gaussian Splatting(3DGS)在三维视觉和图形学中展现出很强的表示与渲染能力。相比传统体素或神经辐射场,它用一组可优化的各向异性高斯来表示三维场景,既能保留连续空间结构,又能实现高速渲染。
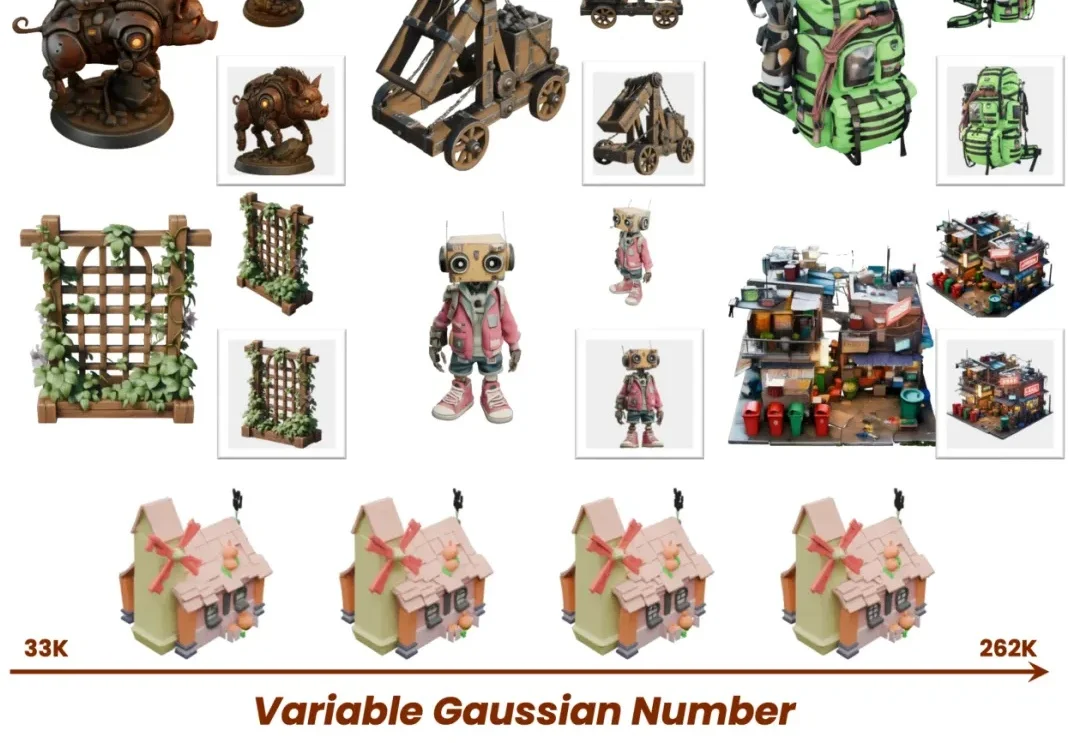
如果把现在最热门的几条 3D 生成技术线放在一起看,你会发现它们正在遇到一个很像的问题。
就在刚刚,智谱率先在 GLM-5.1 线上生产集群中完成了新一代组网架构 ZCube 的规模化落地。ZCube 发表于网络领域顶会ACM SIGCOMM 2025,被评价为「significantly change the way we think about and understand networking/显著改变整个行业对网络认知方式」。