内存直降50%,token需求少56%!用视觉方式处理长文本
内存直降50%,token需求少56%!用视觉方式处理长文本在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
搜索
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
Sora背后的核心贡献者之一,这位00后的天才辍学生Will Depue,准备再次搞个大事情。刚刚,他宣布下一个目标是,超级人工智能ASI!在结束一段长期休息后,Will Depue宣布他再次回到OpenAI。
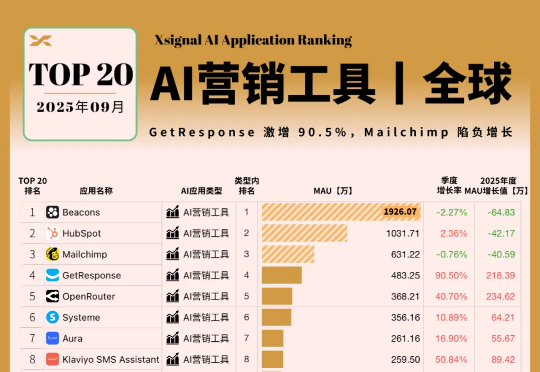
Xsignal AI Holo(AI全息)数据库的1-9月数据显示,市场(MAU)已自发掀起了一场“效率革命”的上半场:营销人员用脚投票,从Mailchimp等“旧势力”涌向GetResponse和“万相营造”等“效率新势力”。这证明了市场对“单点工具”效率提升的极度渴求。
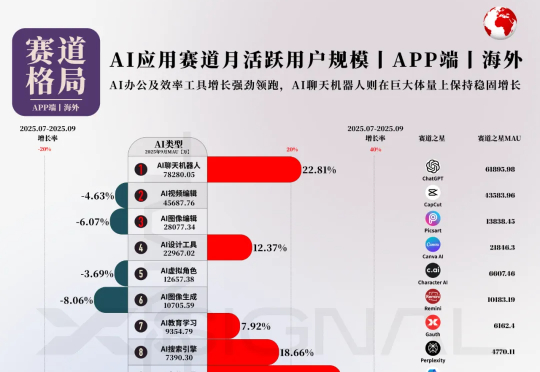
本次,X博士继续应用Xsignal数据交互平台的AI Holo(AI 全息)数据库数据,为你提供海外AI应用市场2025年9月的最新发展动态,发布2025年9月海外“赛道格局”、“赛道之王”、“TOP 50 AI应用”和“增长之星”四大数据榜单及深度洞察。
在多模态生成领域,由视频生成音频(Video-to-Audio,V2A)的任务要求模型理解视频语义,还要在时间维度上精准对齐声音与动态。早期的 V2A 方法采用自回归(Auto-Regressive)的方式将视频特征作为前缀来逐个生成音频 token,或者以掩码预测(Mask-Prediction)的方式并行地预测音频 token,逐步生成完整音频。
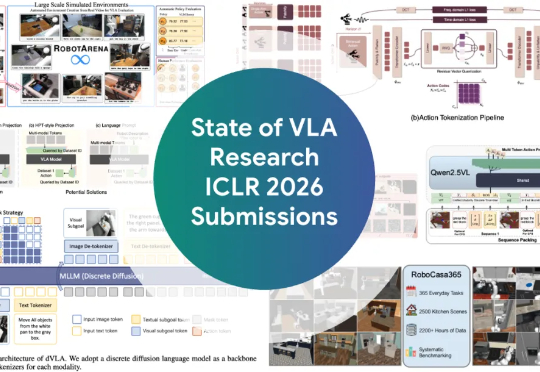
ICLR 2026爆火领域VLA(Vision-Language-Action,视觉-语言-动作)全面综述来了! 如果你还不了解VLA是什么,以及这个让机器人学者集体兴奋的领域进展如何,看这一篇就够了。
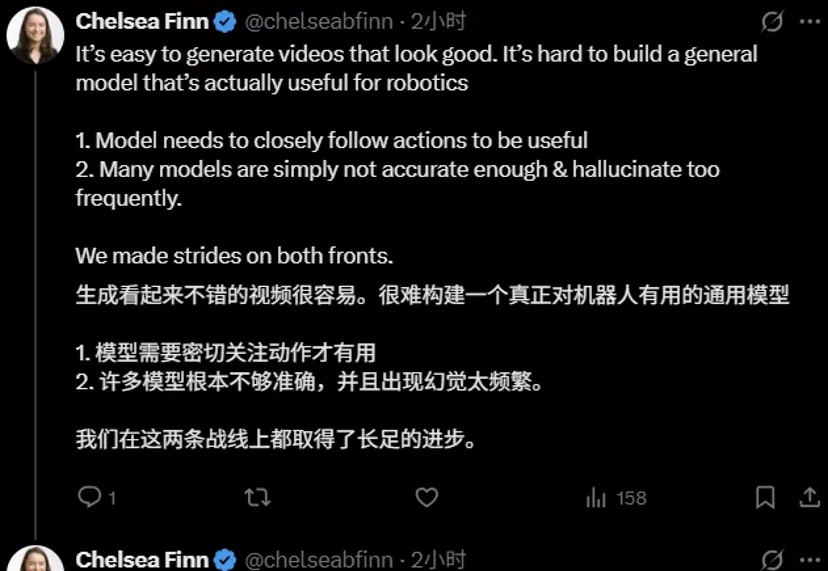
这两天,Physical Intelligence(PI)联合创始人Chelsea Finn在𝕏上,对斯坦福课题组一项最新世界模型工作kuakua连续点赞。
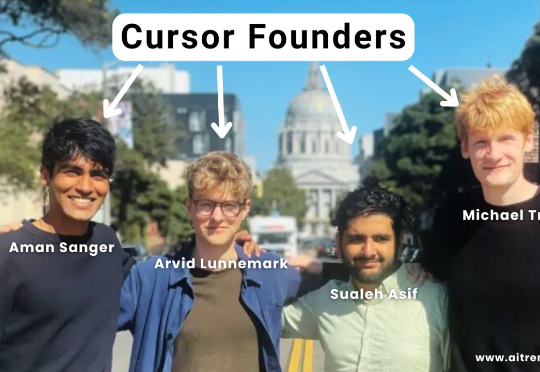
美国当地时间 10 月 29 日,据外媒消息,AI 编码工具 Cursor 背后的公司 Anysphere 的联合创始人 Arvid Lunnemark 已离职。Cursor 最初由四位联合创始人创立,除了 Lunnemark 之外,还有 Aman Sanger、Michael Truell 和 Sualeh Asif。
近年来,基于扩散模型的图像生成技术发展迅猛,催生了Stable Diffusion、Midjourney等一系列强大的文生图应用。然而,当前主流的训练范式普遍依赖一个核心组件——变分自编码器(VAE),这也带来了长久以来困扰研究者们的几个问题:
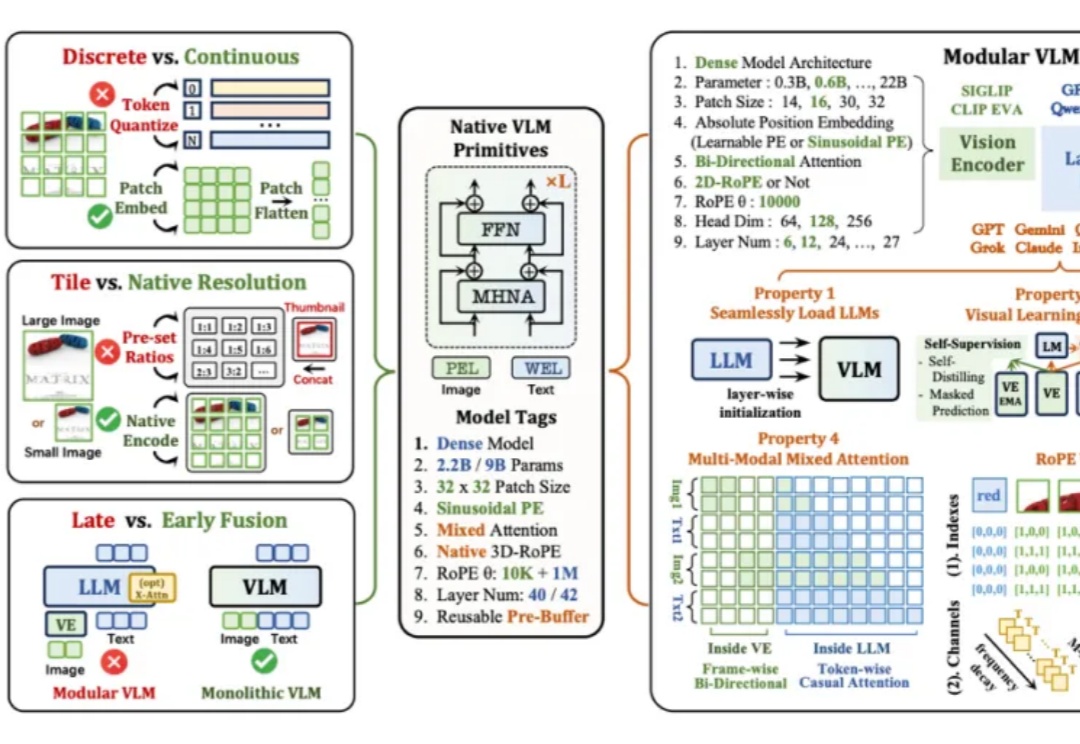
当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。