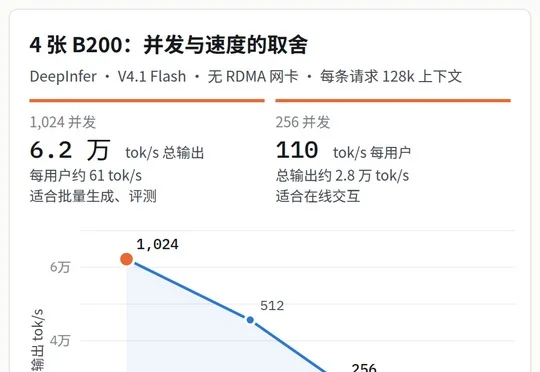
DeepInfer 实测:如何用 4 张 B200 提供 1000 并发
DeepInfer 实测:如何用 4 张 B200 提供 1000 并发DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
来自主题: AI资讯
9556 点击 2026-10-23 10:21

 搜索
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
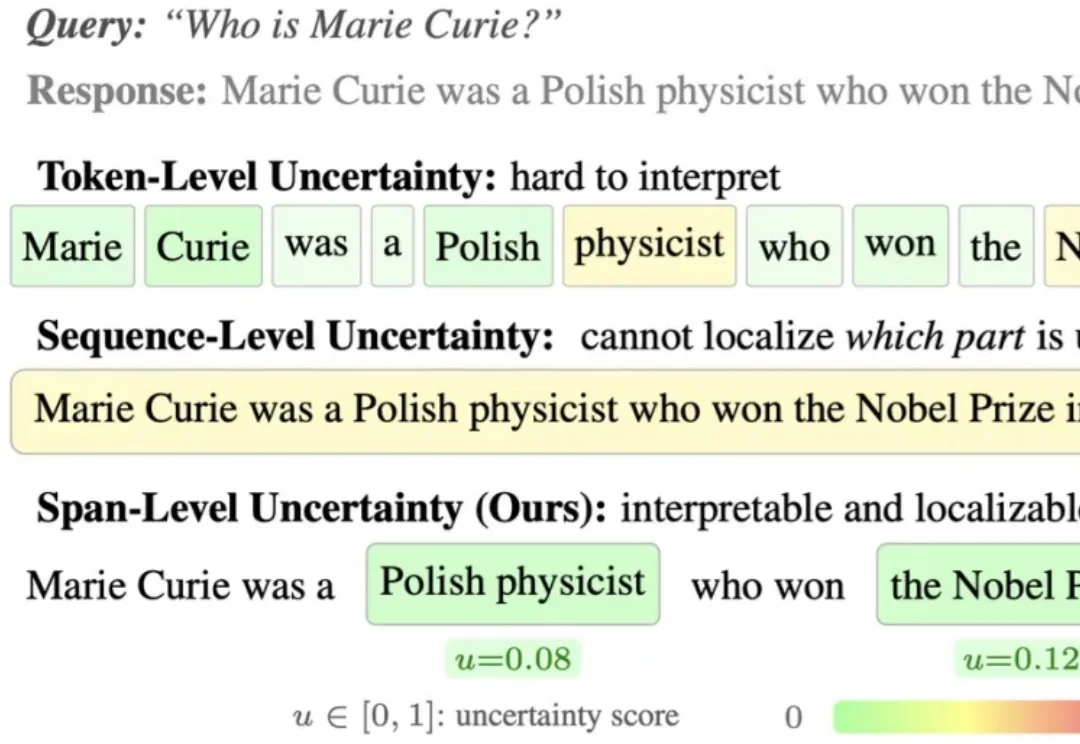
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
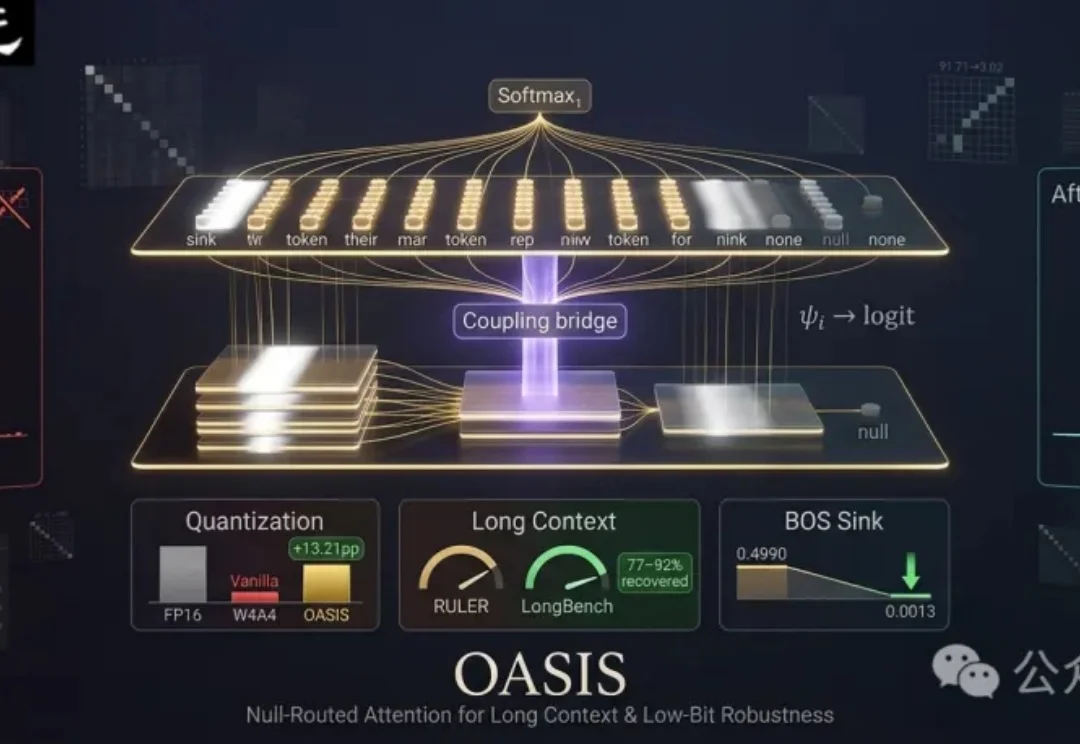
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
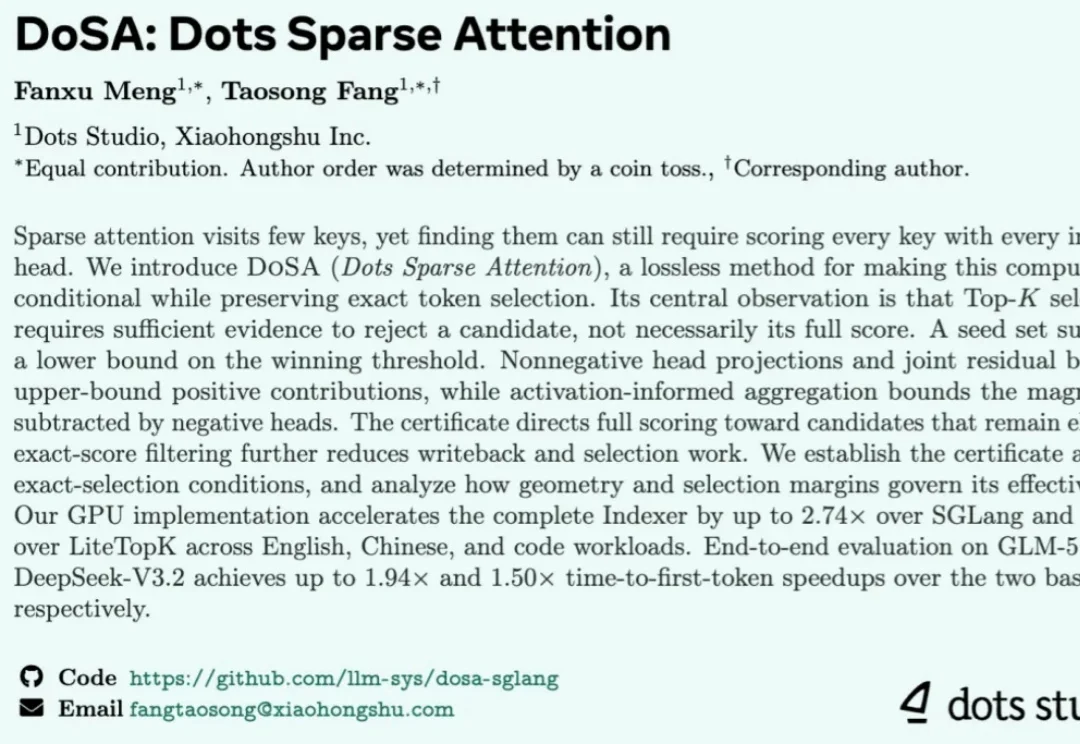
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
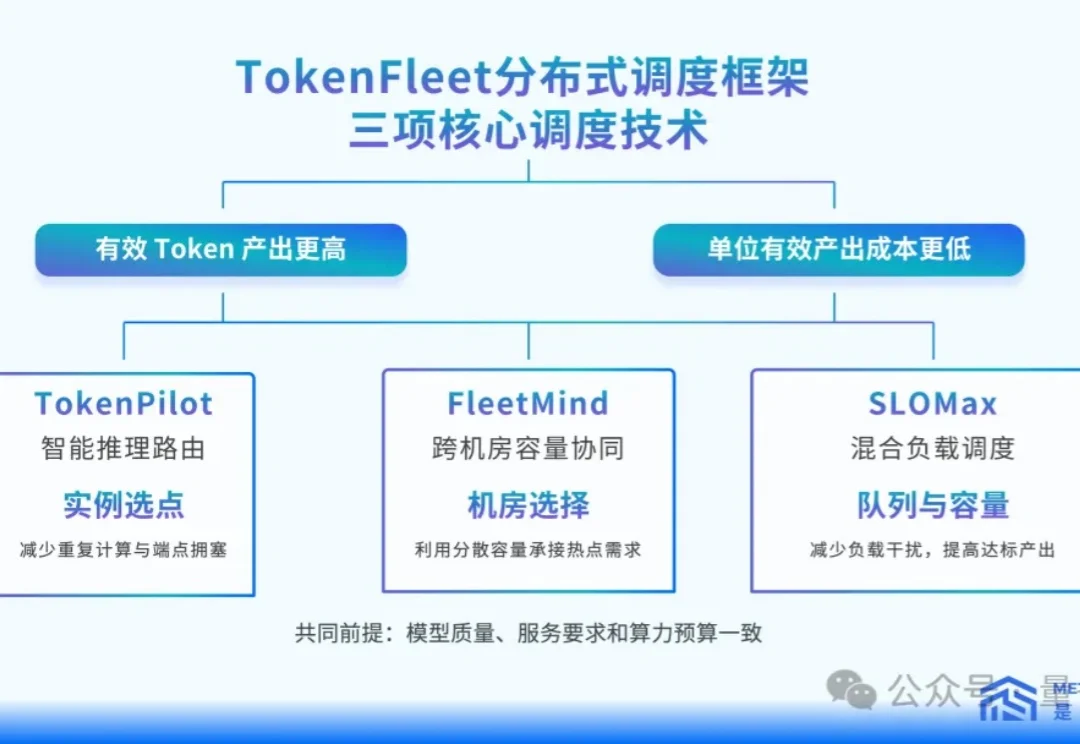
GPU集群里,请求排队和资源闲置,可能同时发生。
MiniMax 更新 MiniMax M3.1 Flash,并确认此前处理超200万亿 Token 的匿名模型 Space Bunny 为其早期版本;官方称新模型线上推理速度提升近3倍,Agent 类任务综合使用成本较前代降低70%。
宏诺伊曼由前谷歌工程师周银汉与DeepSeek研究员Bill Liu于2025年11月创立,旗下AnyInt以智能路由连接模型、智能体和工具,并在质量、价格与速度等约束下为企业匹配AI服务组合,2026年3月30日获百度战略投资。
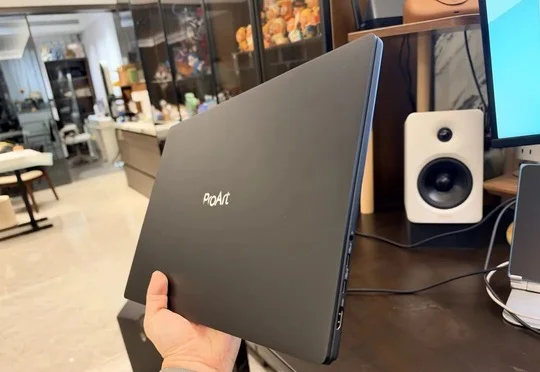
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。