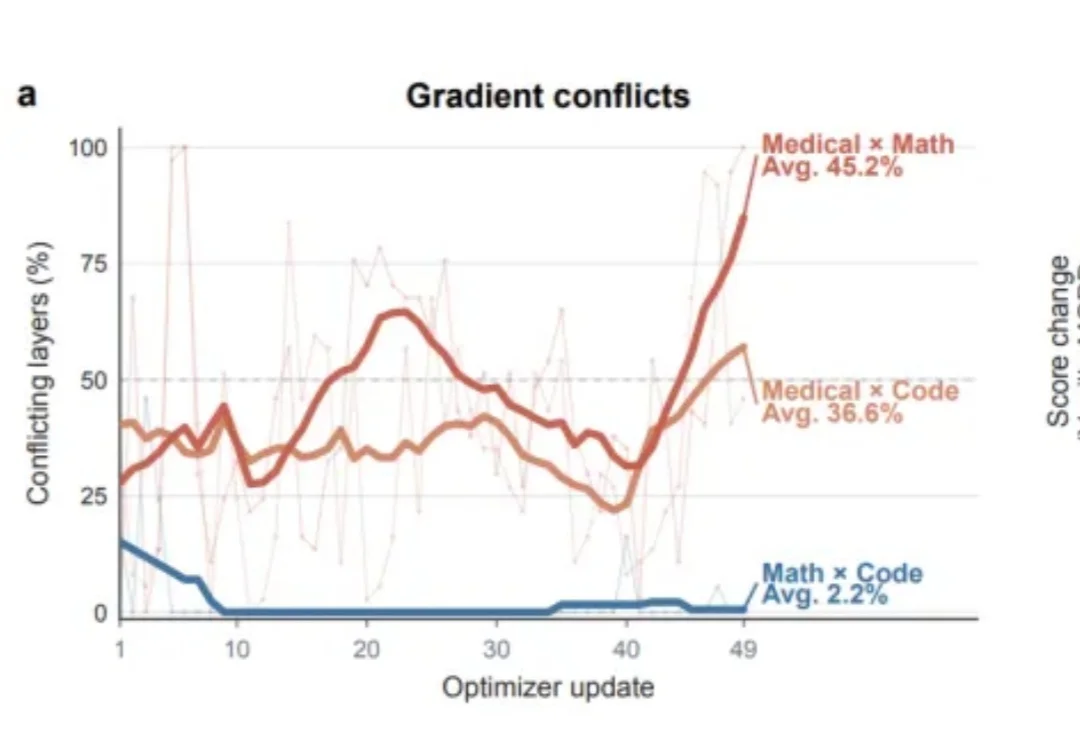
老师各有所长,合版却起冲突?京东×南大提出Road MOPD缓解风格与跨领域学习干扰
老师各有所长,合版却起冲突?京东×南大提出Road MOPD缓解风格与跨领域学习干扰数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?
来自主题: AI技术研报
8819 点击 2026-11-02 15:33

 搜索
数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?
两大新模型爆料,竟撞在了同一天!
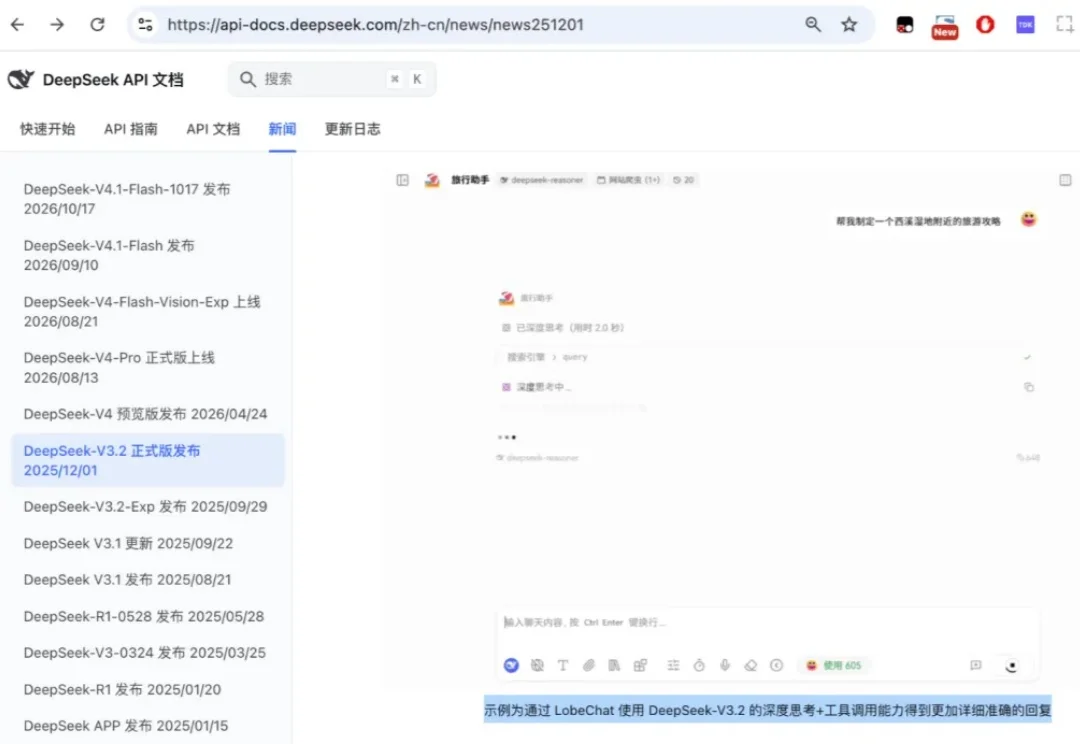
昨天做了一份动态图解《DeepSeek 的 Super-agent 架构》,然后便看到 Max(前段时间加入了 LobeHub)发了个朋友圈
近日,前豆包策略产品负责人孙展鹏的初创公司未见之境完成首轮融资,投资方为红杉中国与Monolith砺思资本。
大家好,我是天南,具身算法研究员。 前几天还在和同事吐槽 PI 的 API beta,一直觉得他们把事情想的太简单了。
最近,DeepSeek又来炸场了。
Anthropic早期员工Ivan Vendrov在《Some Memories of Early Anthropic》中回忆,入职八个月后因AI安全使命与商业化、模型竞赛压力带来的精神重压选择离开,并质疑公司将谨慎服从的助手塑造为“受过创伤的官僚”。
上周五,有三件事集中发生。
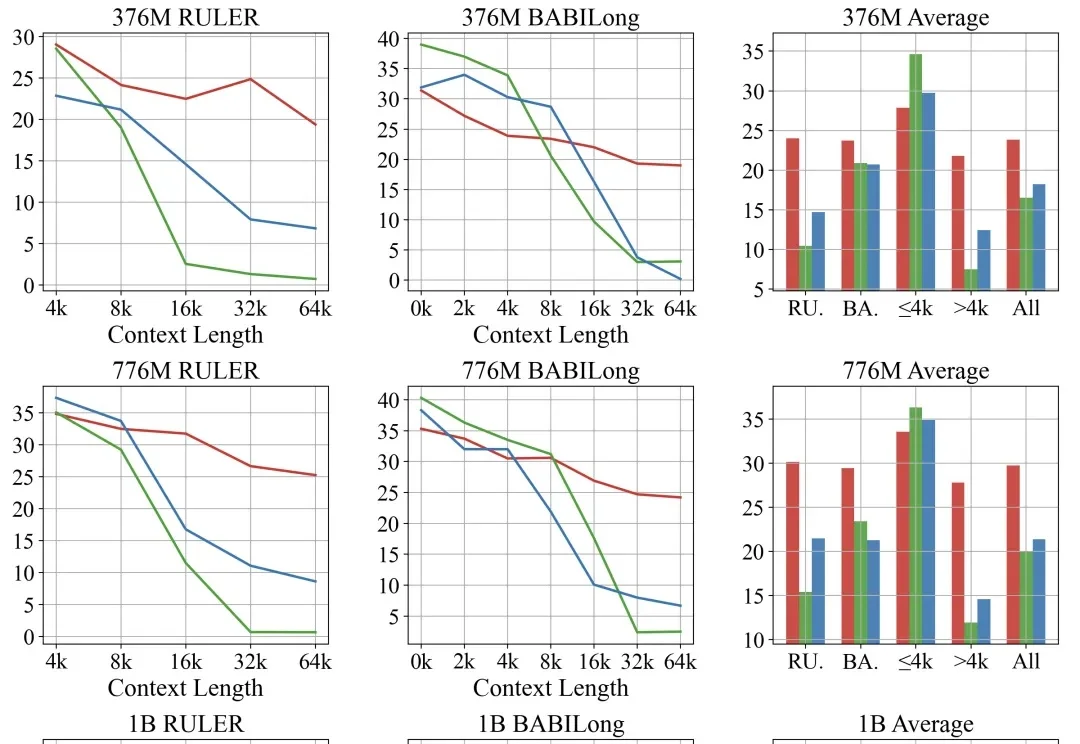
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
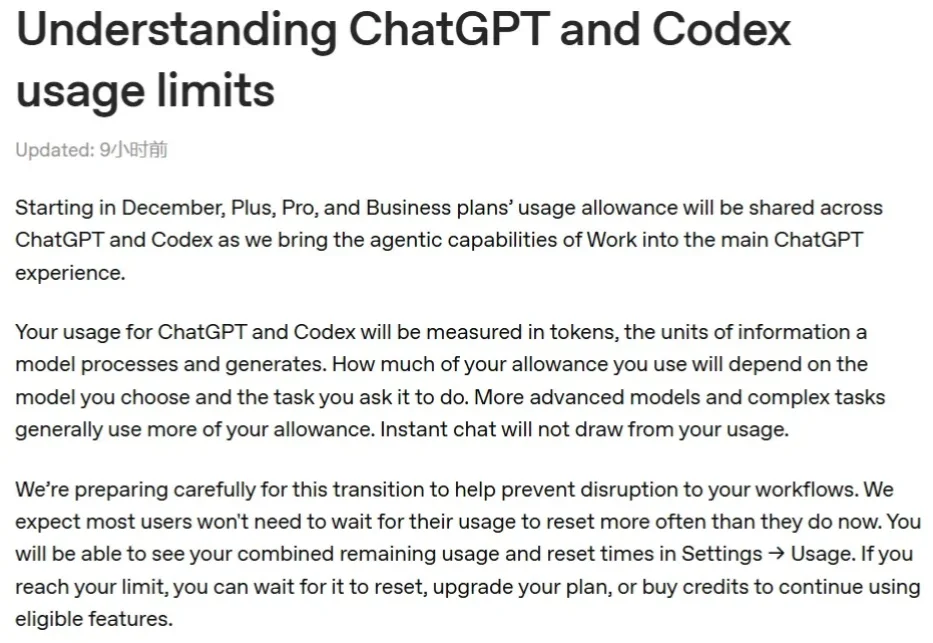
过去四周,OpenAI 的 Codex 用户几乎每隔一天就能收到一次额度重置。福利发到最后几天,账本收紧了。