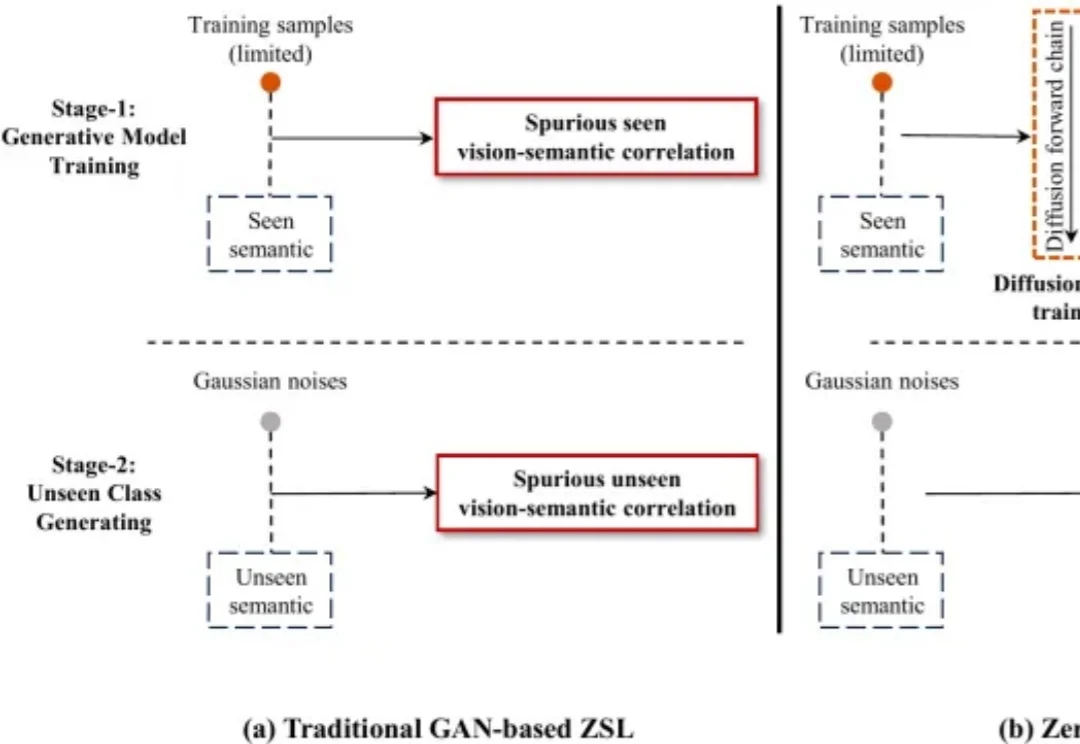
零样本刷新三项基准:ZeroDiff++让AI边考试边学习 | TPAMI'26
零样本刷新三项基准:ZeroDiff++让AI边考试边学习 | TPAMI'26零样本学习的目标,是让模型识别训练时从未出现过的类别。
来自主题: AI技术研报
7937 点击 2026-09-16 10:35

 搜索
零样本学习的目标,是让模型识别训练时从未出现过的类别。
作者三文盐体验良配等AI Dating产品后指出,AI Dating已演变为衡水中学式做题相亲,AI军师与提效机制无法解决情感茫然与真实人际连接的本质。
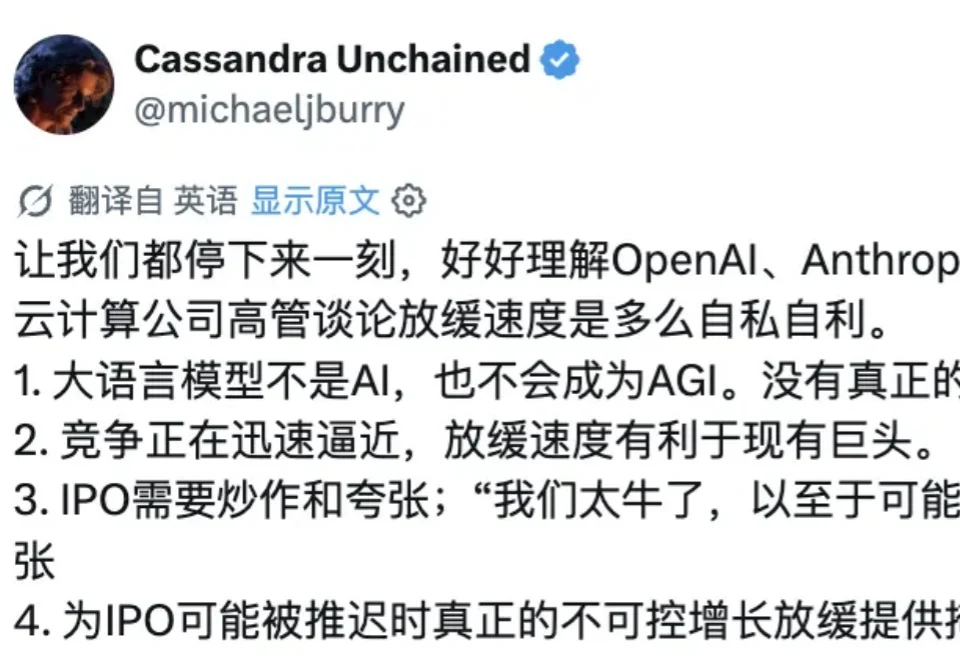
忍!不!了!了! 你老A社天天一会儿AI要失控、一会儿互联网要完蛋,转头自己IPO、融资、扩算力,一个都没耽误??
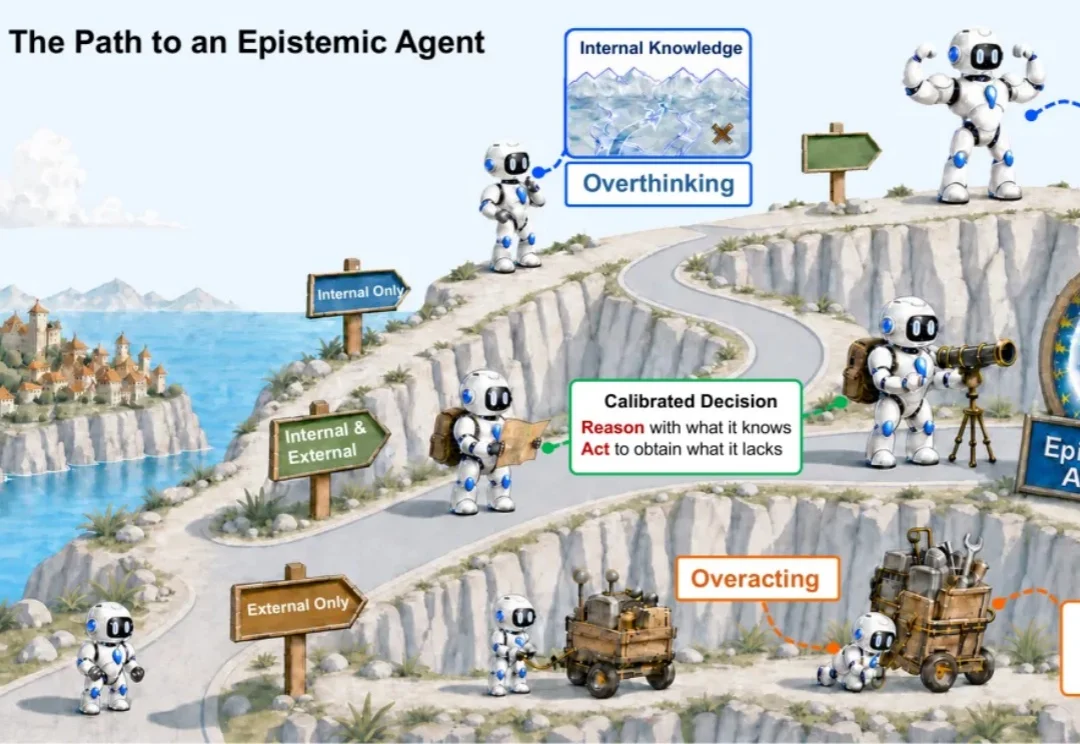
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
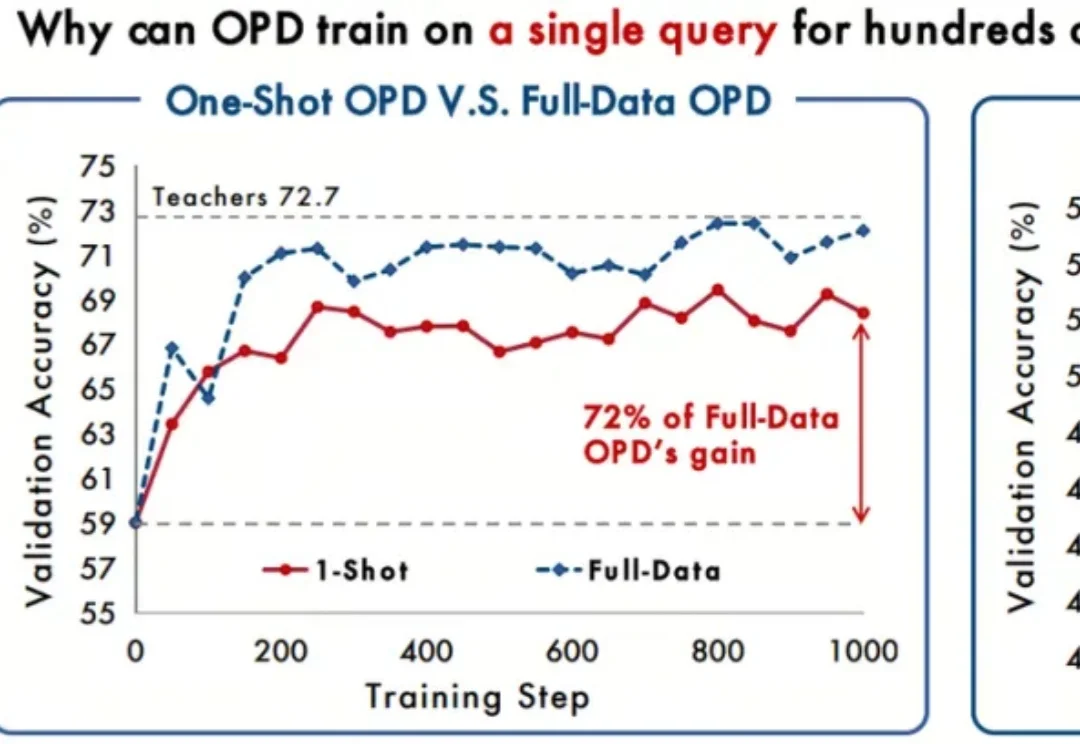
把 On-Policy Distillation(在线策略蒸馏,OPD)的训练集从 17000 道题删到 1 道,会发生什么?
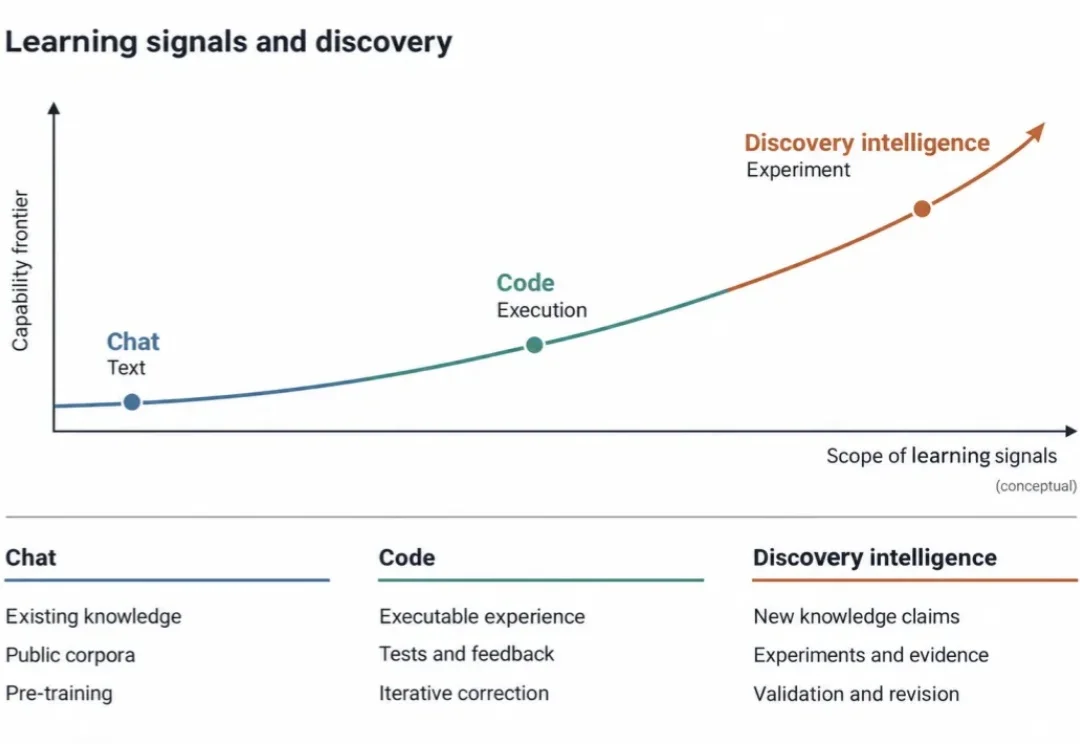
成立才一个多月,估值就要冲到 500 亿美元。
小宇宙想要「强而久」。
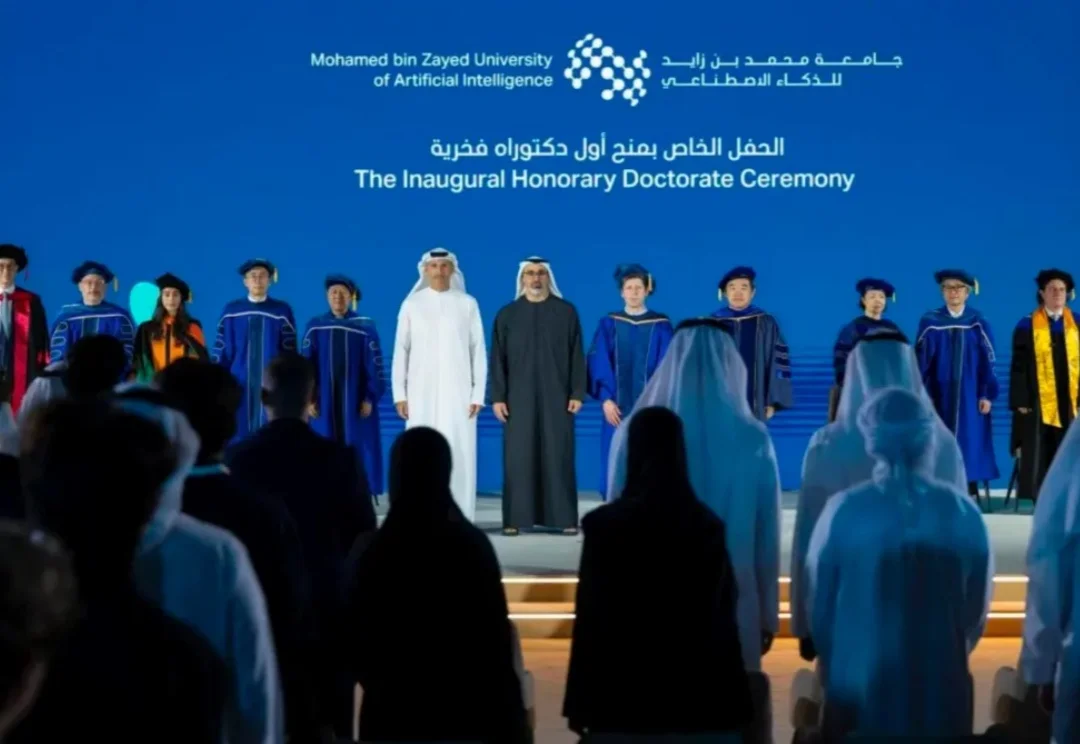
“在 MBZUAI 读研,是世界上最好的工作。”
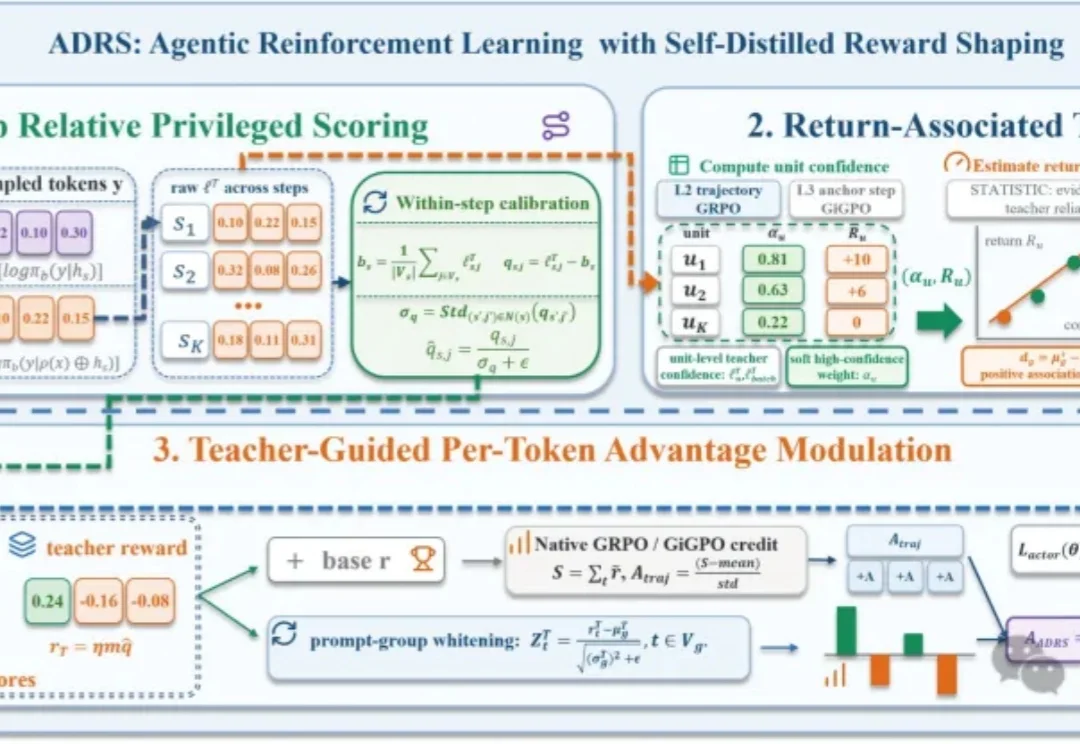
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。
最强的 AI 模型,正在遭遇一批最有钱的大客户设限。