让Skill“有图可依”:openJiuwen首发多模态Skill范式Skill-Omni
让Skill“有图可依”:openJiuwen首发多模态Skill范式Skill-Omni针对这一问题,openJiuwen社区正式发布Skill-Omni——业界最早工程化落地的多模态Skill范式。 它让Agent的经验从“读得懂”升级为“看得见”,把网页和视频中的视觉知识,沉淀为Agent可复用的多模态Skill。
搜索
针对这一问题,openJiuwen社区正式发布Skill-Omni——业界最早工程化落地的多模态Skill范式。 它让Agent的经验从“读得懂”升级为“看得见”,把网页和视频中的视觉知识,沉淀为Agent可复用的多模态Skill。
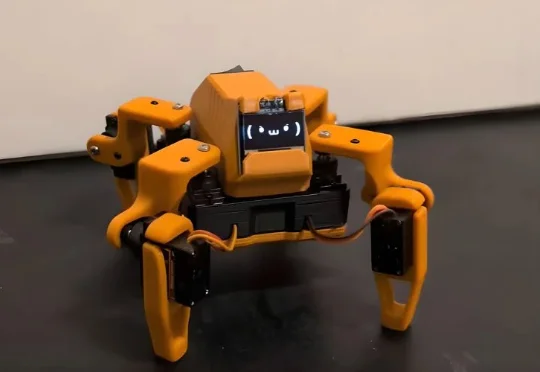
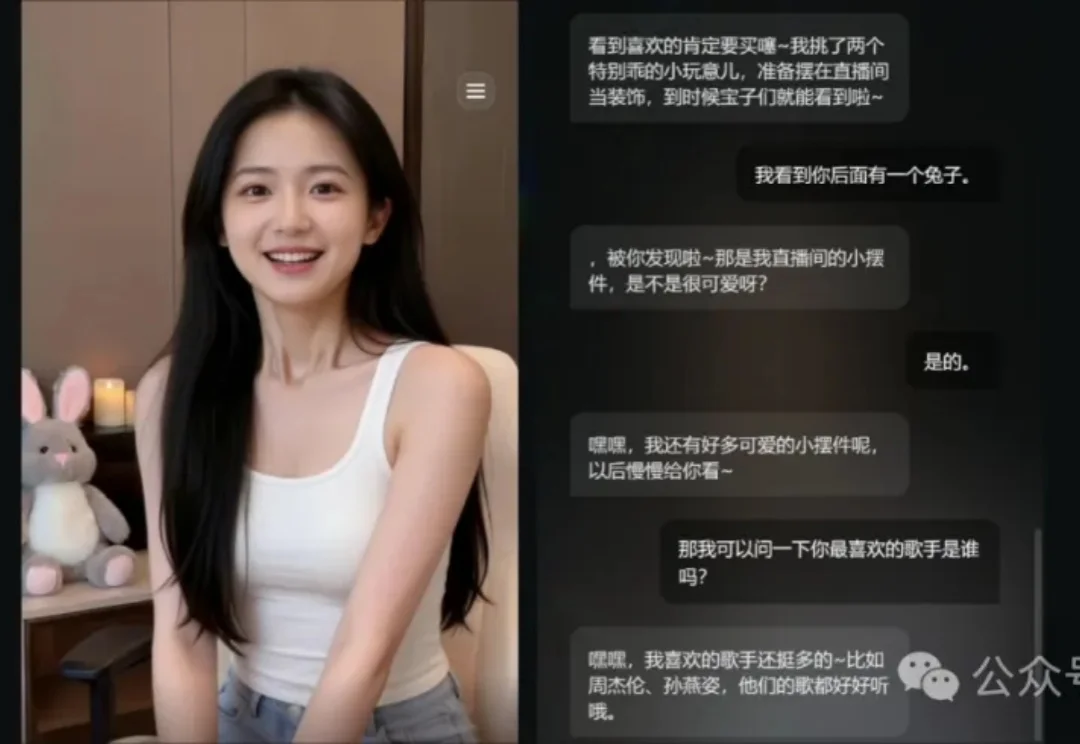
乐鑫喵伴 EchoEar EchoEar 喵伴 AI 机器人搭载的 ESP-Brookesia 框架实现全双工语音交互、多模态识别与智能体控制,构建更具沉浸感的人机交互体验。 EchoEar 套件以端
如果是小白第一次上手,我会更建议从 Kimi 开始。Kimi 的中文理解、长文本处理、Coding、多模态综合能力都很强,是最适合 Codex 的国产模型。今天这篇内容,手把手教大家如何将第三方大模型接入 Codex 搞定日常任务。
来自上海交大、马来亚大学、CMU、MBZUAI、KIT和KAUST的团队提出VisNec(Visual Necessity Score,视觉必要性分数),用一个分数衡量每条训练样本里“图像到底起了多大作用”,被ECCV 2026收录。
虽然Coding还是一坨,但谷歌搞「多模态」确实有两把刷子。
打脸了,家人们!!
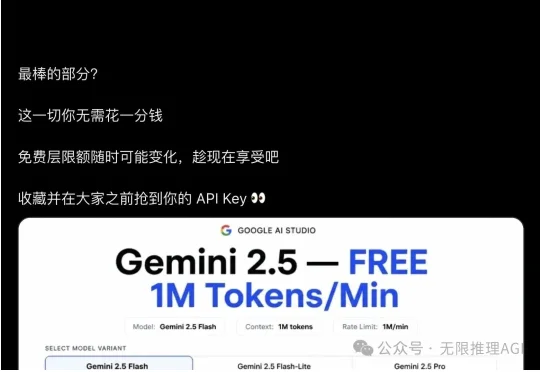
0 美元你能得到什么——Gemini 2.5 Flash 和 Pro 均可用,每分钟 1M tokens,原生支持文本、图像、音频、视频多模态输入 ,几秒钟生成 API Key,即开即用
2026 年 6 月,大模型行业正在经历一场前所未有的「开源海啸」:英伟达放出了 550B 参数的混合架构模型,谷歌送出多模态的 Gemma 新版本,智谱用最宽松的协议全量开源了自家旗舰模型。
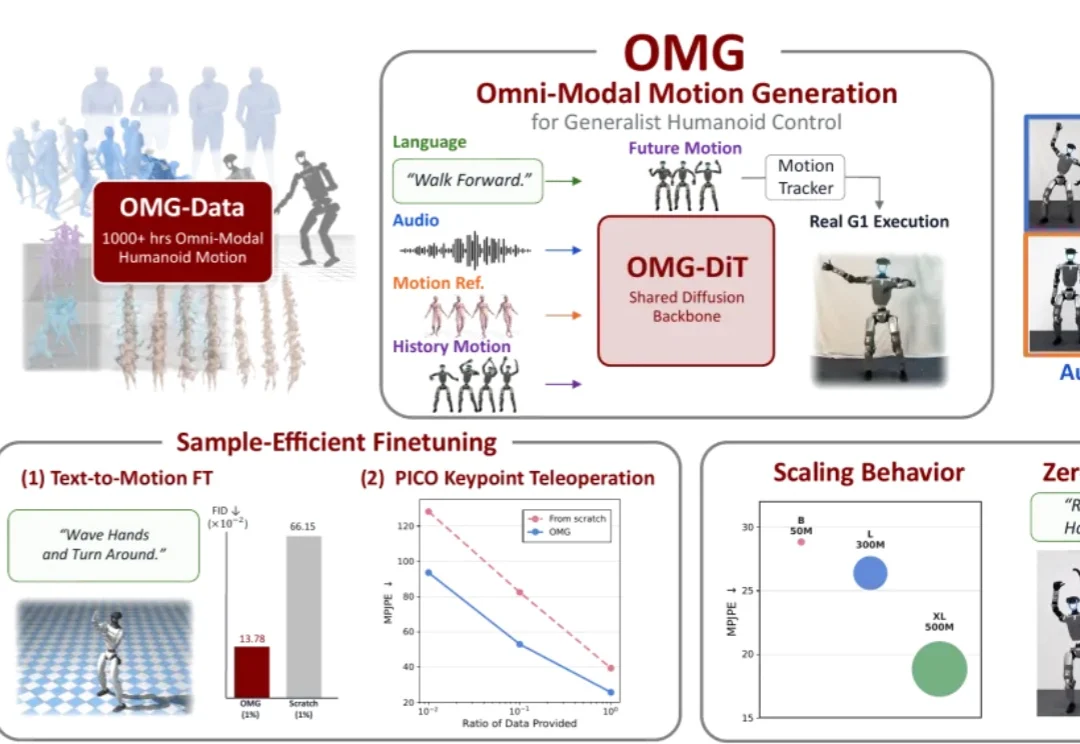
现阶段大多数人形机器人的运动控制还局限于 “有参考才能动” 的被动跟踪模式。
豆包产品无敌,但Seed模型一直不温不火,大伙对它的印象就两个: 工资高,隔三差五就有千万年包上亿年包新闻,也不知道真假;多模态,但编程能力不太行。