他亲手造出o1和o3,却突然宣布:人类可以永远退休了!
他亲手造出o1和o3,却突然宣布:人类可以永远退休了!这是前OpenAI推理模型一号位Jerry Tworek抛出的最新暴论。他2019年进的OpenAI,一待就是七年。当年强化学习死活scale不动,是他死死咬住不放硬推上去的,o1和o3这两代大杀器都是他亲自带队砸出来的。
来自主题: AI资讯
8791 点击 2026-08-27 09:34

 搜索
这是前OpenAI推理模型一号位Jerry Tworek抛出的最新暴论。他2019年进的OpenAI,一待就是七年。当年强化学习死活scale不动,是他死死咬住不放硬推上去的,o1和o3这两代大杀器都是他亲自带队砸出来的。
近期,字节跳动大模型核心部门Seed完成新一轮组织调整,调整核心集中在Seed Foundation Model(Seed基础模型)板块,新设四个一级部门,重构了预训练数据、强化学习与后训练的组织链路。

史无前例,OpenAI真的停手了!刚刚,奥特曼亲自官宣,「OpenAI暂停下一代旗舰模型的强化学习训练,为期两周」。官方给出停更的原因是:要确保安全、对齐和监控标准,能跟得上眼前这个全新的能力水平。
曾经最相信强化学习的人之一,如今却认为:强化学习没有把我们带到 AGI。
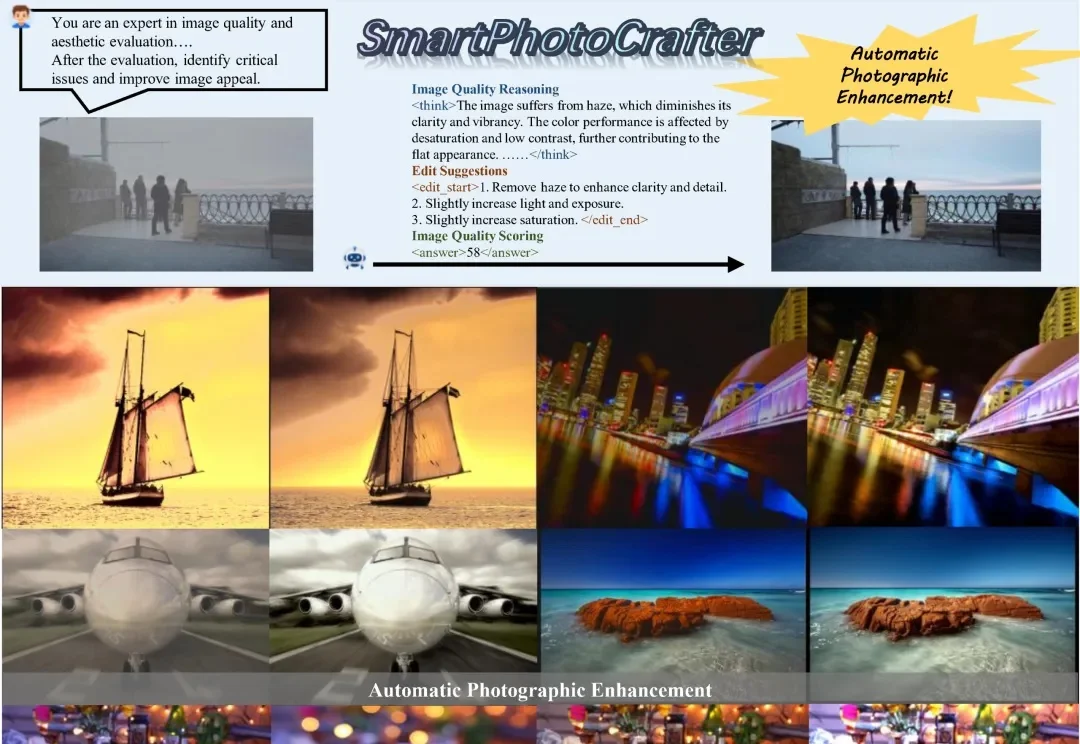
在日常摄影中,后期处理往往是决定照片最终观感的重要一步。
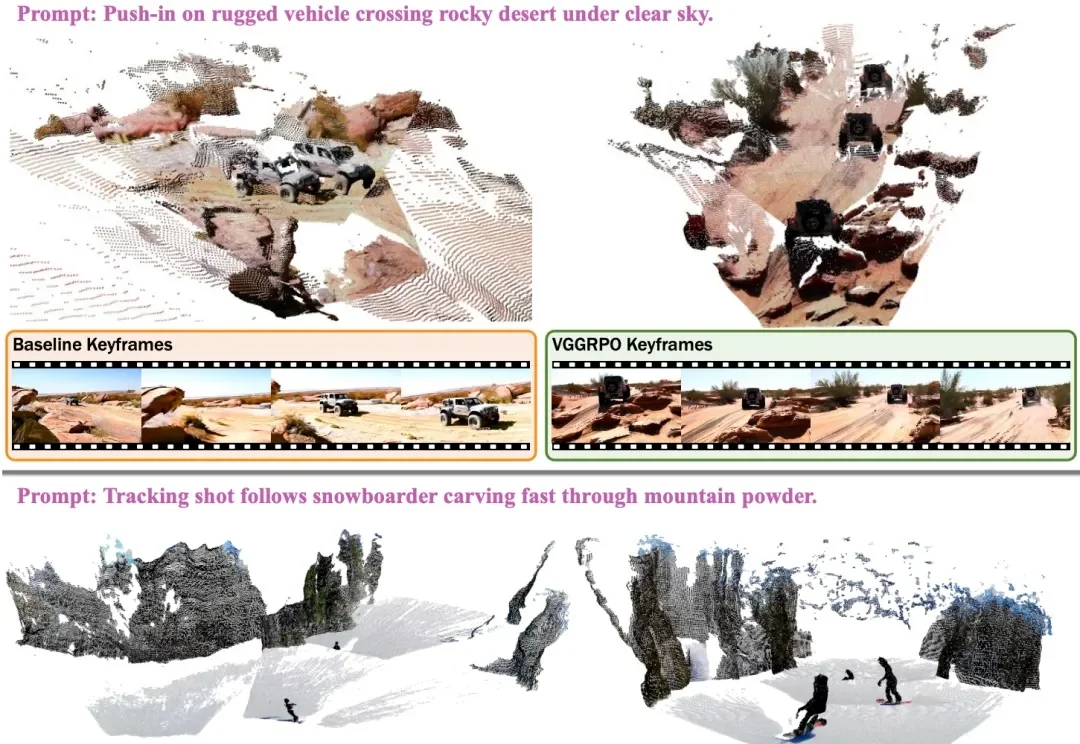
大规模视频扩散模型,画面越来越真,却总在“物理定律”上栽跟头。
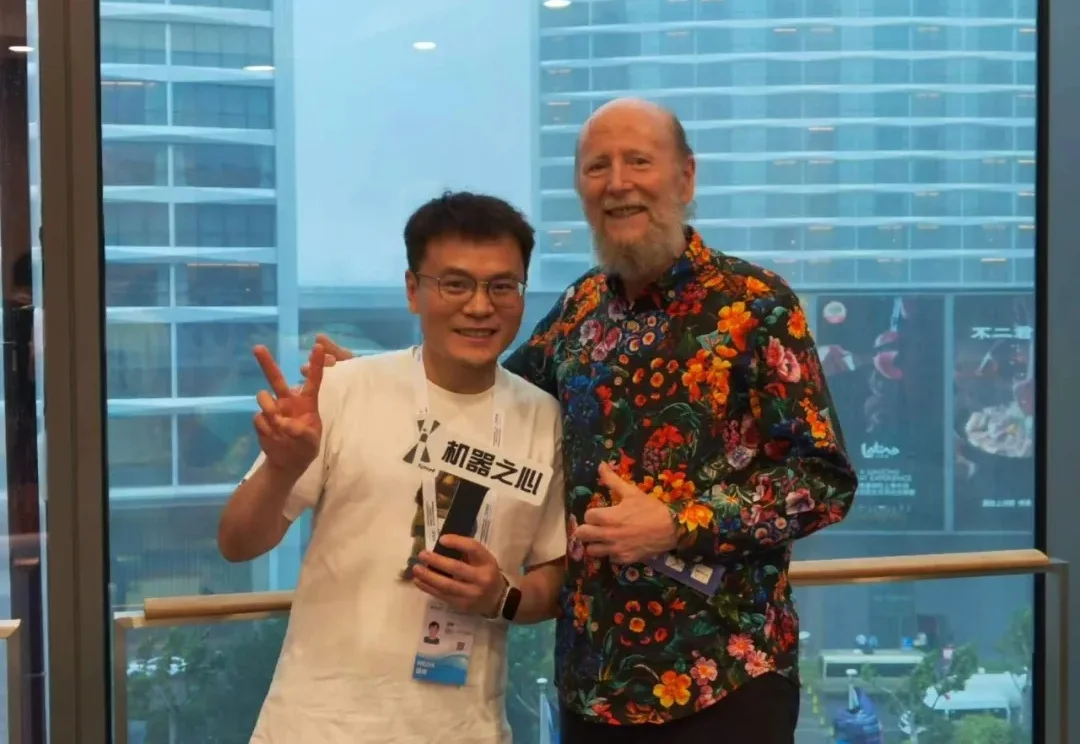
WAIC 2026 期间,我们和另外几家媒体(机器之心是其中唯一的专业媒体)共同对来到中国的强化学习奠基人、2024 年图灵奖得主 Richard Sutton 做了一场群访。
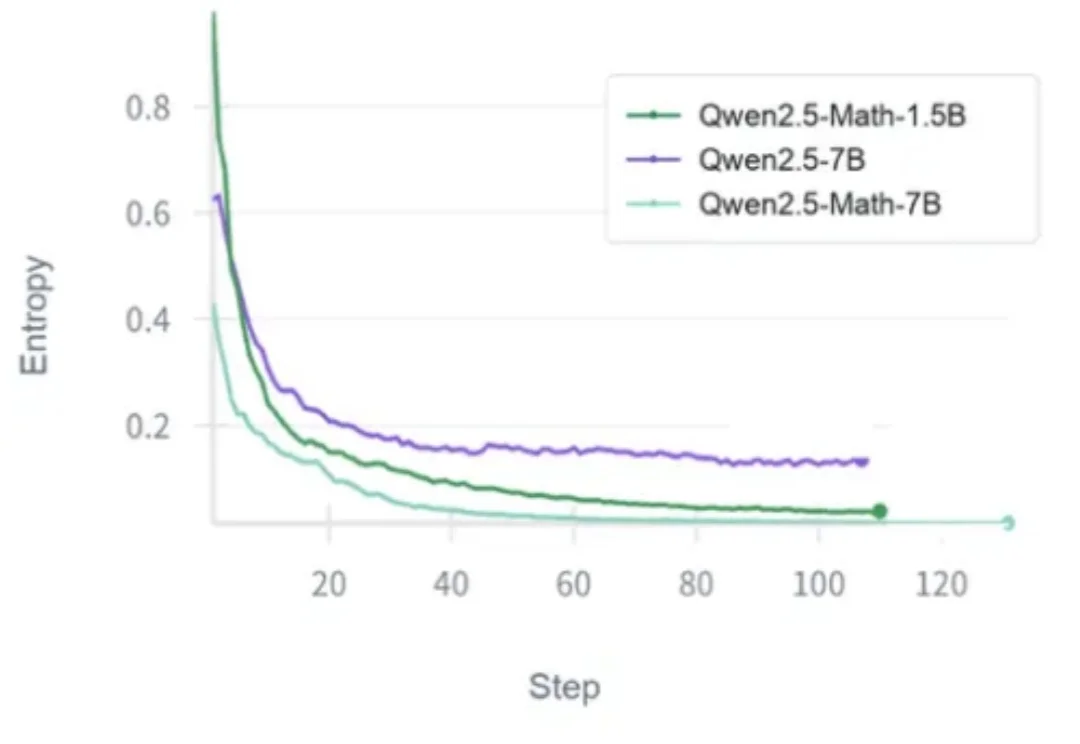
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。
年近 70 岁的图灵奖得主、强化学习之父理查德・萨顿(Richard Sutton),宣布创业了。本周一,Richard Sutton 宣布与 Khurram Javed 共同创立新公司 Oak Lab,要打破当前深度学习方式,用全新的理念构建 AGI。
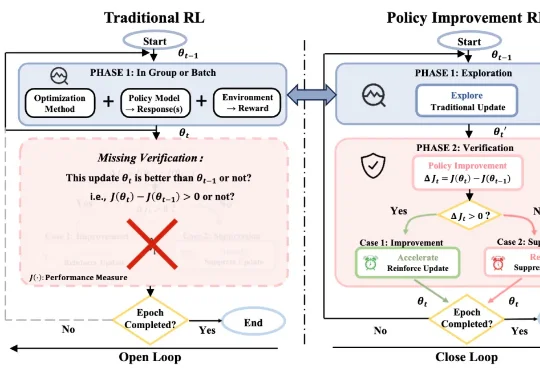
来自北航、北大、美团的研究团队提出了Policy Improvement Reinforcement Learning, PIRL,以及对应的落地算法 PIPO。这项工作关注的是大模型 RL 后训练中一个非常基础、但长期被默认跳过的问题:一次更新在当前数据上看起来优化了学习信号,是否就真的说明模型策略变强了?