北大等联合发布Data Pyramid:用五层数据金字塔系统回答「机器人应该从什么数据中学习?」
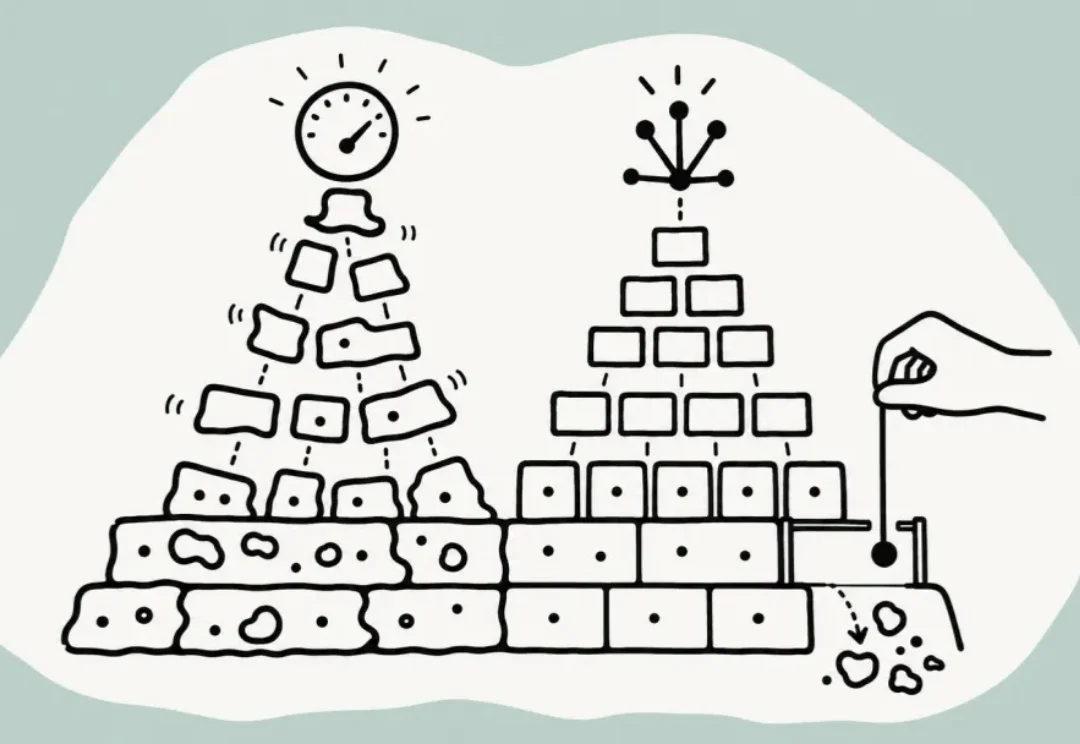
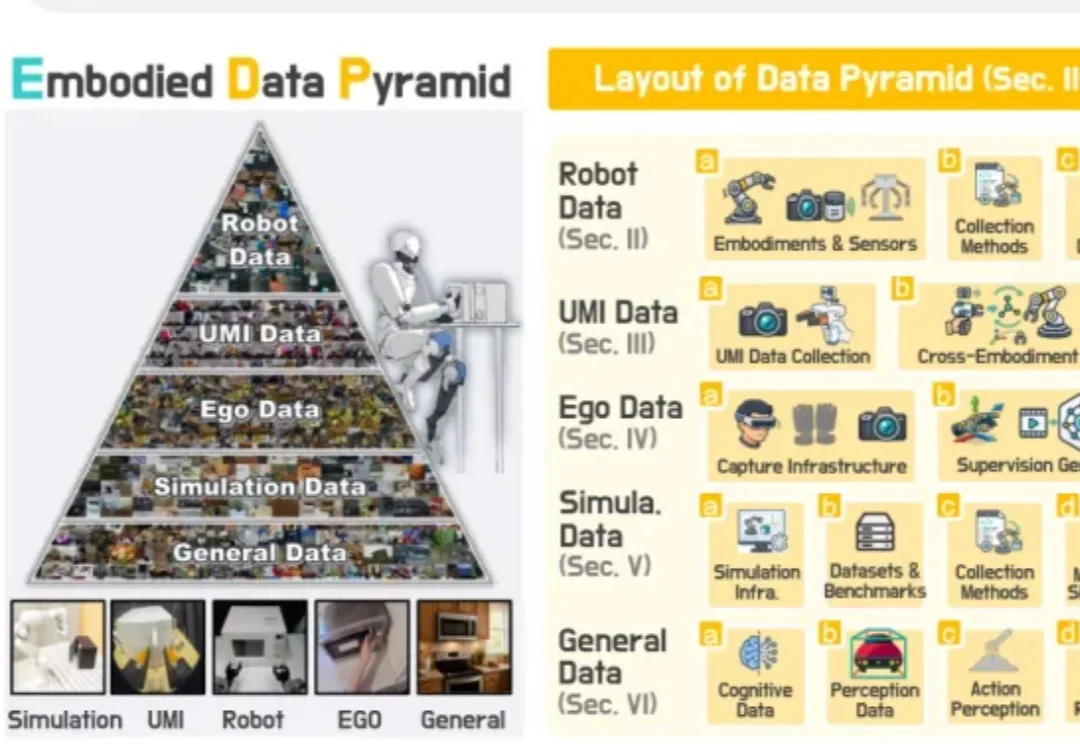
北大等联合发布Data Pyramid:用五层数据金字塔系统回答「机器人应该从什么数据中学习?」多模态基础模型可以通过互联网规模的图像与语言学习「看」和「说」,但具身智能没有同样的捷径。机器人必须进一步理解物理状态与动力学,判断动作如何改变环境,并在真实世界中执行连续行为;这要求训练数据同时连接观察、状态、动作与物理后果。
搜索
多模态基础模型可以通过互联网规模的图像与语言学习「看」和「说」,但具身智能没有同样的捷径。机器人必须进一步理解物理状态与动力学,判断动作如何改变环境,并在真实世界中执行连续行为;这要求训练数据同时连接观察、状态、动作与物理后果。
拆文之前,先过下载这一关。跑通了,就别让它烂在聊天记录里。
无论是李飞飞教授持续强调的空间智能,还是黄仁勋在演讲与行业峰会中反复描绘的Physical AI,2026年的科技产业正在传递一个无比明确且强烈的信号:AI正在跨越纯软件与数字比特的边界,全面走向真实的物理世界。
近日,Milvus 3.0 正式上线。作为 Milvus 架构演进中的里程碑式版本,3.0 不仅带来多项突破性新功能,更从底层重塑了向量数据的存储、索引与检索边界。在 Milvus 3.0 中,你可以获得:
未来几年,医疗大模型的行业竞争将不再局限于基础模型技术的单点对抗,而是演变为模型能力、医疗数据、临床场景、医院生态四位一体的综合实力竞争。下文筛选海内外各10家代表性企业,集中展现了全球医疗大模型产业链核心力量与资本流向(本文内容仅作行业研究参考,不构成任何投资建议、投资引导及相关承诺)。
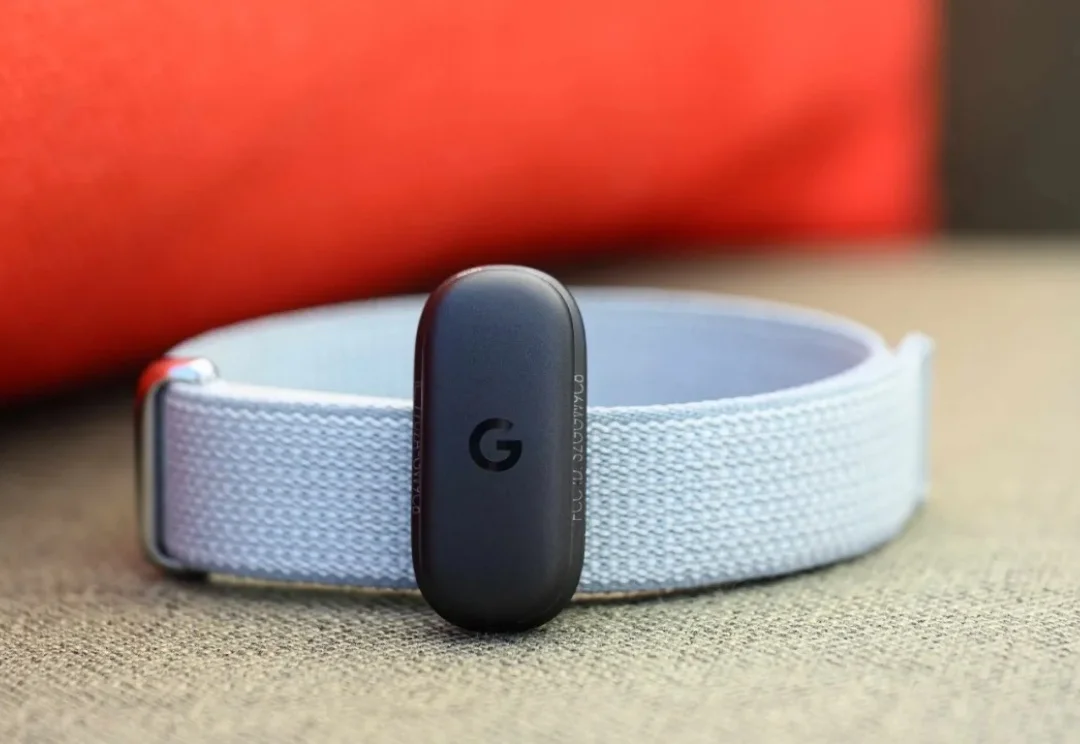
但如果你问的问题收束成:「今年最火的 AI 可穿戴硬件是什么?」那答案大概率只有一个—— Fitbit Air。仅仅一个数据就足以说明它的现象级爆火:作为一款官方开售已经超过两个月的设备,在二手平台你至今仍然需要加价 200~300 元购买。
最近,有个很有意思的现象。
Token可以“热”,但Token工厂必须靠原生液冷“冷”下来。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。