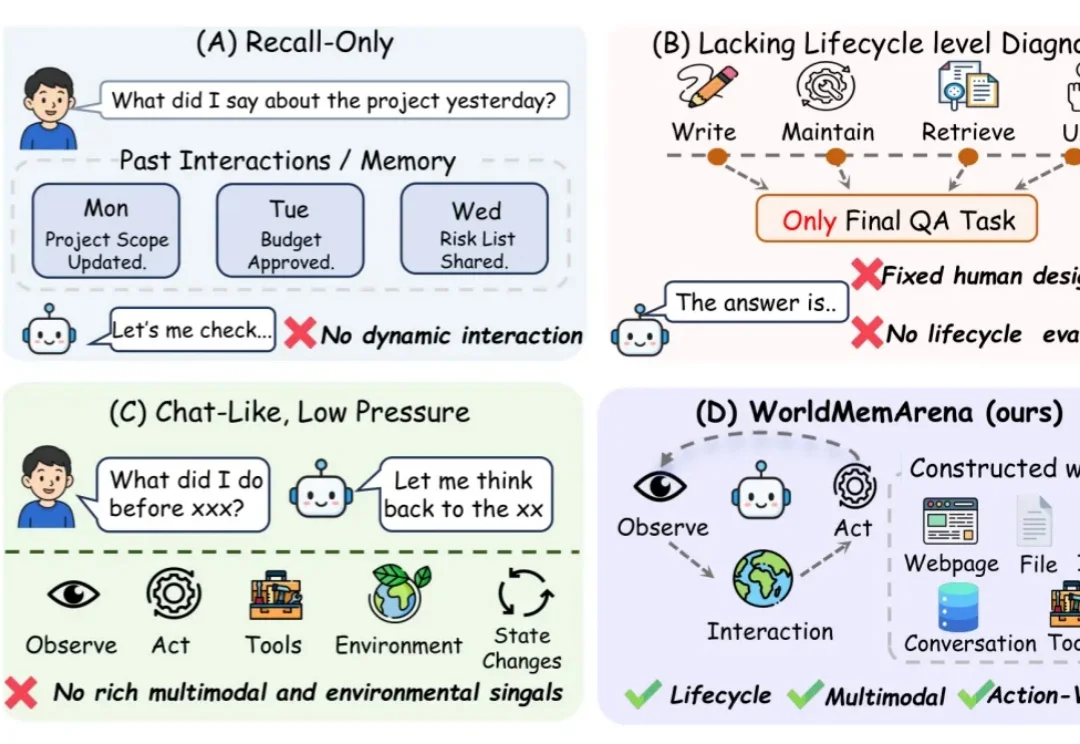
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
来自主题: AI技术研报
8305 点击 2026-10-21 10:12

 搜索
团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
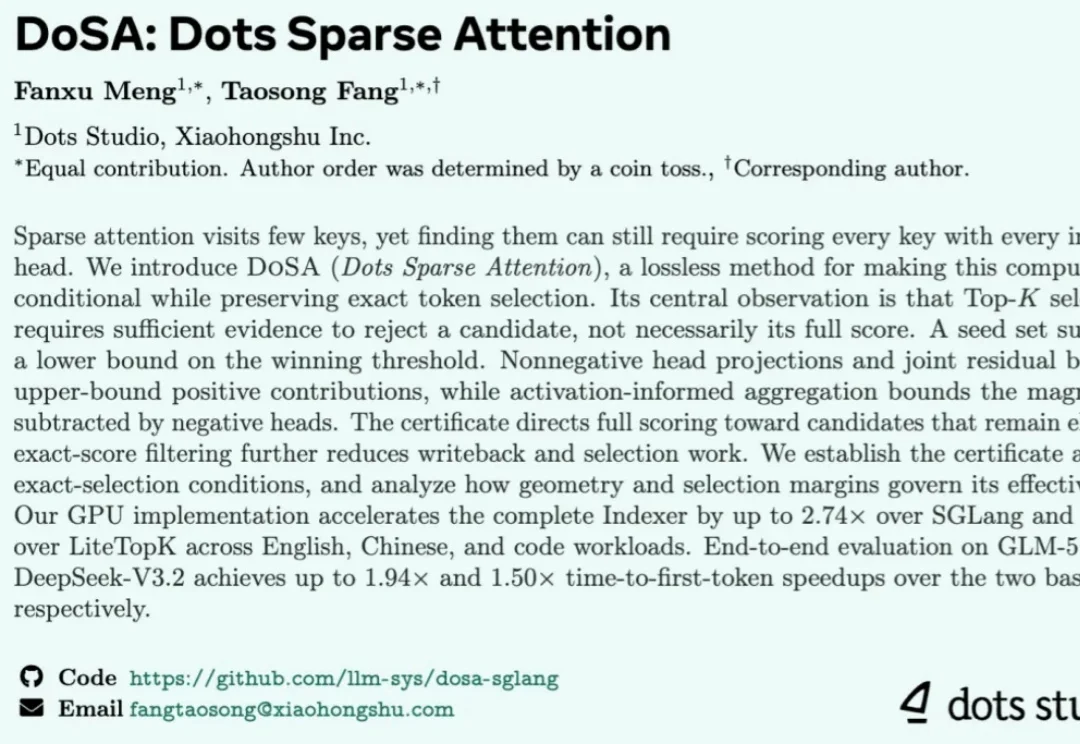
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
AI圈,最近集体盯上了三个字母:RSI。
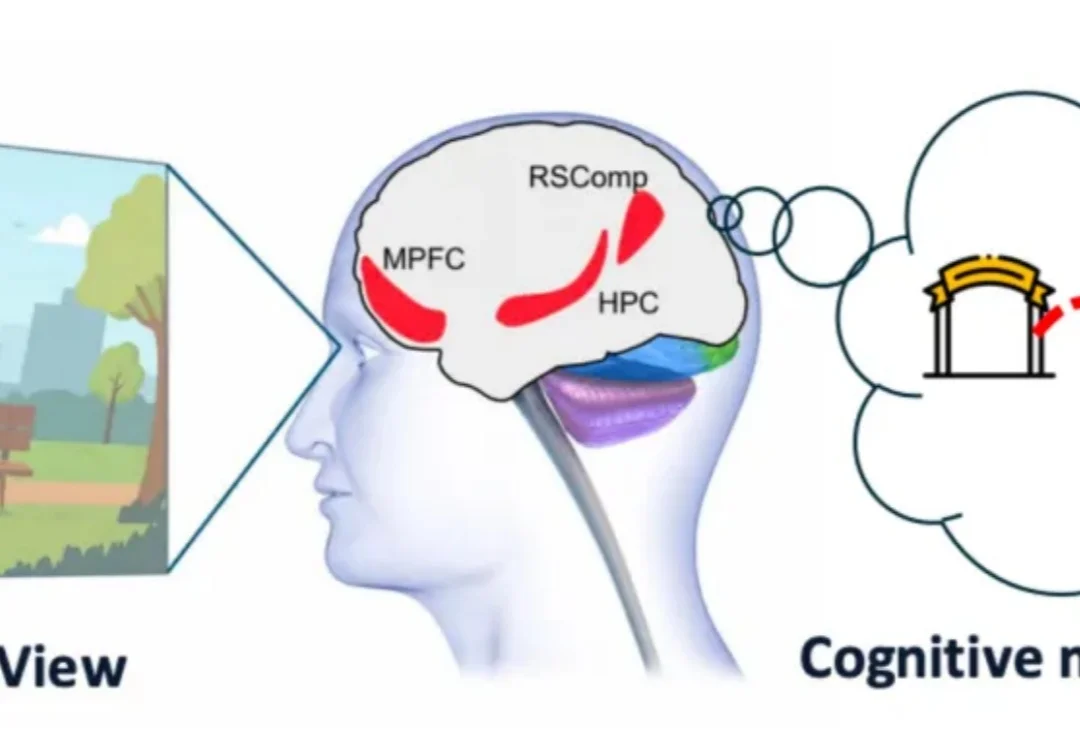
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
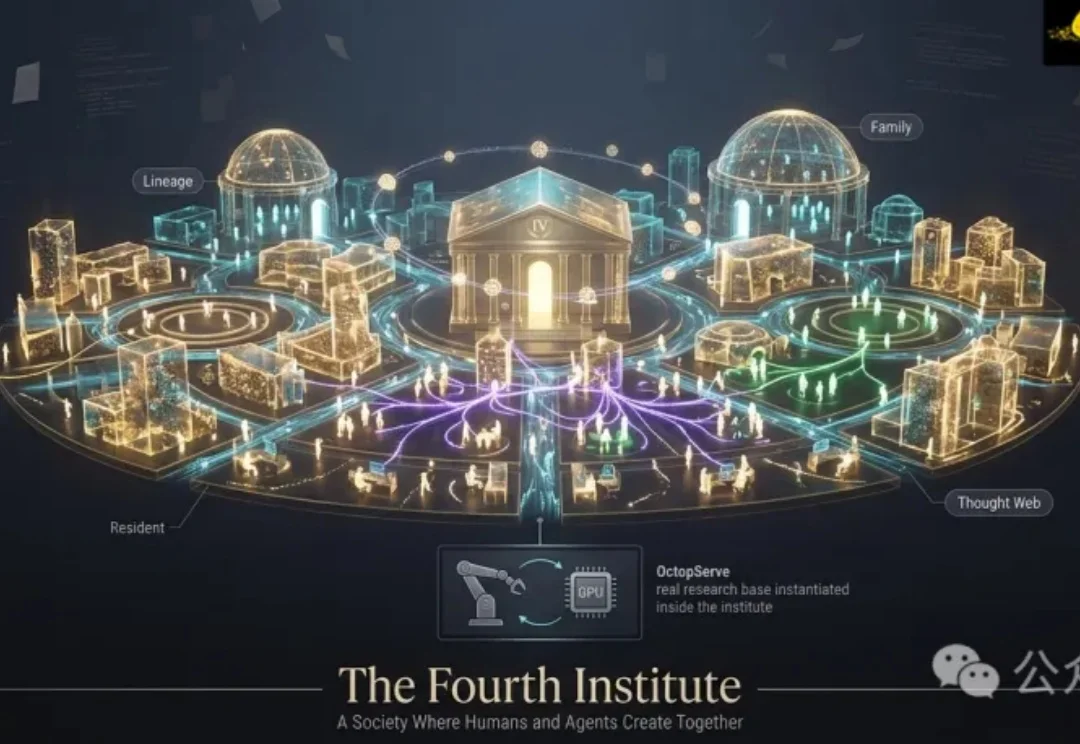
「全球只有大约5,000人,真正见识过顶尖AI的能力。」这是Andrej Karpathy近日分享的一个观察。他说,只有站在漏斗顶端的那一小撮研究者,才能看到数千个AI Agent长时间协作、昼夜不停地做科研。
不er,为什么要化身一只果蝇在世界模型里飞啊啊啊?!
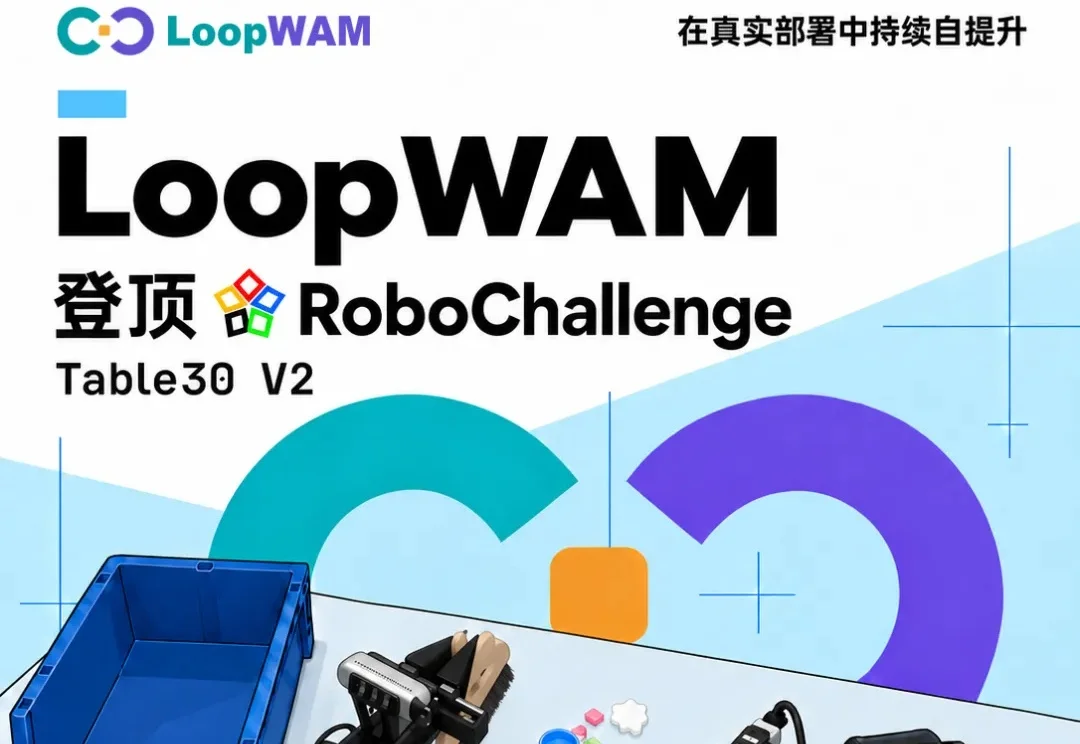
近日,由清华大学、原力灵机与极寰时代联合研发的世界动作模型LoopWAM,登顶真机评测榜单RoboChallenge Table30 V2,成功率与过程分双双位列榜首,成绩超过VLA-DM0.5等同期方案。同时,LoopWAM在仿真榜单RoboTwin 2.0和RoboCasa365上同样取得SOTA表现。
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
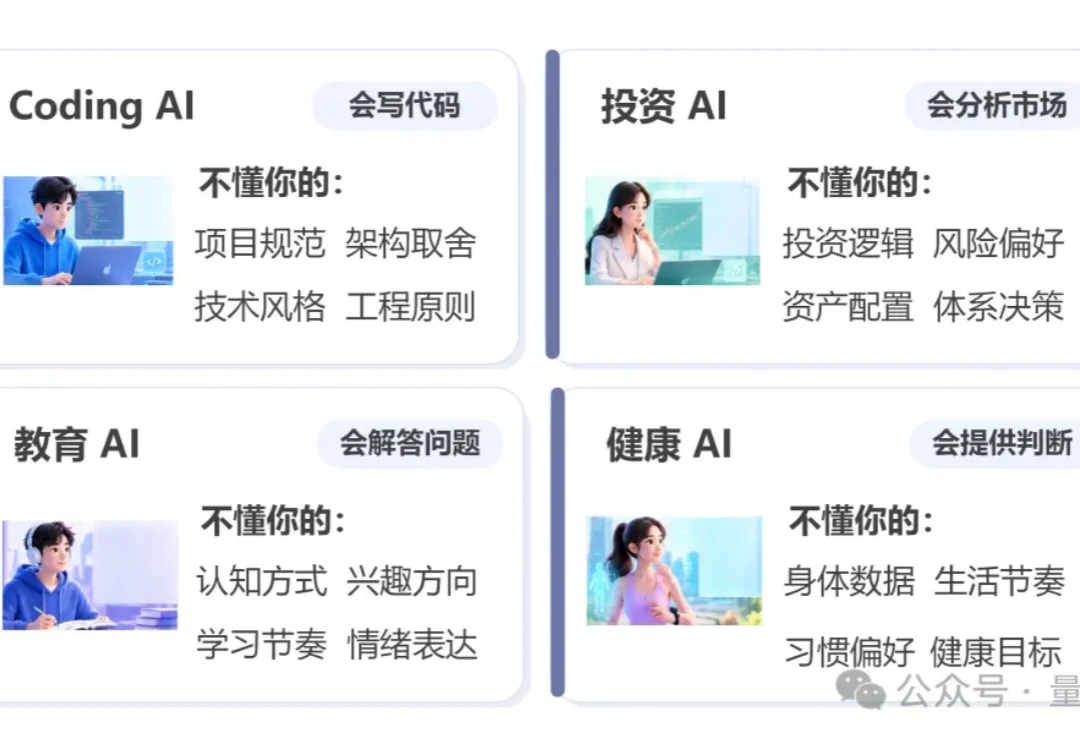
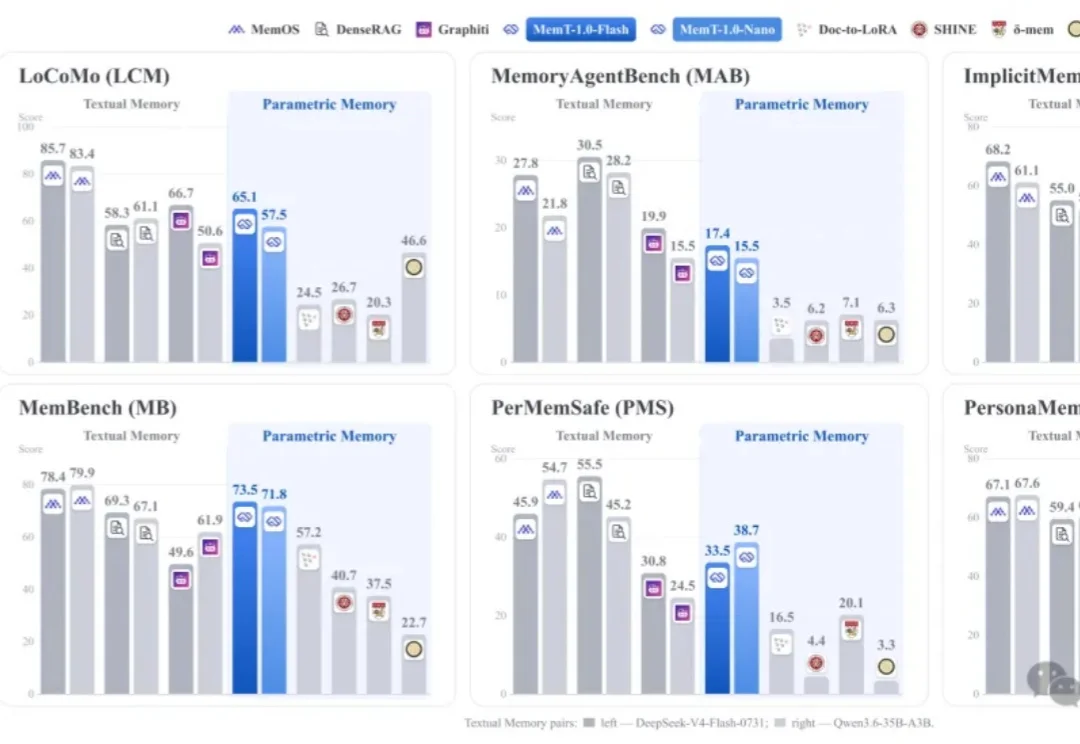
从通用模型到个性化智能,人工智能的竞争正在向长期学习与专属能力沉淀延伸。