别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透
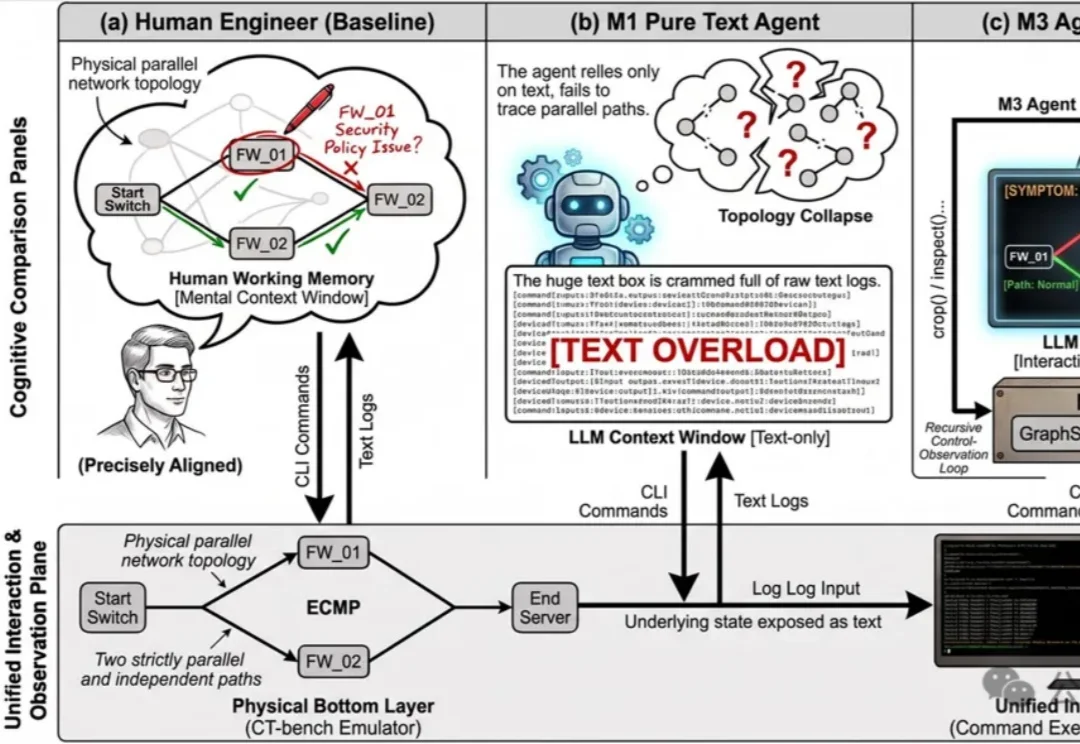
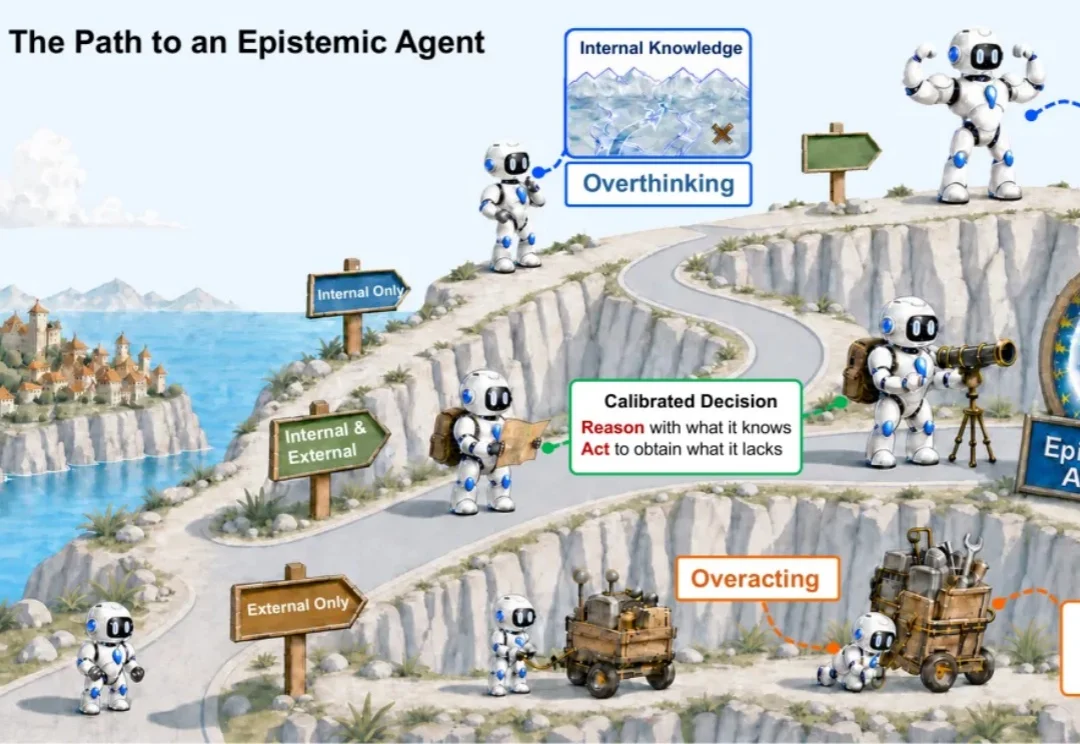
别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
搜索
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
“智能并不局限于大脑内部。当我们使用纸笔或地图来梳理复杂问题时,这些外部工具就成为了我们‘延展的心智’。”
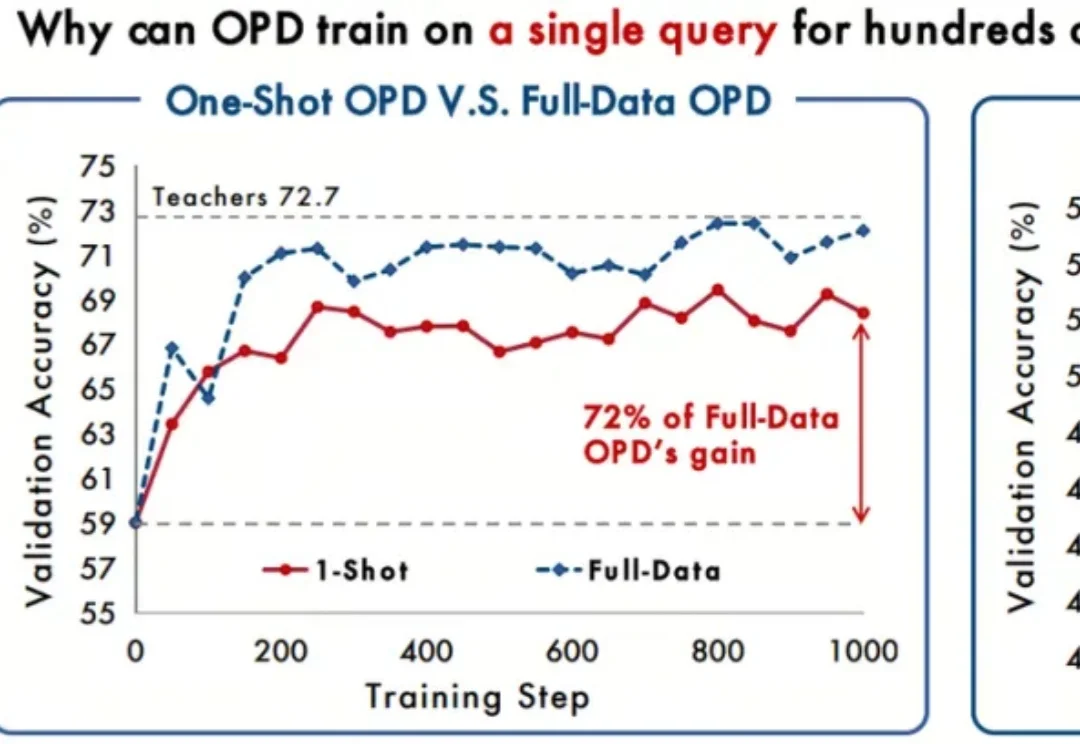
把 On-Policy Distillation(在线策略蒸馏,OPD)的训练集从 17000 道题删到 1 道,会发生什么?
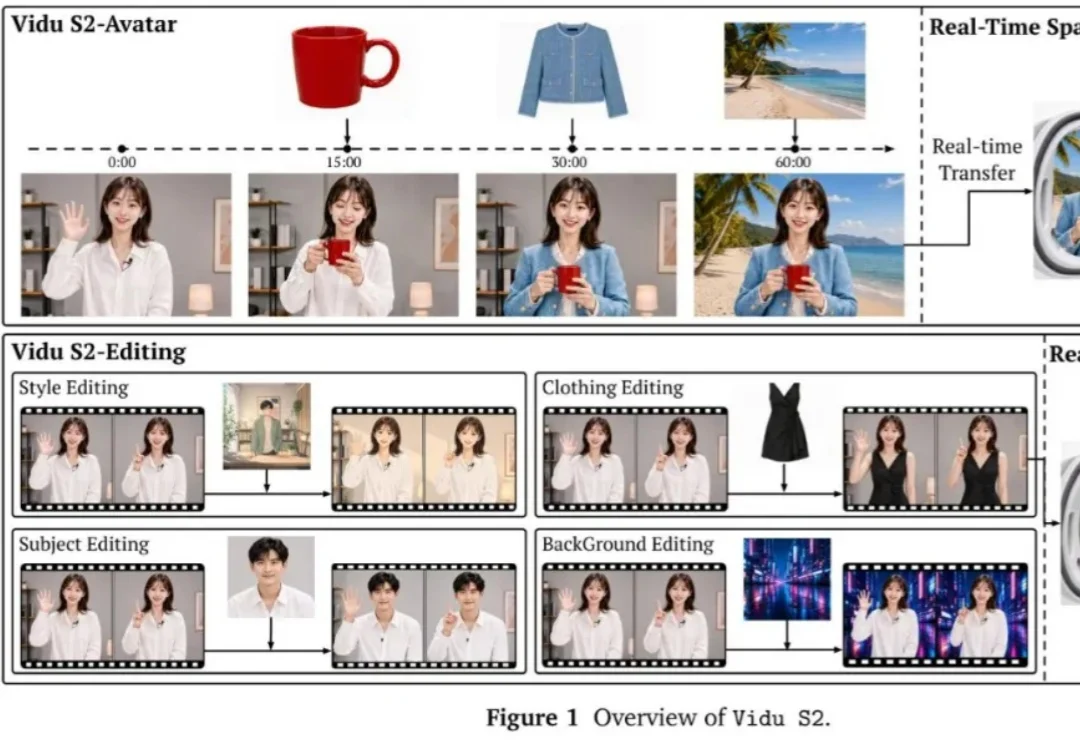
刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款:
大模型过去几年的能力跃迁,几乎都围绕一个词:Scaling。
Token词元替代了Byte字节,但不意味着大模型都得是Token。
过去两周,AI圈最让人坐不住的三个字母,就是RSI。
Astra 惊艳之后,具身公司还有护城河吗?
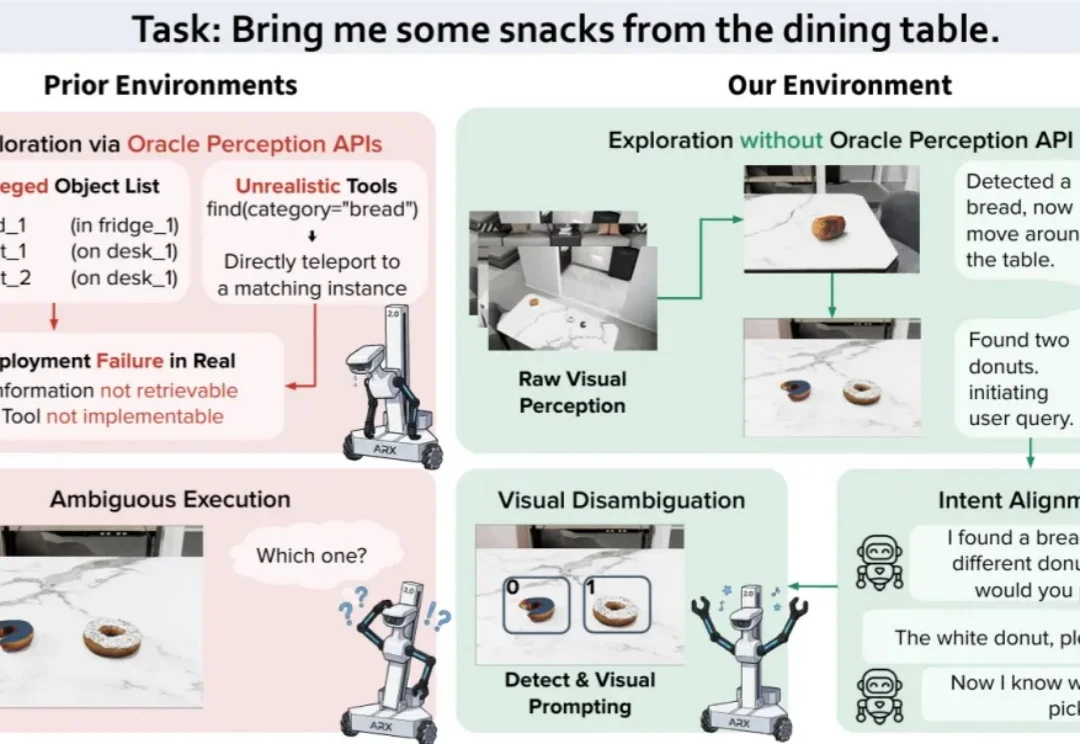
真实家庭任务往往从「不完整的信息」开始:机器人不知道目标在哪里,用户也未必能一次说清自己想要什么。面对「帮我从餐桌上拿点零食」这样的模糊指令,机器人不仅要主动寻找候选物体,还要在发现面包和多个甜甜圈后进一步询问用户,确认究竟该拿哪一个。
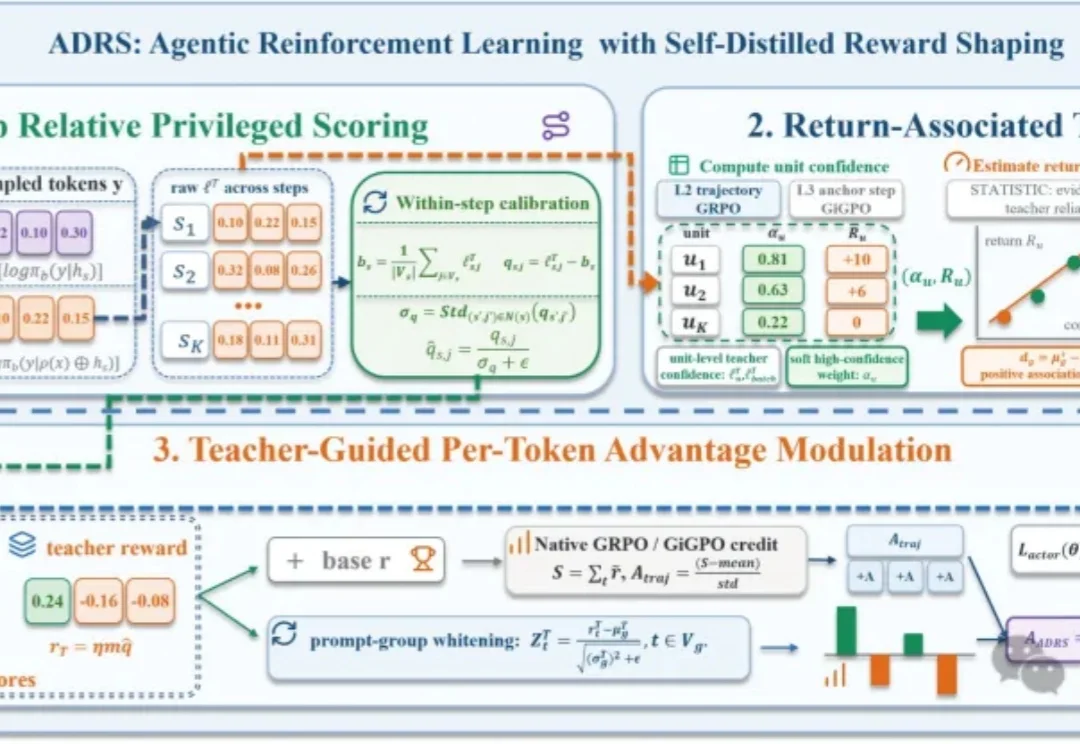
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。