黄仁勋:针对印度市场推轻量级AI模型,一年内让印度算力扩大20倍
黄仁勋:针对印度市场推轻量级AI模型,一年内让印度算力扩大20倍英伟达将携手Wipro、TCS和Infosys等印度IT巨头,合作开发全球性AI模型。
来自主题: AI资讯
6831 点击 2024-10-25 09:32

 搜索
英伟达将携手Wipro、TCS和Infosys等印度IT巨头,合作开发全球性AI模型。
最近,字节在AI方面又搞了个大新闻。 一个字节的实习生,因为对团队资源分配不满,用恶意代码把模型训练过程给投了“毒”,字节这边损失不小
OPPO收购波形智能,加速端侧大模型布局。

个体的效率提升未必能转化为组织的效率提升
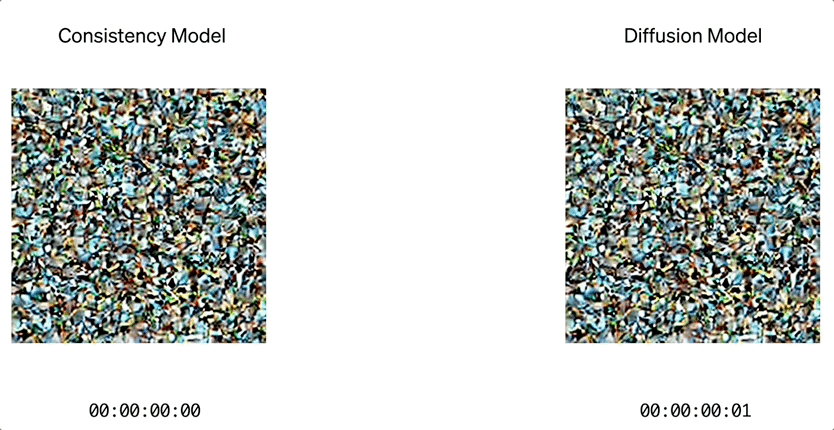
两位清华校友,在OpenAI发布最新研究—— 生成图像,但速度是扩散模型的50倍。 路橙、宋飏再次简化了一致性模型,仅用两步采样,就能使生成质量与扩散模型相媲美。
工具调用是 AI 智能体的关键功能之一,AI 智能体根据场景变化动态地选择和调用合适的工具,从而实现对复杂任务的自动化处理。例如,在智能办公场景中,模型可同时调用文档编辑工具、数据处理工具和通信工具,完成文档撰写、数据统计和信息沟通等多项任务。
现如今,大型语言模型(LLM)生成的内容已经充斥了整个互联网,并且这些模型还能模仿各种类似真人的语气和行文风格,让人难以分辨眼前的文本究竟来自人类还是 AI。
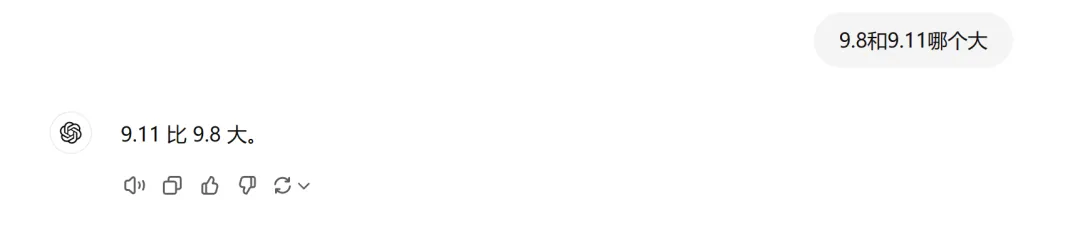
大模型为什么认为 9.8<9.11?神经元级别的解释来了。 9.8 和 9.11 到底哪个大?这个小学生都能答对的问题却难倒了一众大模型,很多模型输出的结果都是「9.8<9.11」。
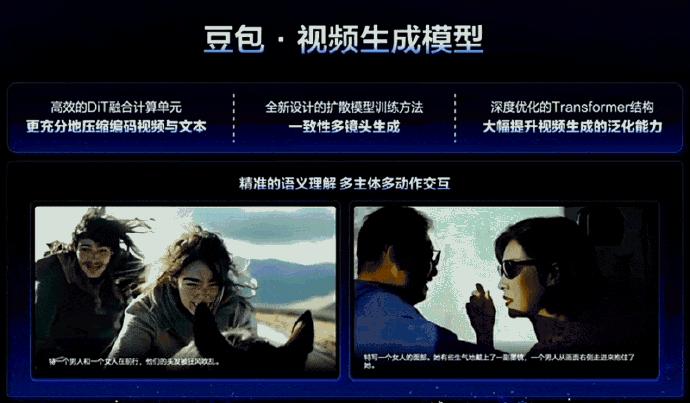
2023年8月18日,字节跳动旗下AI对话产品Grace,更名为「豆包」。
TL;DR:DuoAttention 通过将大语言模型的注意力头分为检索头(Retrieval Heads,需要完整 KV 缓存)和流式头(Streaming Heads,只需固定量 KV 缓存),大幅提升了长上下文推理的效率,显著减少内存消耗、同时提高解码(Decoding)和预填充(Pre-filling)速度,同时在长短上下文任务中保持了准确率。