# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
多轮图像编辑允许用户通过连续指令,逐步调整同一张图片中的物体、外观与场景。随着图像生成进入交互创作,用户需要根据中间结果继续修改,模型也需要在完成新要求的同时,保留此前已经确认的内容。
但现有模型往往在几轮之后出现明显偏差:纹理越来越重,局部细节逐渐失真,没有要求修改的区域也可能发生变化。这些问题分别涉及画质稳定性与跨轮内容一致性,限制了模型持续编辑的能力。
来自商汤研究院、香港科技大学 MMLab、斯坦福大学和清华大学智能产业研究院的研究者,联合提出多轮图像编辑训练方法 MT Forcing,改善基于自回归扩散的统一多模态模型在连续编辑中的画质退化与内容漂移问题。
论文的主要贡献包括三点:
1. 提出 Single-Turn DMD,用单轮教师指导学生的多轮自主生成,改善连续编辑中的画质退化。
2. 引入 Teacher-Forcing Guidance,通过一致参考轨迹上的预热与正则化监督,帮助模型保留跨轮内容。
3. 将两类互补目标结合为 MT Forcing,在 SenseNova-U1 与 SenseNova-U1.5 上验证了画质稳定性、内容一致性和指令遵循的改善。
连续编辑中的退化起源于 exposure bias(暴露偏差)。训练时,模型通常根据给定的参考历史学习下一轮编辑;实际推理时,它需要根据自己此前生成的图片继续修改。
这一区别可以用论文中的条件分布表示:
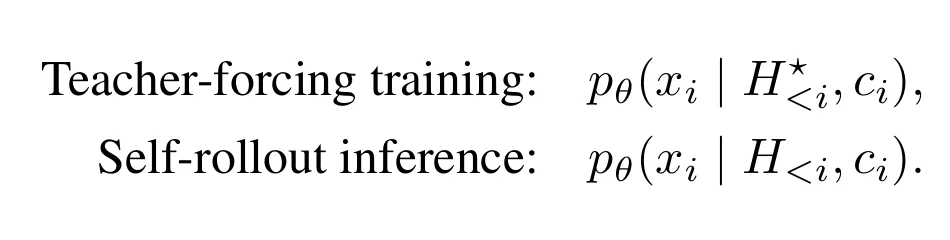
上式中的 H⋆ 表示参考历史,H 表示模型自主生成的历史,cᵢ 为当前指令。
参考历史中的内容通常连贯、准确,自主生成的历史却可能已经带有纹理偏差、伪影或意外修改。模型如果主要在参考历史上学习,就缺少处理这些偏差的经验;一旦把不完全准确的输出作为下一轮条件,误差便可能继续累积。
因此,MT Forcing 让学生模型在训练时就进行 self-rollout:每轮接着自己的输出编辑,使训练覆盖推理时实际遇到的历史。与此同时,还需要为这些输出提供不会随轮次退化的质量参照。
MT Forcing 利用了两个观察:单次编辑通常带来的画质损失有限,编辑模型也能在一条指令中执行多个操作。因此,教师可以每次从原图出发,一次完成截至当前轮次的累计编辑要求。
例如,“添加一个花瓶” 之后再要求 “把它改成蓝色”,可整理为 “添加一个蓝色花瓶”。教师接收原图与整合指令,学生仍按原始顺序逐轮生成。两者对应相同的累计编辑意图,但教师的监督不受递归编辑的误差累积影响。
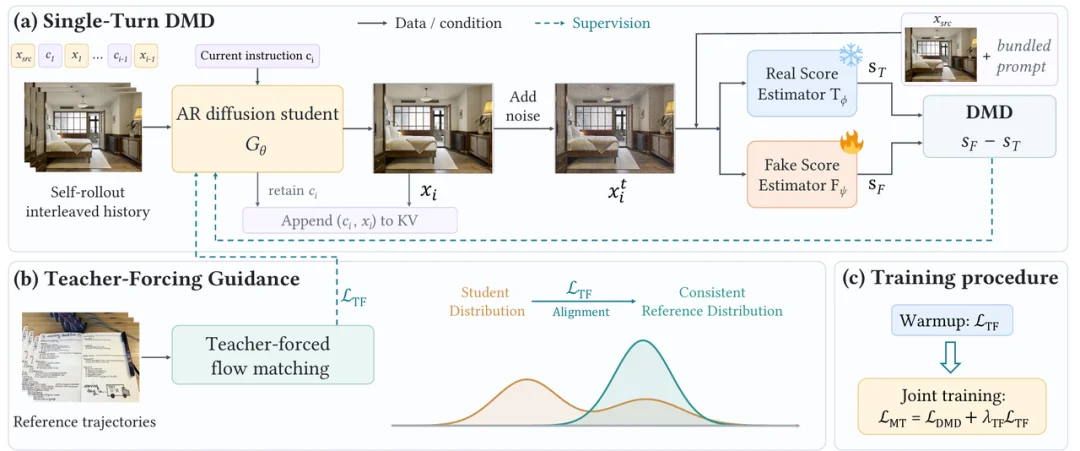
学生接着自身历史逐轮编辑;单轮教师提供分布匹配监督,参考轨迹补充内容一致性指导。
Single-Turn DMD 在每轮比较学生自主展开的输出分布与教师的单轮输出分布,训练目标如下:
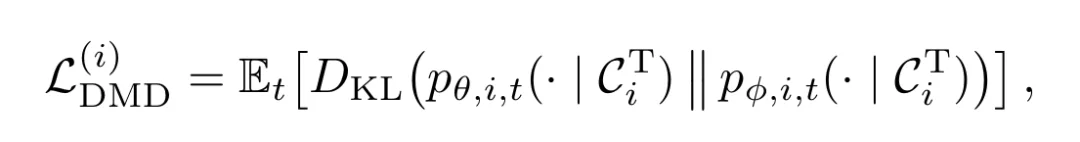
同一原图与整合指令构成教师条件 Cᵀ。pθ 与 pφ 分别对应学生与教师的分布,t 为扩散噪声时间;公式比较两者在相同加噪过程下的分布差异。
这里匹配的是分布,无需学生逐像素复刻某一张教师图片。学生通过自主展开学习处理自身历史中的偏差,再通过教师监督维持输出质量,从而缓解训练与推理之间的差异。
单轮教师能够提供清晰的结果,但整合指令没有规定前几轮已经确定的全部视觉细节。教师知道 “茶壶上要有蓝色花纹”,却不知道学生此前生成的具体纹样。
论文的茶壶案例中,教师独立执行各阶段的累计指令,每张图片都较清楚,花纹的形状与排列却随轮次变化。仅匹配每轮的输出分布,仍不足以保证这些细节沿编辑历史保持一致。
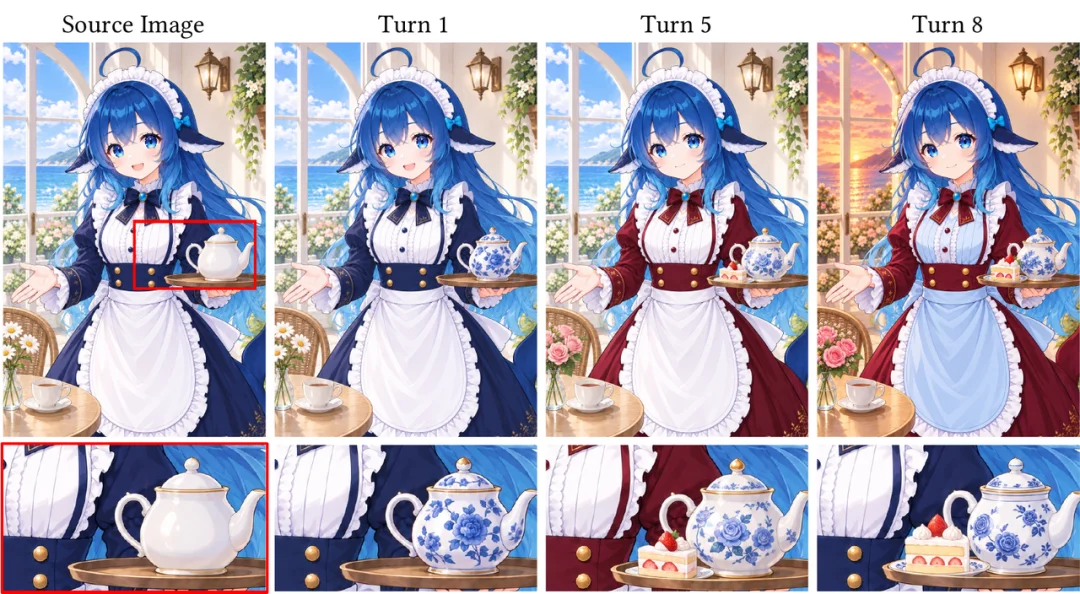
单轮教师独立编辑时的内容变化,放大区域展示茶壶花纹的差异。
Teacher-Forcing Guidance 用连贯的参考编辑轨迹监督历史与下一轮输出的对应关系。首先通过教师强制预热,让模型学习跨轮内容保留;随后在 DMD 蒸馏中继续保留较低权重的参考监督,避免这一能力在分布匹配更新中丢失。
联合训练目标为:
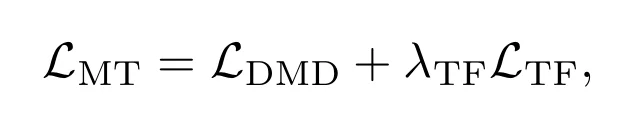
DMD 项指导自主生成的输出分布,TF 项通过参考历史上的流匹配监督约束跨轮内容,λTF 控制两者权重。
两项监督分别作用于生成分布和历史条件下的编辑行为,共同训练同一个学生模型。论文的消融实验中,仅使用 DMD 仍会出现木纹变化,仅使用参考监督仍有后期纹理退化;完整方法对两类问题均有改善。
论文比较了两种基础模型在第 1、4、8 轮的输出。到第八轮,基线的汽车场景出现过饱和光照与粗硬纹理,雪山场景则出现斑点和过强对比度。
加入 MT Forcing 后,画面纹理更干净,场景结构更连贯,先前完成的红色车身、车顶行李箱,以及雪地中的帐篷、滑雪板和路标也得到保留。
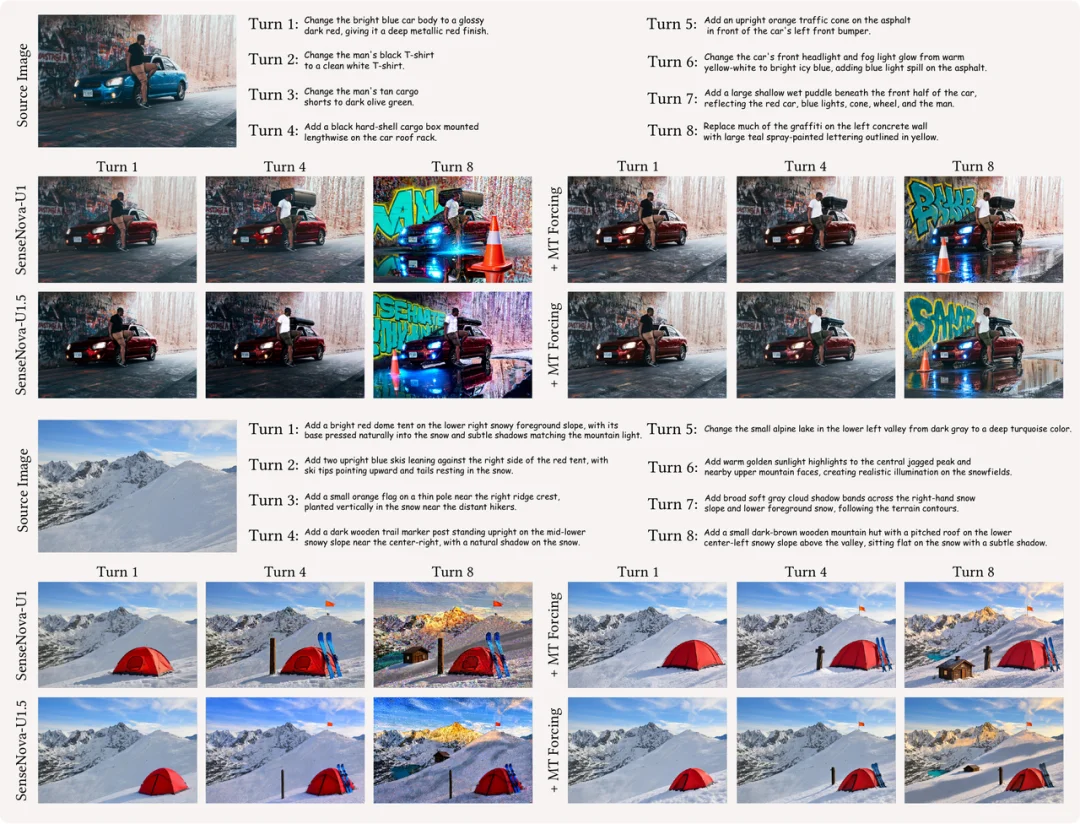
两种基础模型在第 1、4、8 轮的编辑结果,左侧为基线,右侧为加入 MT Forcing 后的结果。
此外,更长轮数的训练前后对比,更能进一步说明 MT Forcing 的有效性
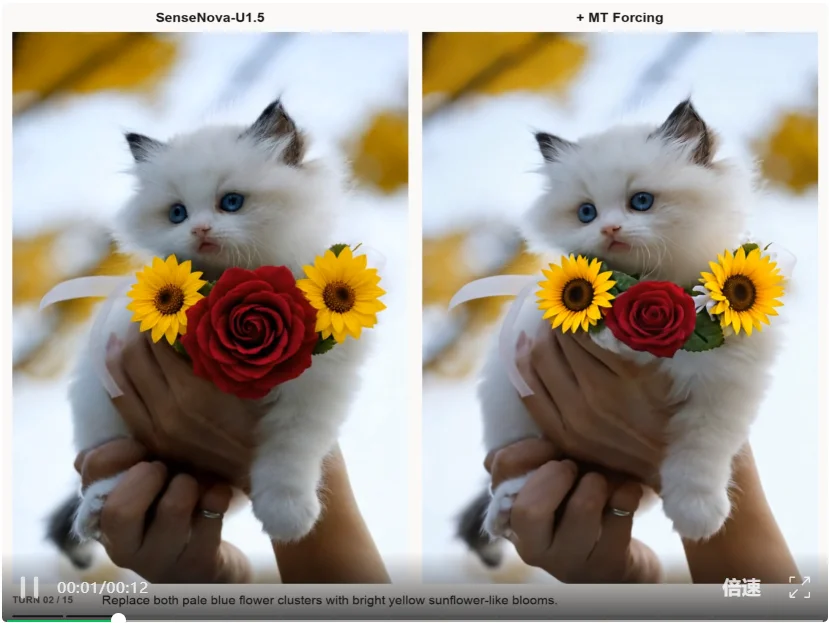
评估采用 MTEdit-Bench 的逐步编辑子集,包含 100 组会话,每组 8 轮。研究团队比较两种基础模型加入 MT Forcing 前后的指令遵循(IF)、内容一致性(CC)、画质抗漂移(DRS)与几何对齐表现。
以 SenseNova-U1.5 为例,第八轮 IF 从 4.52 提升至 9.17,CC 从 3.22 提升至 7.68,两项满分均为 10 分。DRS 满分为 5 分,基线由首轮的 4.09 降至第八轮的 3.03,MT Forcing 则在八轮中保持 4.20—4.35。
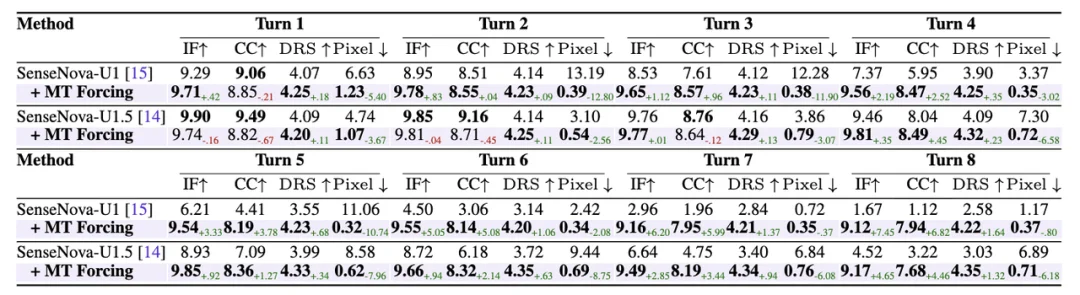
MT Forcing的定量对比
SenseNova-U1 同样获得改善,第八轮 IF、CC 分别提高 7.45 分、6.82 分。从第四轮开始,两种模型的四项指标均优于各自基线。该方法的收益主要体现在持续编辑能力上,首轮部分指标仍低于基线。
论文还用相邻输出间匹配点的平均位移衡量几何变化。SenseNova-U1.5 的八轮均值由 6.34 像素降至 0.74 像素,下降约 88.4%,表明匹配区域的空间位置更稳定。
本文共同第一作者为香港科技大学 MMLab 博士生陈厚源与商汤研究院王凡周,项目负责人为商汤研究院樊翔宇。本项研究于陈厚源在商汤研究院实习期间完成。论文通讯作者为香港科技大学 MMLab 饶安逸老师、商汤科技研究总监杨磊老师及清华大学赵昊老师。
文章来自于"机器之心",作者 "陈厚源、王凡周"。