LeCun重磅成果单挑Scaling Law!1.09亿参数干翻720亿,训练方式比堆参数更本质
LeCun重磅成果单挑Scaling Law!1.09亿参数干翻720亿,训练方式比堆参数更本质660倍的参数差距,结果小模型赢了?!
来自主题: AI技术研报
5889 点击 2026-11-02 16:17

 搜索
660倍的参数差距,结果小模型赢了?!
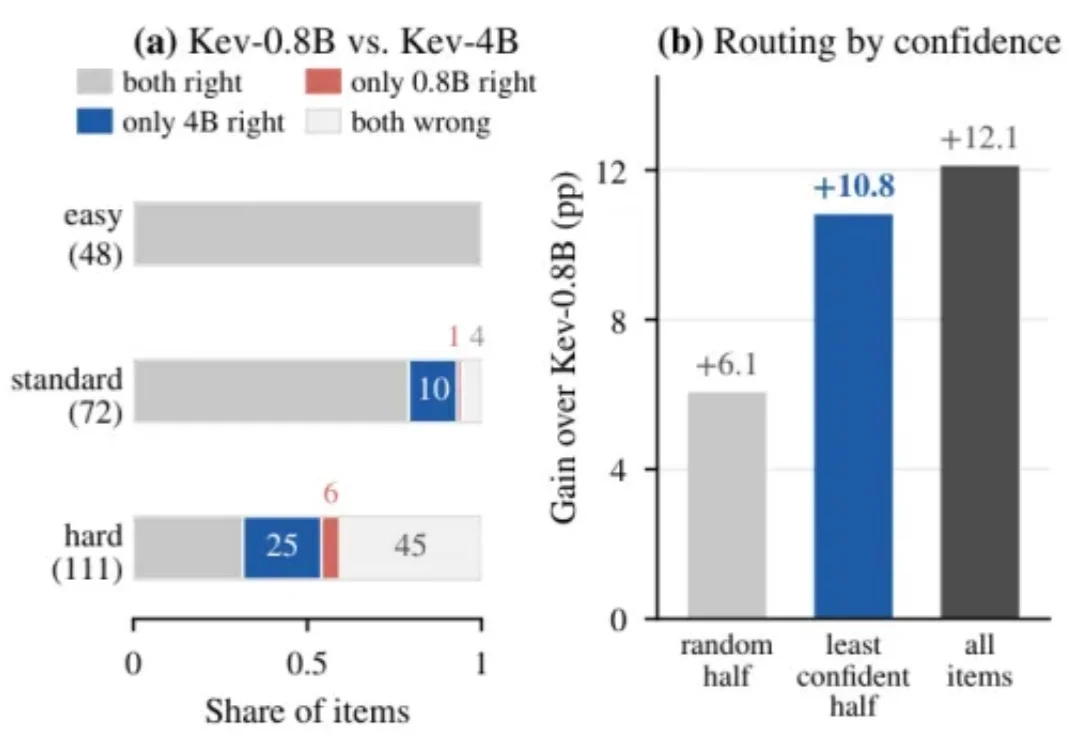
让大模型「多想一会儿」,今天几乎等同于让它多写一些字:先生成一段思维链,再给出答案。
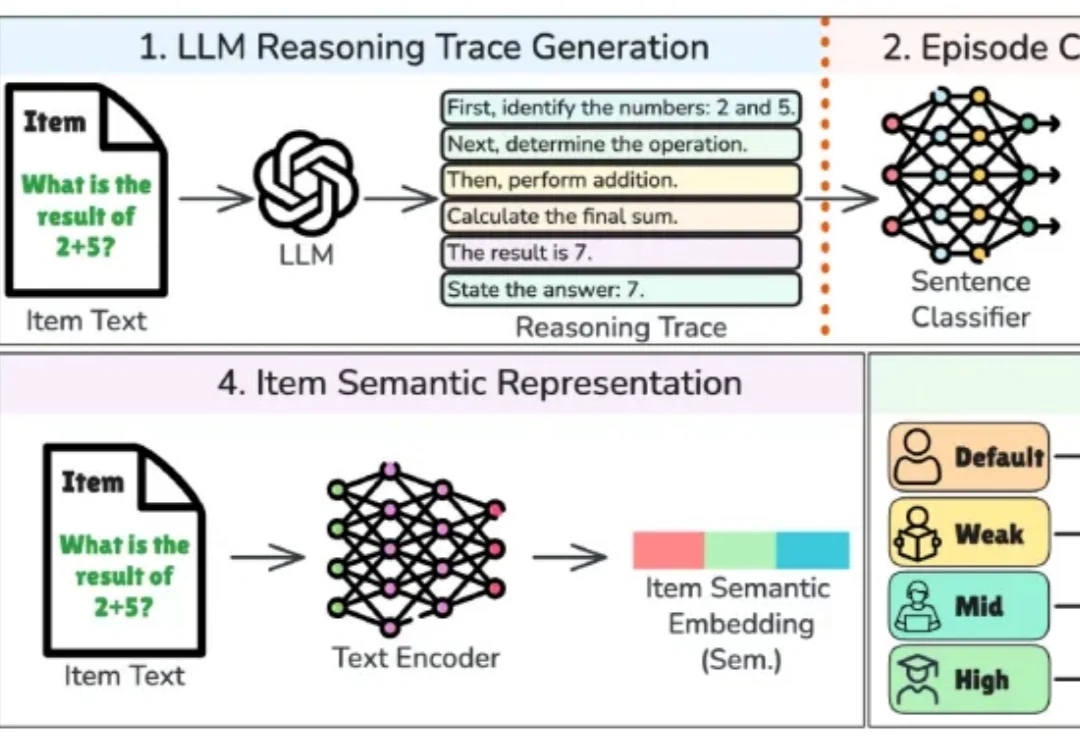
一道试题对人来说有多难,能否从大模型的解题过程中找到线索?
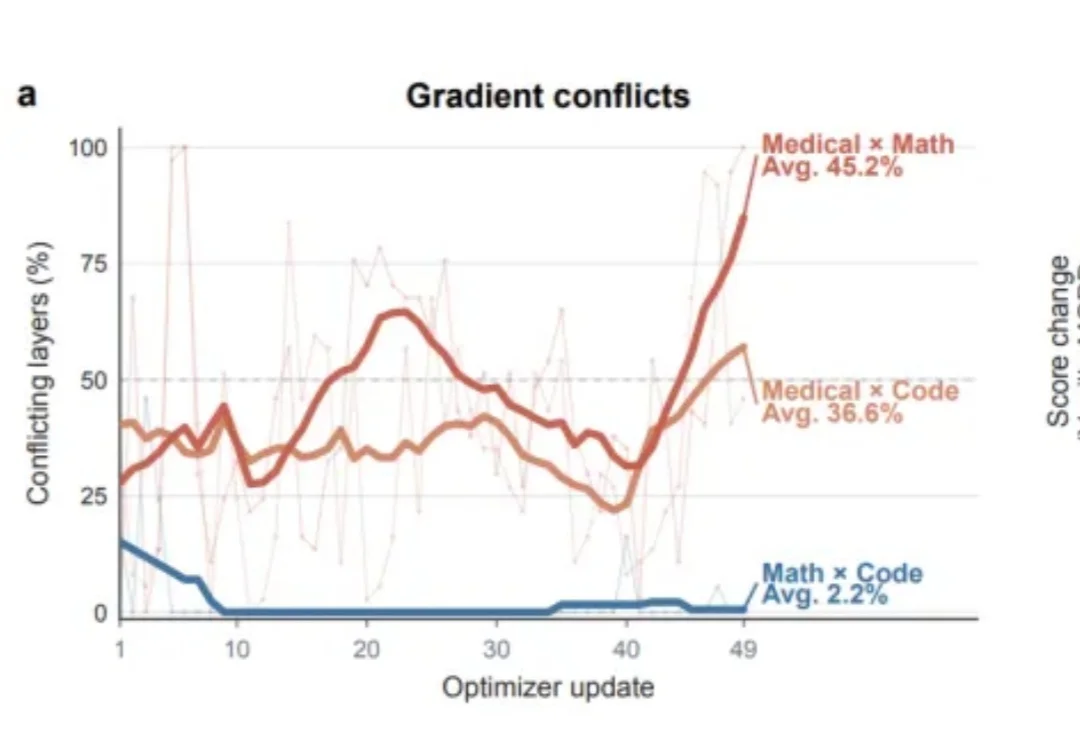
数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?
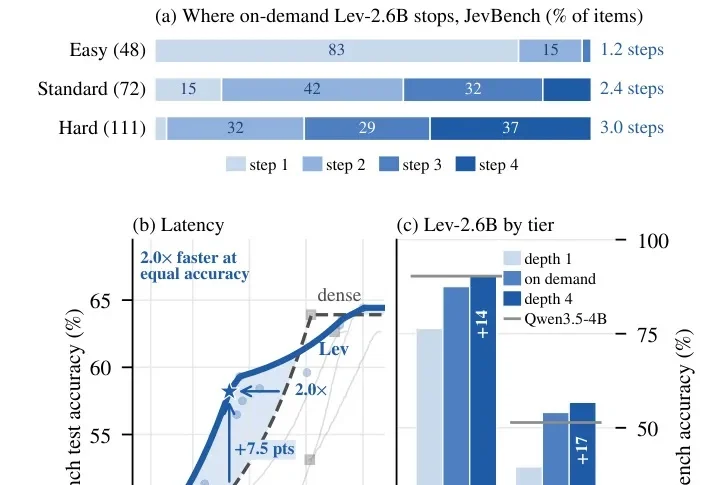
让大模型「多想一会儿」,今天几乎等同于让它多写一些字:先生成一段思维链,再给出答案。
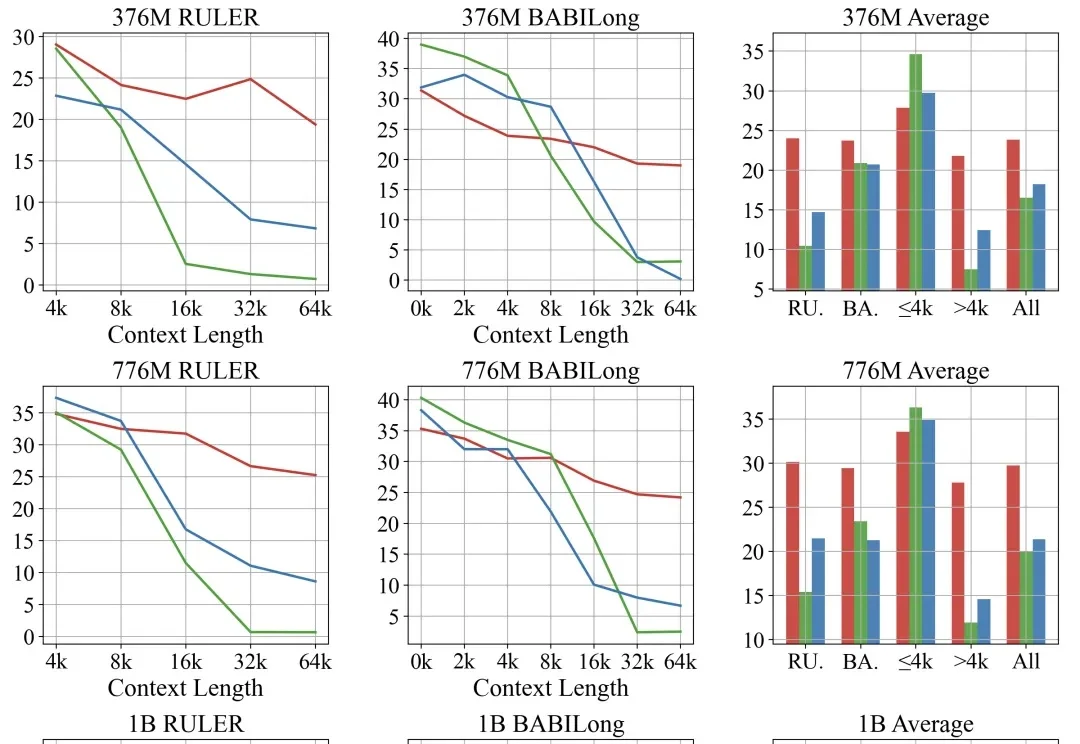
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
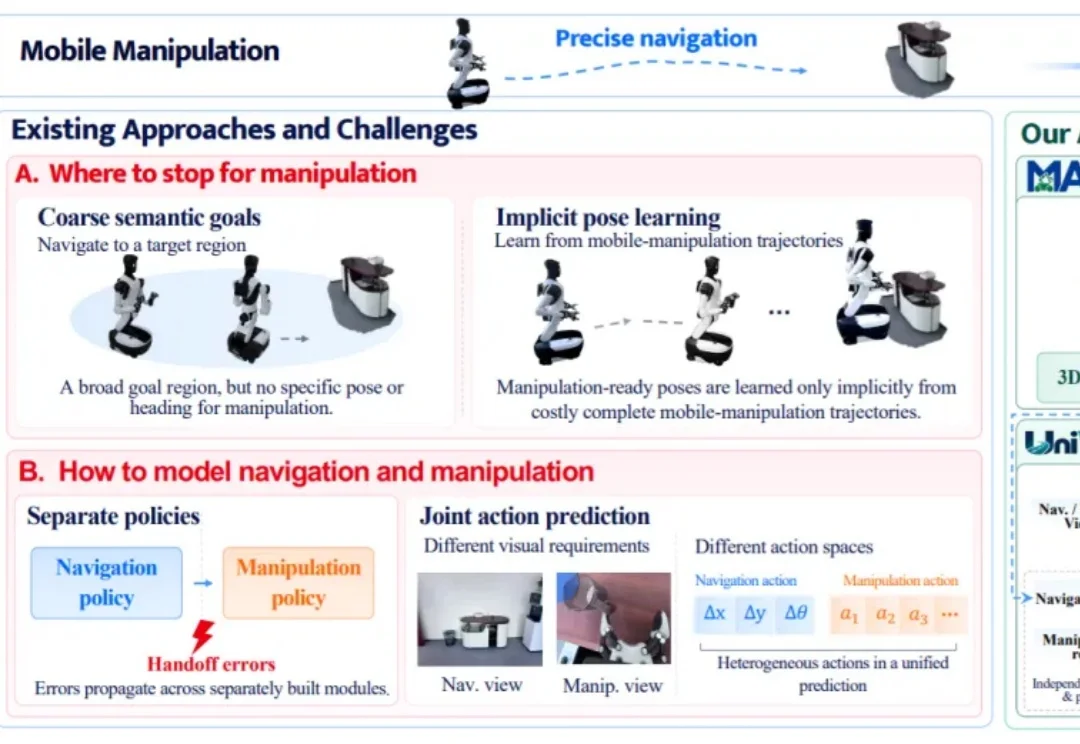
机器人终于不只是知道往哪走,还知道该在哪里停、以什么方向面对目标,甚至停稳之后,就能直接上手干活。
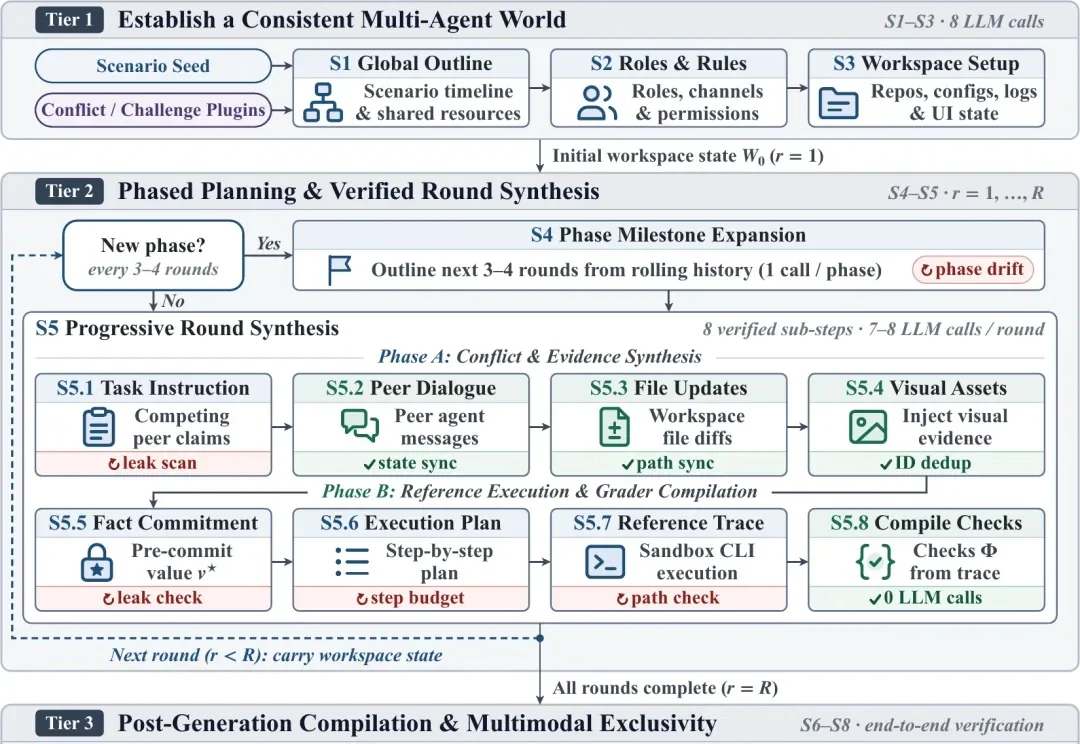
当大模型从“单兵作战”走向“多 Agent 协同操作电脑(Computer Use)”,如果队友 Agent 读了旧缓存报假消息、下发了互相矛盾的指令,甚至锁死了共享文件,主控 Agent 该听谁的?
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
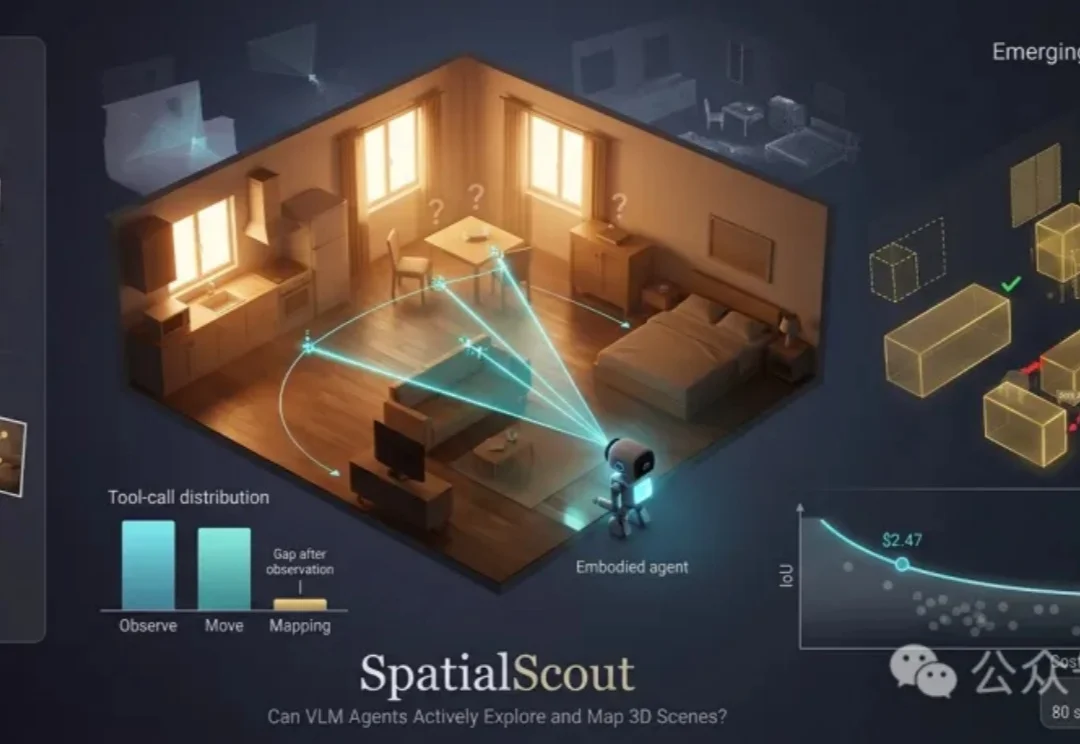
想象一项任务:把相机交给AI,让它进入一间从未见过的虚拟房间。没有预先给定的物体坐标,也没有替它安排好的参观路线。它需要决定朝哪里转、向哪里移动、何时再拍一张图,并最终说清楚各个目标物体在三维空间中的位置。