逼近Claude!中国黑马27B模型与OpenAI同榜
逼近Claude!中国黑马27B模型与OpenAI同榜就在上周,黄仁勋在高盛科技大会上说了一句让整个 AI 圈亢奋的话: 网络安全,很可能是 AI 的下一个杀手级应用。
来自主题: AI资讯
7431 点击 2026-09-16 15:35

 搜索
就在上周,黄仁勋在高盛科技大会上说了一句让整个 AI 圈亢奋的话: 网络安全,很可能是 AI 的下一个杀手级应用。
S²-VLA 引入信念状态和自适应动态门控,仅用2B参数、7GB显存,长程操控超越7B模型。

刚刚,阿里千问正式开源Qwen3.8-27B模型权重。Qwen3.8-27B是一款270亿参数的原生多模态稠密模型,支持图像、视频理解,原生上下文长度达到262K,并可通过YaRN扩展至100万Tokens。
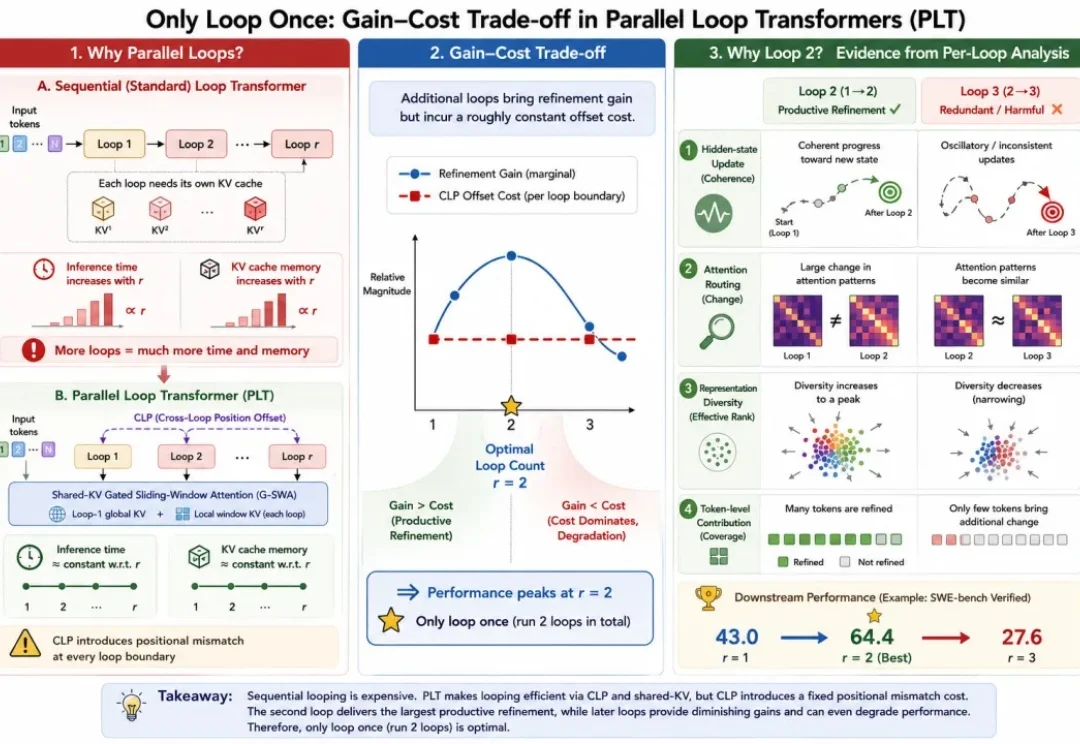
当所有人都在比谁「想得更久、算得更多」——推理模型动辄输出成千上万个思考 token,循环式架构恨不得在内部反复迭代十遍八遍——一项新研究反手泼了盆冷水:
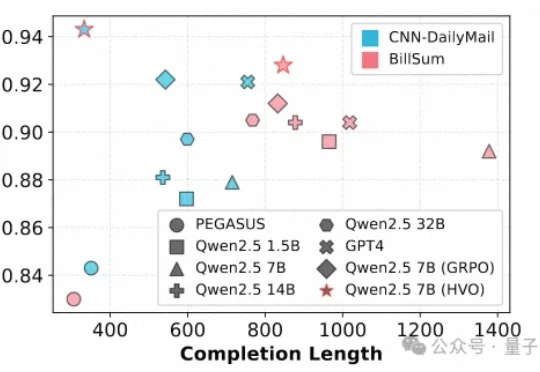
文本摘要作为自然语言处理(NLP)的核心任务,其质量评估通常需要兼顾一致性(Consistency)、连贯性(Coherence)、流畅性(Fluency)和相关性(Relevance)等多个维度。
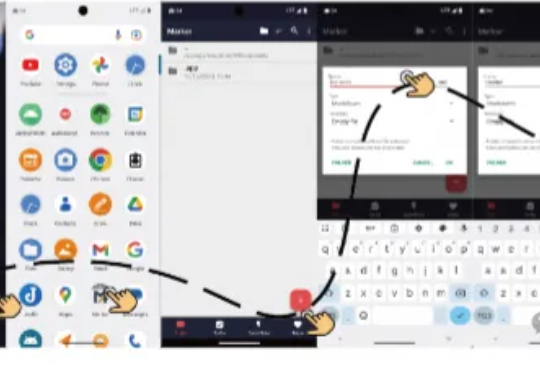
浙江大学与通义实验室Mobile-Agent团队在UI-R1的基础上,推出全新研究成果——UI-S1,提出了一种名为半在线强化学习(Semi-online Reinforcement Learning)的创新训练范式。
国产自研开源模型,让模型不用在快思考和慢思考间二选一了!
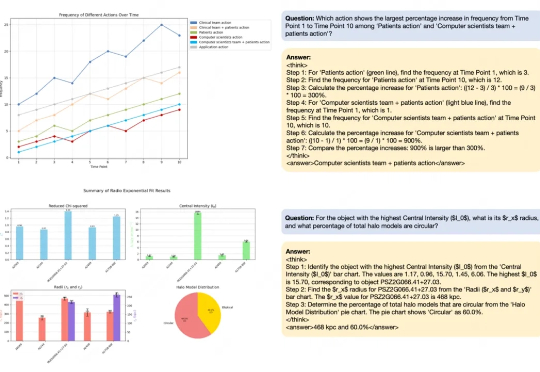
近期,随着OpenAI-o1/o3和Deepseek-R1的成功,基于强化学习的微调方法(R1-Style)在AI领域引起广泛关注。这些方法在数学推理和代码智能方面展现出色表现,但在通用多模态数据上的应用研究仍有待深入。
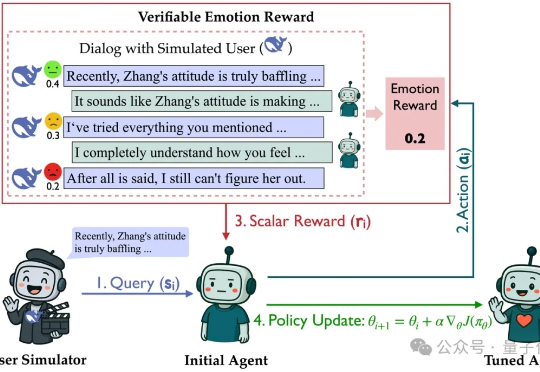
在没有标准答案的开放式对话中,RL该怎么做?多轮对话是大模型最典型的开放任务:高频、多轮、强情境依赖,且“好回复”因人而异。
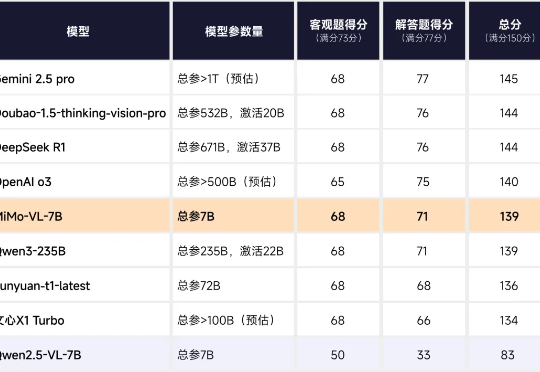
上上周的 2025 高考已经落下了帷幕!在人工智能领域,各家大模型向数学卷发起了挑战。