AI影视版WorkBuddy来了,AniShort把Codex装进本地工作台
AI影视版WorkBuddy来了,AniShort把Codex装进本地工作台AniShort推出原生本地架构的AI影视工作台,接入Codex等智能体,支持自动质检、自定义模型API、Skill复用及本地专业软件协同。
来自主题: AI资讯
9271 点击 2026-11-02 21:41

 搜索
AniShort推出原生本地架构的AI影视工作台,接入Codex等智能体,支持自动质检、自定义模型API、Skill复用及本地专业软件协同。
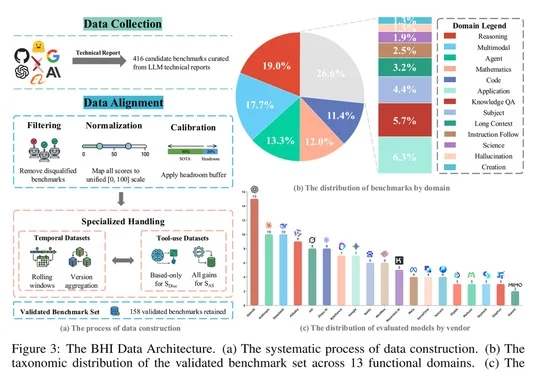
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
Claude Code团队成员Addy Osmani建议,随着模型能力提升,用户应精简提示词,以明确任务和验收标准让Claude自主推进,并定期清理旧提示、按任务规模使用子智能体与云端会话,同时加强结果核验。
近日,Manifold AI流形空间登顶机器人学习基准RoboDojo榜单(Agent Track),超越 GPT-6-Astra、英伟达 GR00T-N1.。其 WorldScape R²SI系统超过GPT-6-Astra、英伟达 GR00T-N1.7等模型,位列总榜第一。
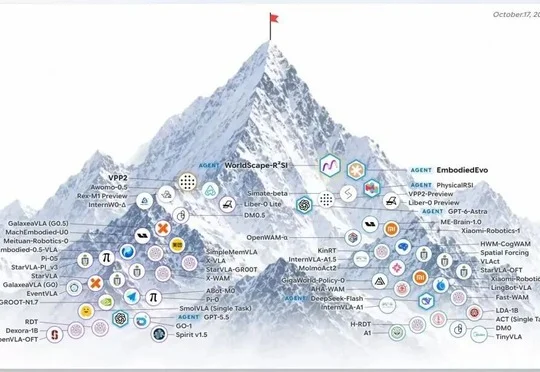
Manifold AI推出WorldScape R²SI,通过上下文学习与双层Agent持续改进能力登顶RoboDojo Agent Track总榜,超过GPT-6-Astra等模型。
Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
Caltech的Anima Anandkumar团队利用物理信息神经网络(PINN)和自研优化器,在三维无强迫欧拉方程自由空间中求得奇点候选解,缩放指数收敛至约0.5,但最终证明仍待完成。
OpenAI一款8月28日开始训练的内部模型已攻克100多道世界级数学难题,多伦多大学数学家Daniel Litt撰文指出,AI虽将大幅提升数学产出效率,但人类对数学的理解仍不可替代,数学教育与评价体系需重新定义,真正应被保留的是人与人之间的讨论、追问与理解。
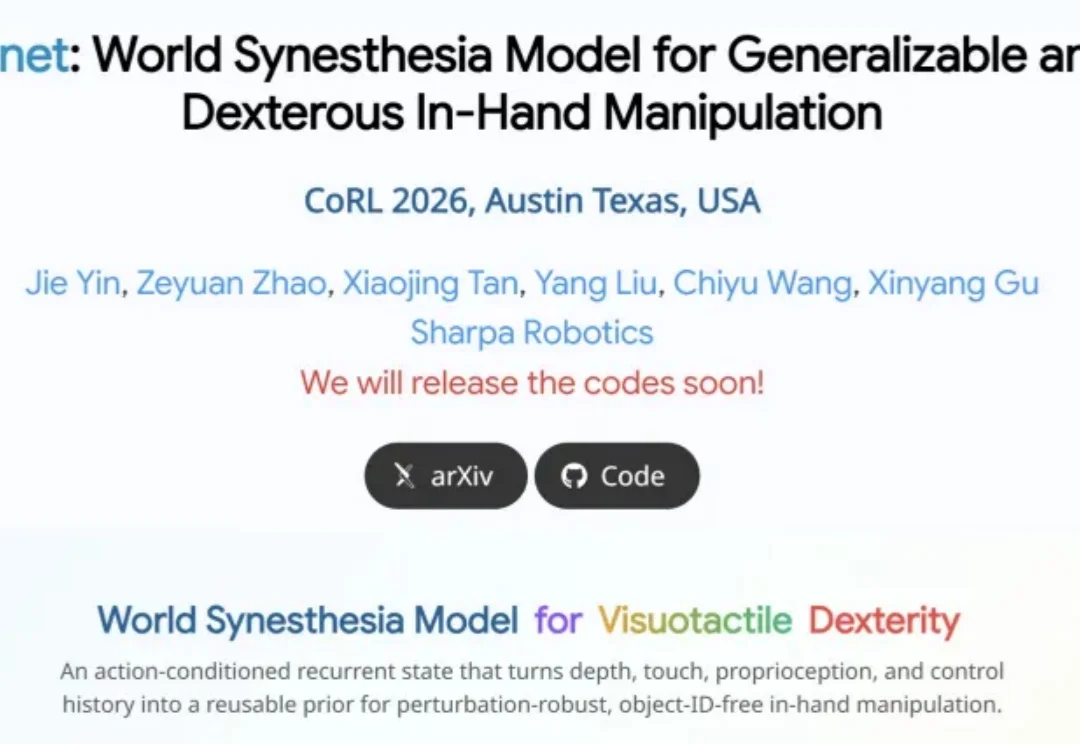
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。
由自学成才程序员Jan Zoltkowski创办的AI互动小说平台Janitor AI拥有250万日活用户和70%—80%的女性用户,公司仅由3名男性全职员工运营,近期上线每月12.99美元的Janitor+订阅服务。