AI资讯新闻榜单内容搜索-Ash

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Ash
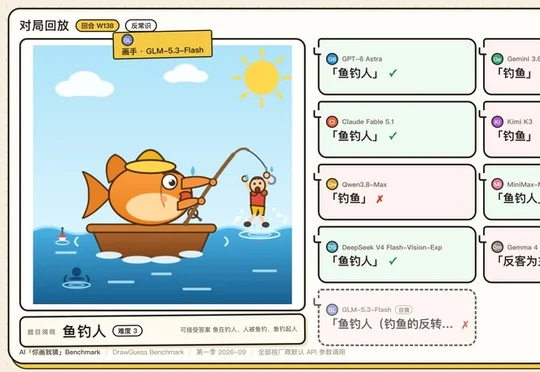
Eval丨 我们做了个“你画我猜 Benchmark” :1350 张图后,GPT-6 险胜

Eval丨 我们做了个“你画我猜 Benchmark” :1350 张图后,GPT-6 险胜

Eval丨 我们做了个“你画我猜 Benchmark” :1350 张图后,GPT-6 险胜

我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。

来自主题: AI技术研报
9452 点击    2026-09-06 11:05
谷歌让AI互怼几天!小模型竟复现3道博士级难题

谷歌让AI互怼几天!小模型竟复现3道博士级难题

谷歌让AI互怼几天!小模型竟复现3道博士级难题

谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。

来自主题: AI技术研报
5910 点击    2026-09-06 11:04
腾讯、字节、阿里「会战」AI 办公之后:Agent 领域格局已变

腾讯、字节、阿里「会战」AI 办公之后:Agent 领域格局已变

腾讯、字节、阿里「会战」AI 办公之后:Agent 领域格局已变

创新工场汪华与Floatboat.ai创始人谭少卿对话指出,腾讯WorkBuddy、字节豆包工作、阿里千问办公等大厂AI办公会战已完成Agent市场教育,GLM-5.3-Flash和DeepSeek-V4-Flash等国产模型跨过能力门槛,巨头的壁垒仅剩资金,而中国创业者凭借贴近开源模型生态的优势,有望在垂直Agent领域找到更多机会。

来自主题: AI资讯
6965 点击    2026-09-05 10:46
突发!Gemini 3.8登顶,谷歌迈出RSI一大步

突发!Gemini 3.8登顶,谷歌迈出RSI一大步

突发!Gemini 3.8登顶,谷歌迈出RSI一大步

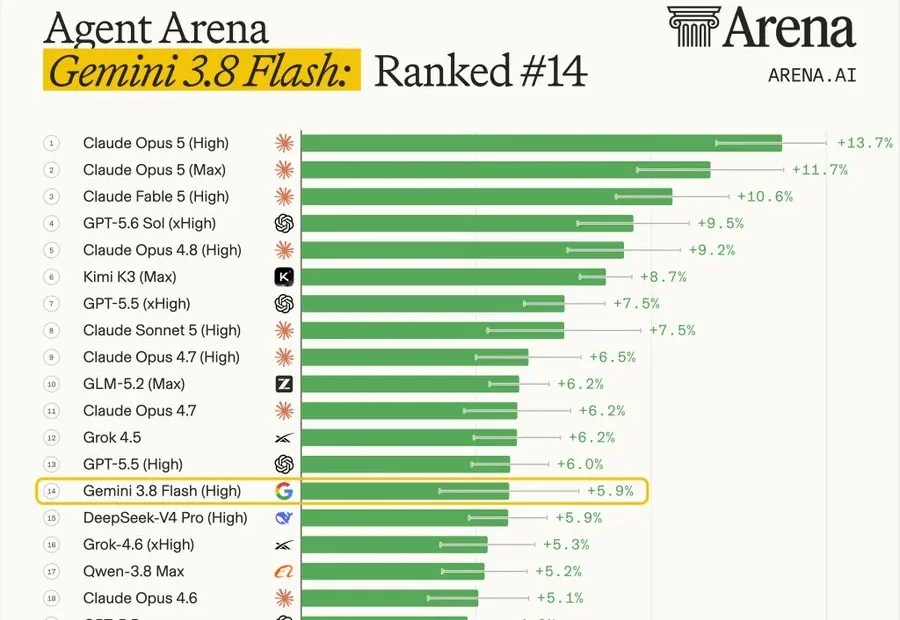
谷歌正式发布Gemini 3.8 Flash及网络安全专用版Gemini 3.8 Flash Cyber,前者以极低单任务成本在多项基准测试中逼近GPT-5.6 Sol、Grok 4.6等顶级模型,并在软件工程和速度上实现大幅跃升,后者则在漏洞发现基准CyberGym上以86.2%的成绩屠榜,谷歌DeepMind称这标志着RSI(递归自我进化)迈出了一大步。

来自主题: AI资讯
9795 点击    2026-09-03 09:27
Gemini 3.8,明日登场!

Gemini 3.8,明日登场!

Gemini 3.8,明日登场!

谷歌预告Gemini 3.8 Flash将于明日发布,并披露Gemini 3.7 Flash等模型已支持智能体视频理解,使Token消耗最多下降88%、成本最多下降66%、准确率最多提升7%。

来自主题: AI资讯
10507 点击    2026-09-02 23:20
刚刚,谷歌新模型全球登顶!

刚刚,谷歌新模型全球登顶!

刚刚,谷歌新模型全球登顶!

不得了。 谷歌刚刚更新的Gemini Omni 1.1 Flash,直接冲上了Arena文生视频全球第一。

来自主题: AI资讯
8452 点击    2026-09-01 11:14
刚刚,DeepSeek-V4多模态模型开源

刚刚,DeepSeek-V4多模态模型开源

刚刚,DeepSeek-V4多模态模型开源

DeepSeek-V4-Flash-Vision-Exp多模态模型正式开源,该模型为DeepSeek-V4系列首个实验性多模态模型,基于DeepSeek-V4-Flash架构集成视觉模块,在真实世界软件工程测试DeepSWE中以59.3%反超Opus-4.8登顶,并在零样本视觉推理测试ZeroBench中击败Opus-4.8。

来自主题: AI资讯
9579 点击    2026-08-31 21:53
实测比DeepSeek便宜的Qwen 3.8 Flash,卷飞了

实测比DeepSeek便宜的Qwen 3.8 Flash,卷飞了

实测比DeepSeek便宜的Qwen 3.8 Flash,卷飞了

阿里千问新模型,又卷出了新水平。

来自主题: AI产品测评
8000 点击    2026-08-31 10:21
「自验证」框架让开源模型反超 Fable 5,冲上 GitHub 热榜

「自验证」框架让开源模型反超 Fable 5,冲上 GitHub 热榜

「自验证」框架让开源模型反超 Fable 5,冲上 GitHub 热榜

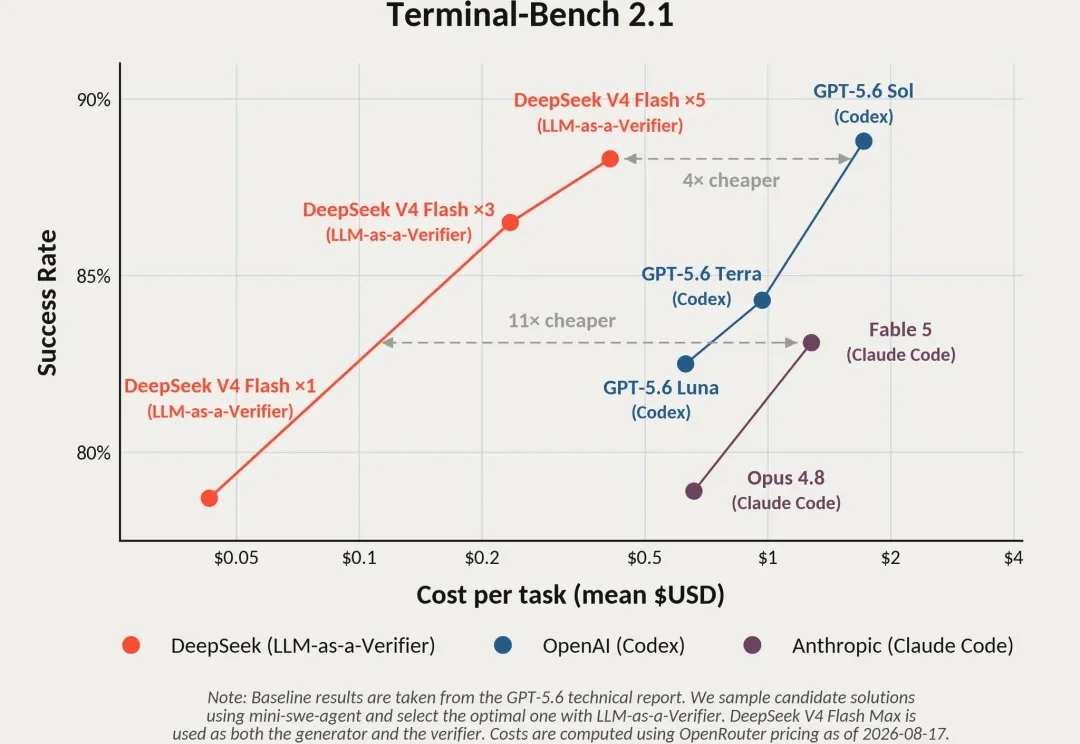
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。

来自主题: AI技术研报
6484 点击    2026-08-28 12:01