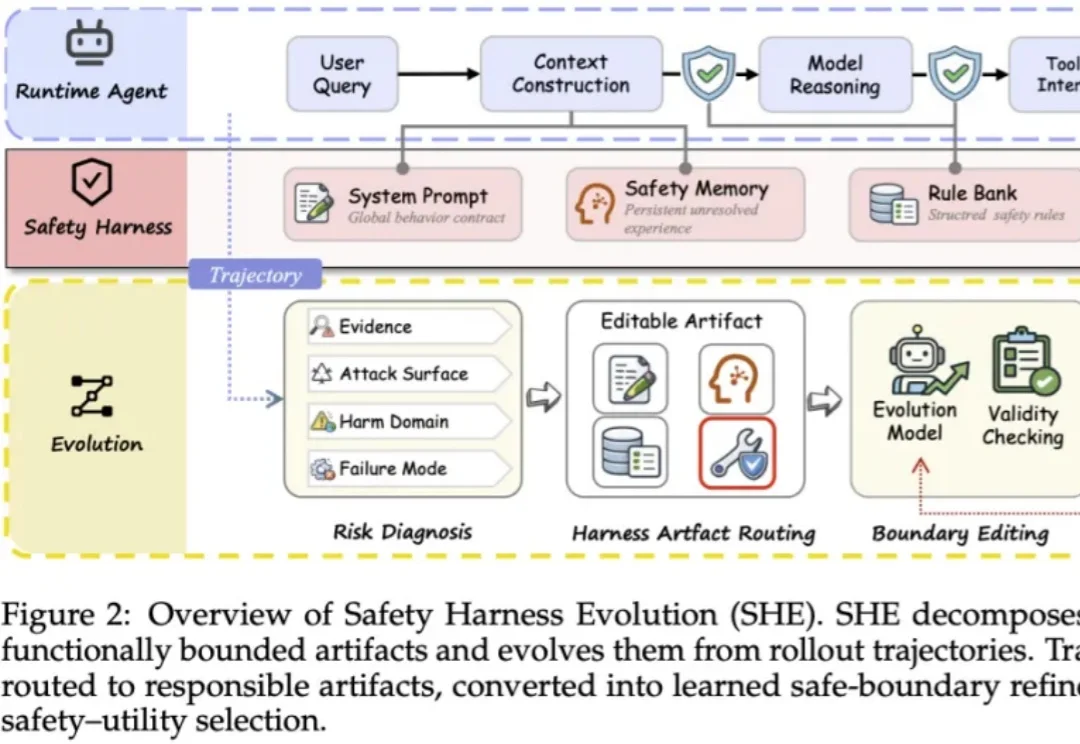
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
来自主题: AI技术研报
6918 点击 2026-09-17 14:55

 搜索
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。
43页财报一句话变带图表网页。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
今年2月,华尔街差一点就给SaaS办了场葬礼。
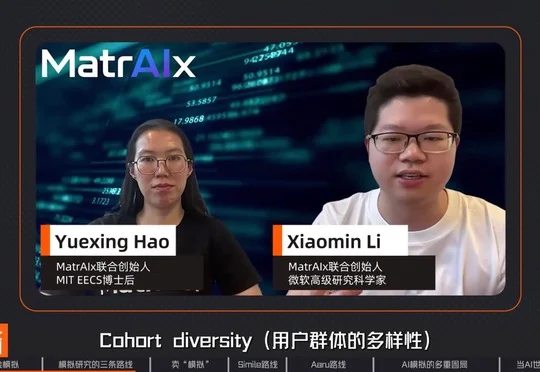
AI Simulation赛道持续升温,Simile估值达20亿美元、由00后创办的Aaru估值近10亿美元、MatrAIx构建83亿虚拟人格,企业通过让AI Agent模拟人类行为来测试产品和预测尚未发生的未来,但这门生意仍面临验证标准、预测精度和规模化等核心难题。
谷歌又杀回来了。
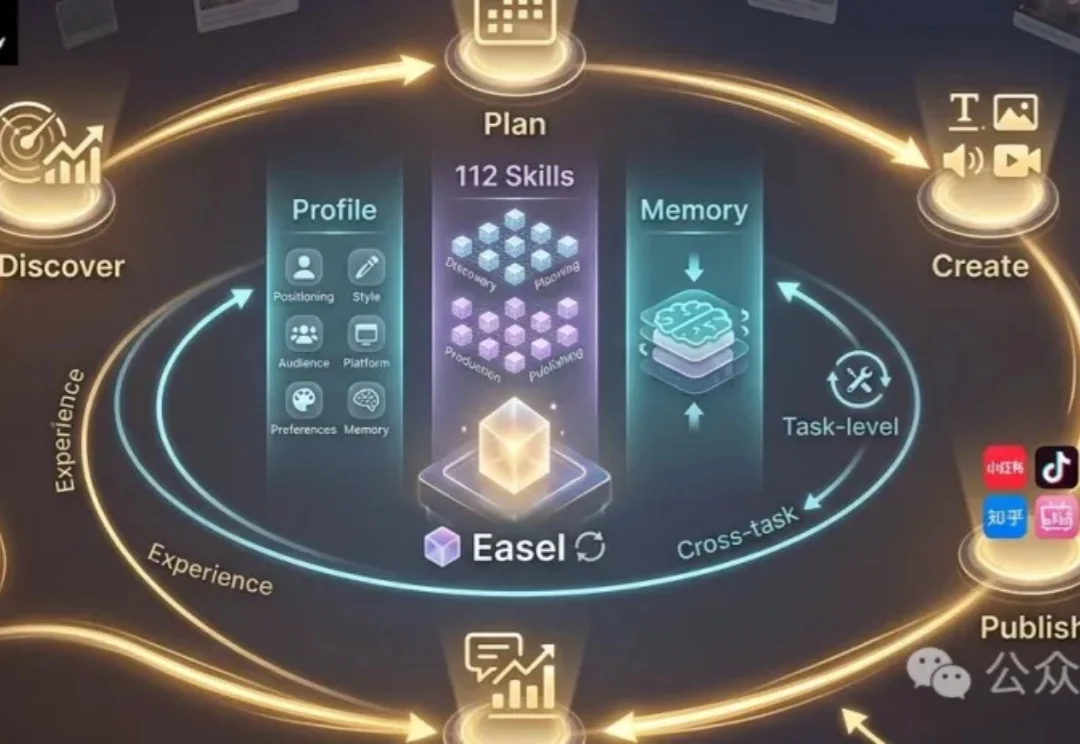
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
拿Agent做Coding,想必大家都已经很熟悉了。
一个 Agent 第一次没把任务做对。