全模态模型Qwen3.8-Omni-Flash发布
全模态模型Qwen3.8-Omni-Flash发布原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
来自主题: AI资讯
8455 点击 2026-09-18 17:29

 搜索
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
谷歌DeepMind疑似下一代旗舰模型Gemini 4 Pro以"gemini-3.8-flash"之名匿名亮相大模型竞技场Arena,在编码、智能体和推理等基准测试中全面超越Astra和Fable,并在网页设计、SVG、3D建模及游戏生成等实测中表现出色。
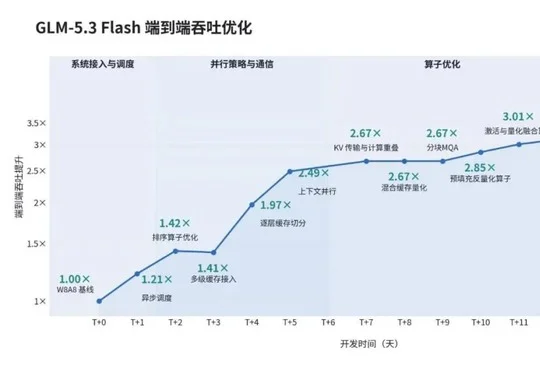
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
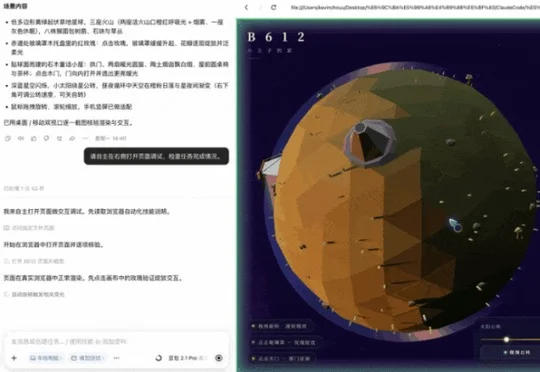
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
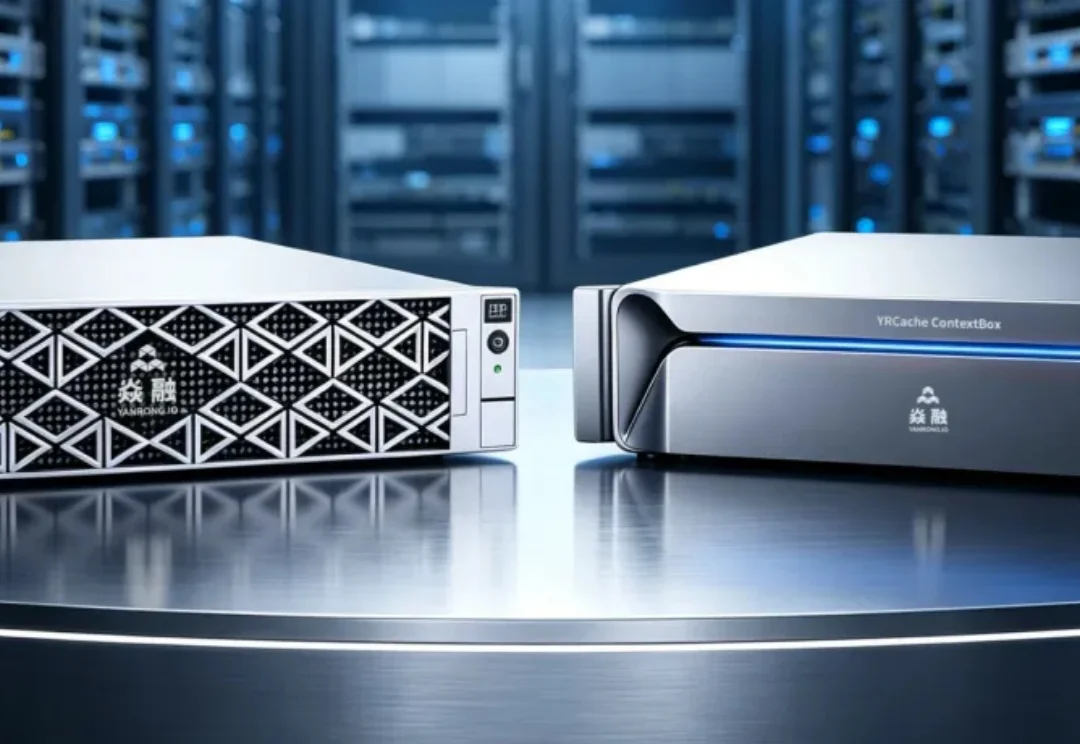
AI存储进入全流程竞争。
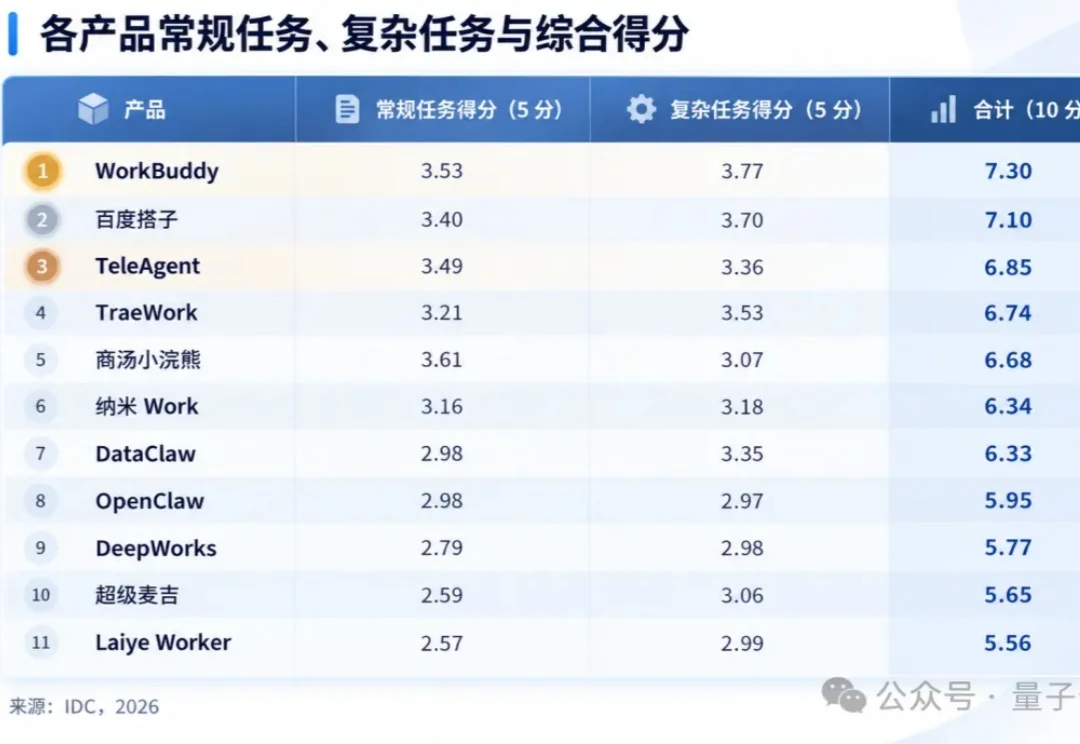
起猛了,央企做的企业级通用Agent,排进了国内前三!
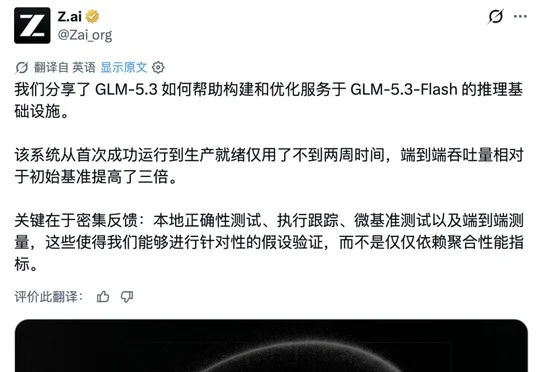
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
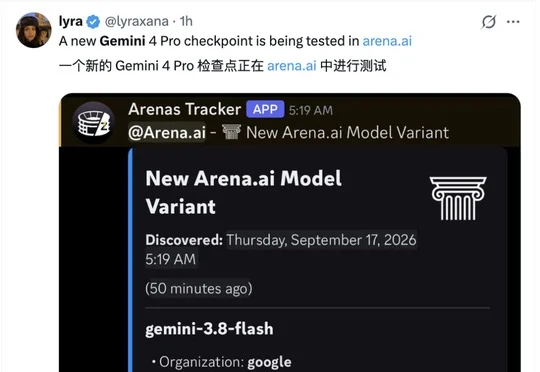
用户在Code Arena的battle模式中发现疑似Gemini 4 Pro新检查点(内部代号argon)伪装为gemini-3.8-flash进行盲测,据爆料其支持256K最大输出和2M上下文窗口,原定9月发布的Gemini 4 Pro已因预训练问题推迟至10月。
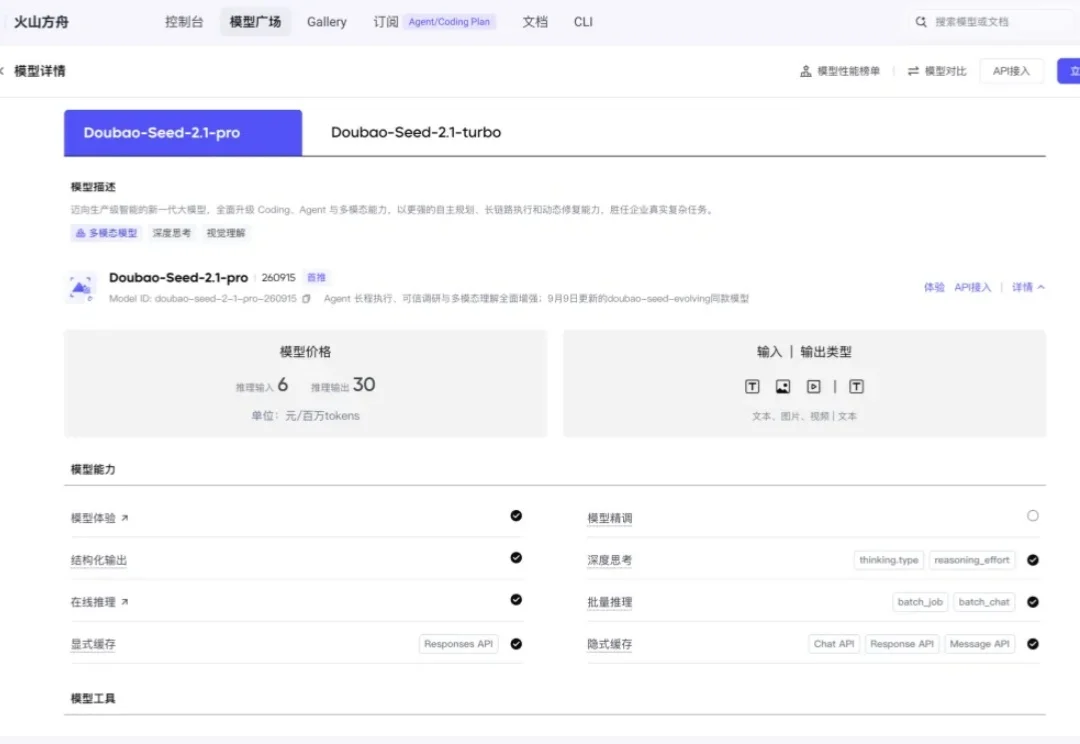
最近Seed-2.1-pro又更新了。