RSI热潮之下,自我迭代的国产Agentic Infra,卷向了英伟达GPU的物理极限
RSI热潮之下,自我迭代的国产Agentic Infra,卷向了英伟达GPU的物理极限无问芯穹(Infinigence AI)以国产Agentic Infra让GPU算子优化Agent登顶NVIDIA Research的SOL-ExecBench四项赛道,并通过Skills、共享Memory和隔离评测形成自我迭代闭环,揭示资源调度与工作流设计对RSI效率的影响。
搜索
无问芯穹(Infinigence AI)以国产Agentic Infra让GPU算子优化Agent登顶NVIDIA Research的SOL-ExecBench四项赛道,并通过Skills、共享Memory和隔离评测形成自我迭代闭环,揭示资源调度与工作流设计对RSI效率的影响。
天数智芯展示云端GPU天垓300、端侧产品彤央TY1200和天数智算软件栈,现场随机文生图测试中天垓300用时95.6秒、快于英伟达H200的112秒,TY1200在Qwen与Cosmos模型实测中性能超过Jetson Thor T5000。
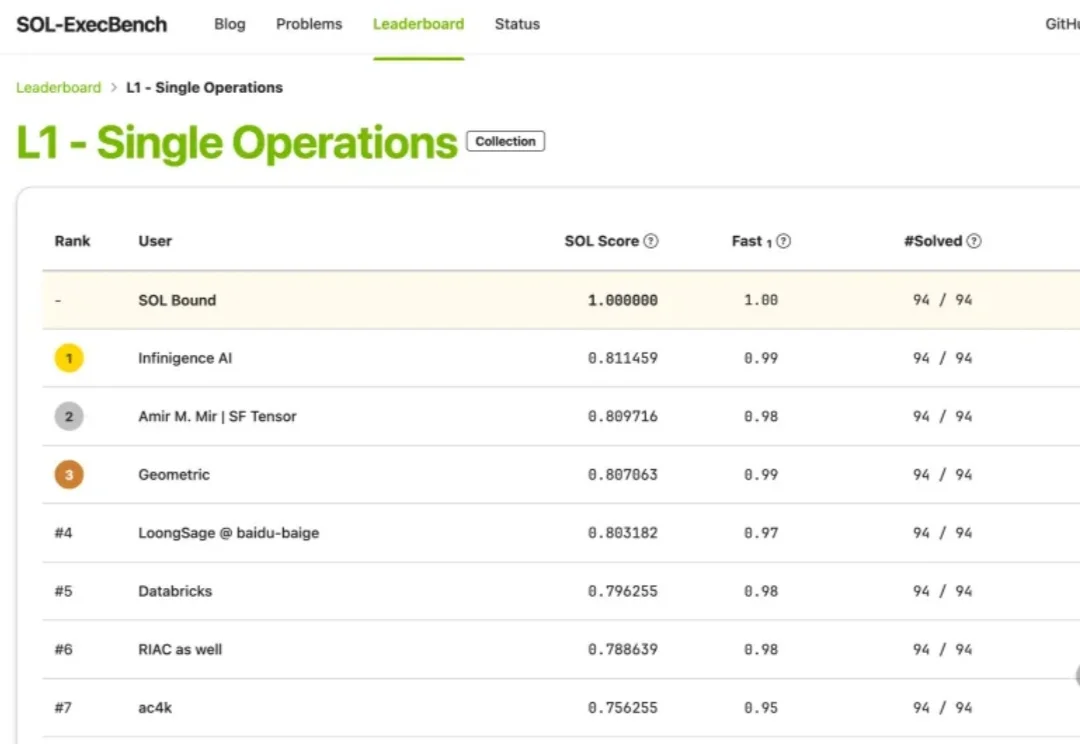
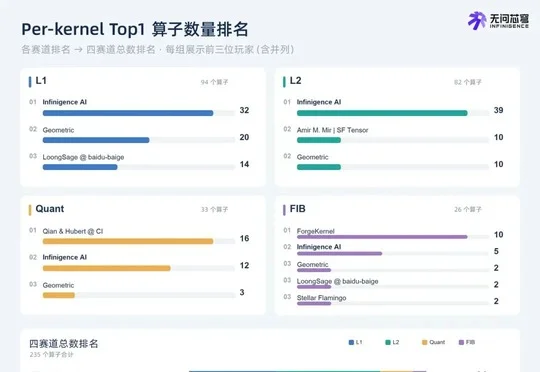
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
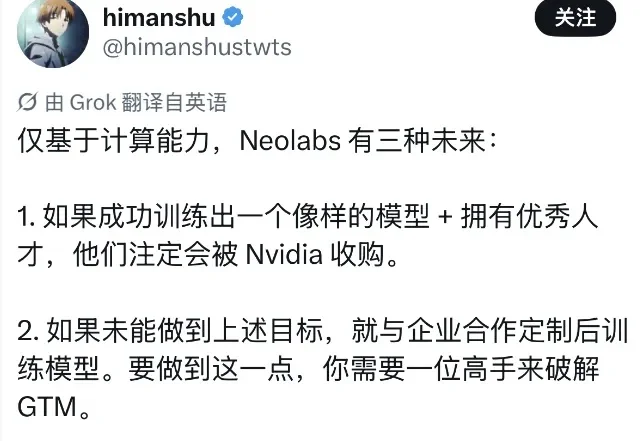
训不出模型的Neolab,开始倒卖GPU了。
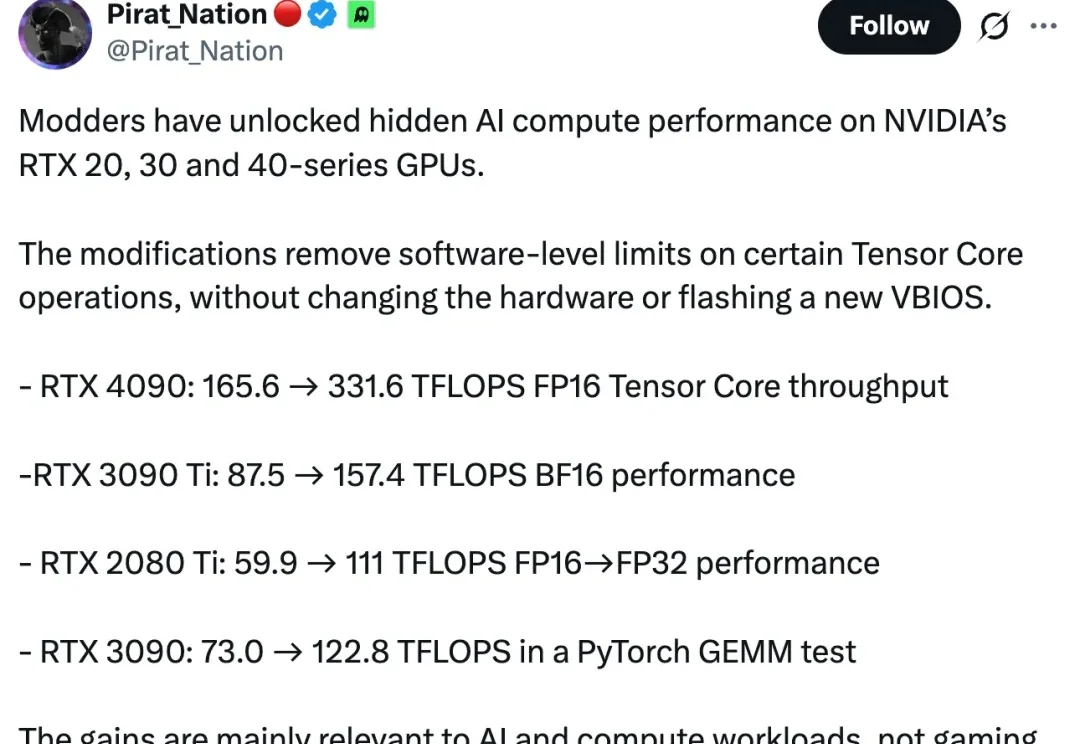
一张 RTX 4090,什么硬件都没换,特定 Tensor Core 运算吞吐率竟然从 165.6 TFLOPS 飙升至 331.6 TFLOPS,直接翻倍!
OpenAI首席执行官萨姆・奥特曼在内部员工会议上提出AI竞赛三种终局:建立全球监管机构、顶级实验室合并,或一家公司率先突破关键技术并有能力瘫痪竞争对手GPU;他反对这些结果,主张建立严格安全协议并独立评估先进AI系统。
什么!我没听错吧?
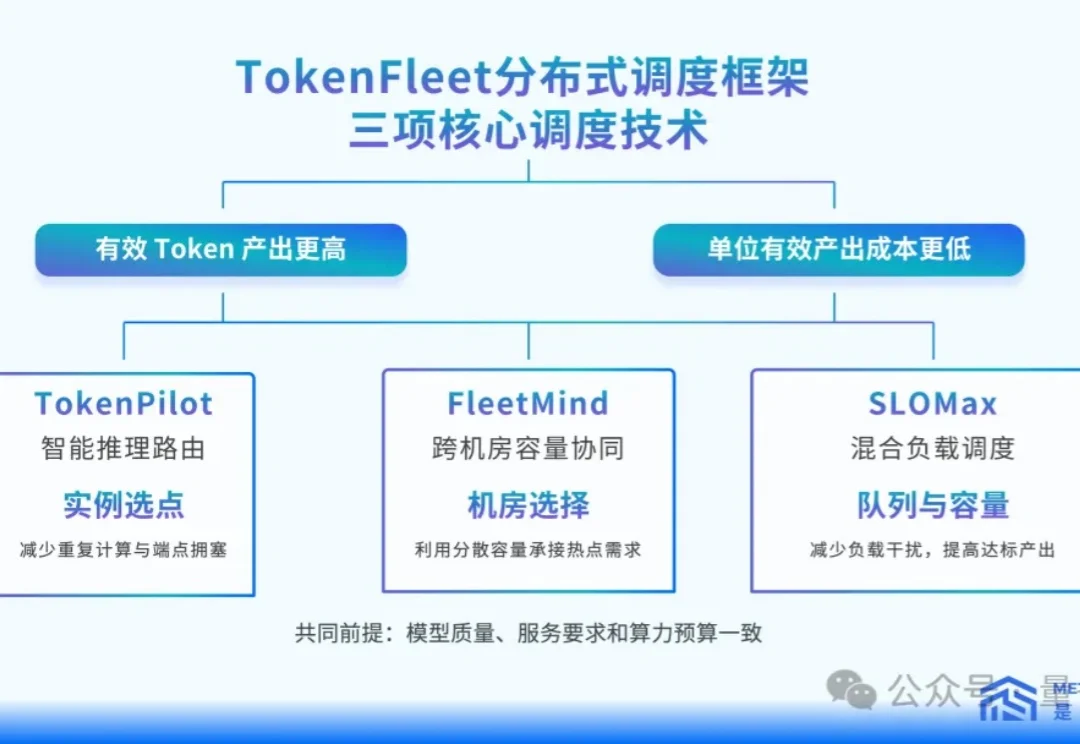
GPU集群里,请求排队和资源闲置,可能同时发生。
没招了!硅谷为了争夺AI算力已经彻!底!疯!狂!
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。