AI资讯新闻榜单内容搜索-ICL

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: ICL
TPAMI26 | 全面升级PolaFormer++:极性感知计算流 +通道级尖峰,实现线性注意力的新天花板

TPAMI26 | 全面升级PolaFormer++:极性感知计算流 +通道级尖峰,实现线性注意力的新天花板

TPAMI26 | 全面升级PolaFormer++:极性感知计算流 +通道级尖峰,实现线性注意力的新天花板

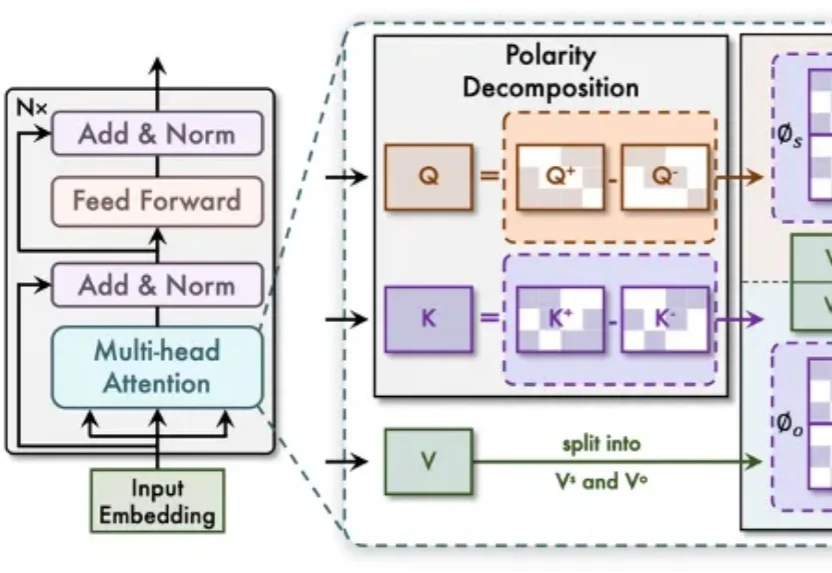
继 ICLR 2025 的 PolaFormer 之后,哈工大(深圳)与鹏城实验室合作的扩展版本 PolaFormer++ 近日被 IEEE TPAMI 正式接收。新版本在理论框架、特征映射设计和实验覆盖面上全面升级:首次给出判定特征映射是否具备「降熵尖锐性」的理论判据,并提出极性感知的通道级尖锐(PaCS)特征映射,在六大类视觉核心任务上全面验证了线性注意力的潜力。

来自主题: AI技术研报
8341 点击    2026-09-18 09:35
具身ICL来了创业玩家!上下文成Scaling新赛道

具身ICL来了创业玩家!上下文成Scaling新赛道

具身ICL来了创业玩家!上下文成Scaling新赛道

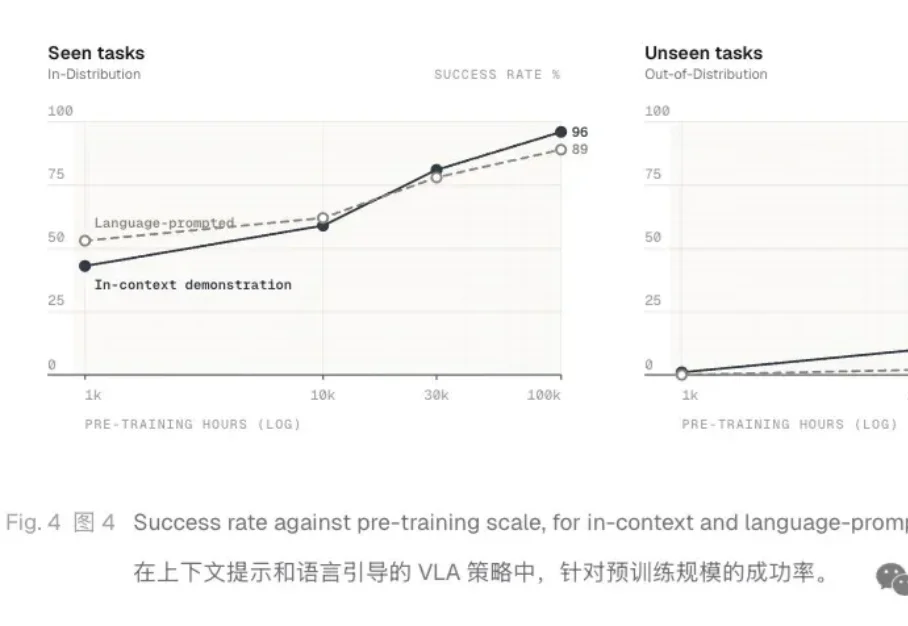
2020年,GPT-3靠“看几个示例就会新任务”震动了NLP界;六年后的今天,同样的故事正在具身智能领域上演。

来自主题: AI资讯
9638 点击    2026-09-07 10:47
Z Research|RSI产业图谱:一场围绕“智能进化速度”的新竞赛

Z Research|RSI产业图谱:一场围绕“智能进化速度”的新竞赛

Z Research|RSI产业图谱:一场围绕“智能进化速度”的新竞赛

2026年,Recursive Self-Improvement(RSI,递归式自我改进)开始从论文中的长期命题,变成了AI产业议程上一个新的赛道。学术界开始把RSI从分散研究方向变成一个独立议题。4月,ICLR首次为Recursive Self-Improvement(RSI,递归式自我改进)单独办了一场Workshop。

来自主题: AI资讯
10010 点击    2026-08-30 10:03
硅谷今日最热具身模型!不用后训练,看一遍就学会

硅谷今日最热具身模型!不用后训练,看一遍就学会

硅谷今日最热具身模型!不用后训练,看一遍就学会

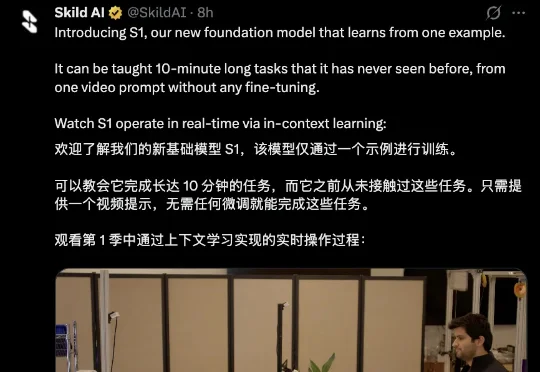
刚刚,北美具身初创Skild AI又发布了全新机器人基础模型S1,直接把机器人上下文学习的任务长度拉到了10分钟往上。这次的S1主打上下文学习(in-context learning,ICL):无需在后训练阶段专门学习新的操作数据,只需看一段人类示范视频,就能“照猫画虎”,直接完成一整套从未见过的复杂操作流程。

来自主题: AI资讯
9633 点击    2026-08-27 10:14
偷偷分享 DeepSeek Harness 热榜挖到的 2 个实⽤插件

偷偷分享 DeepSeek Harness 热榜挖到的 2 个实⽤插件

偷偷分享 DeepSeek Harness 热榜挖到的 2 个实⽤插件

太猛了,DeepSeek Harness 截至当前已经 112 k 的 Star 了,而这距发布仅仅过去三天。而且还在以惊人的速度增长...DeepSeek Harness 的核心就是:一切皆插件。说个不确切的比喻,有点 Agent 时代的 Obsidian 感觉了,自由度太高了。

来自主题: AI资讯
9301 点击    2026-08-16 21:58
刚刚,Claude偷偷上线隐形水印,每个字都可全球追踪!

刚刚,Claude偷偷上线隐形水印,每个字都可全球追踪!

刚刚,Claude偷偷上线隐形水印,每个字都可全球追踪!

8 月 2 日起,Claude 生成的每一段文字都将携带隐形水印。水印嵌在文本的统计分布里,复制粘贴也会被带走,部分编辑也抹不掉。Anthropic 周一在帮助文档中公布了这项计划。触发它的是欧盟 AI 法案 Article 50 的透明度要求——生成式 AI 提供商必须标记输出内容。

来自主题: AI资讯
9427 点击    2026-08-11 12:33
每人最多20篇?ICLR新规遭DeepMind研究者「反讽」请愿

每人最多20篇?ICLR新规遭DeepMind研究者「反讽」请愿

每人最多20篇?ICLR新规遭DeepMind研究者「反讽」请愿

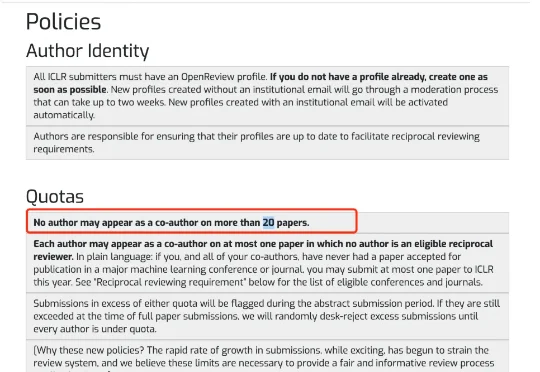
近日,ICLR 2027 公布新的投稿规则,明确规定,任何作者最多只能出现在 20 篇投稿的作者名单中,超出配额的论文会在摘要提交阶段收到提醒。如果到全文截止时仍未调整,会议将随机拒绝部分论文,直到每位作者都回到限额以内……

来自主题: AI资讯
8092 点击    2026-08-02 11:17
ICML 2026 Oral|大模型的能力从哪些训练数据来?北大&智源提出「机理数据归因」

ICML 2026 Oral|大模型的能力从哪些训练数据来?北大&智源提出「机理数据归因」

ICML 2026 Oral|大模型的能力从哪些训练数据来?北大&智源提出「机理数据归因」

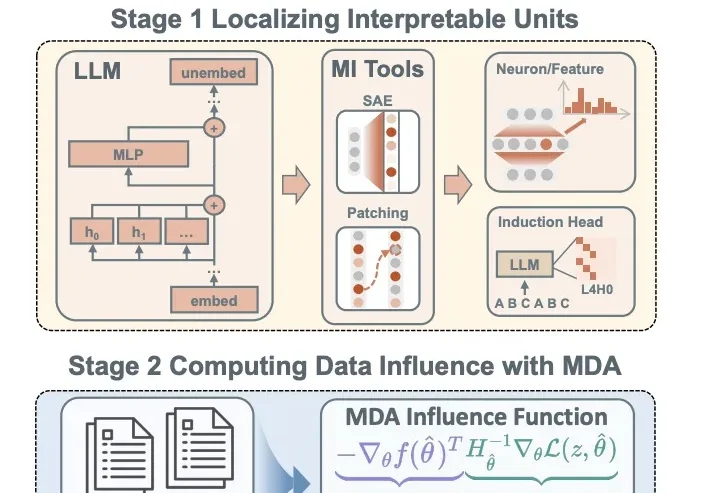
近年来,大语言模型展现出了越来越强的能力,从上下文学习(In-Context Learning, ICL)到复杂推理、代码生成,这些能力不断刷新人们对模型能力边界的认知。

来自主题: AI技术研报
9905 点击    2026-06-29 09:19