AI资讯新闻榜单内容搜索-OPD

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: OPD
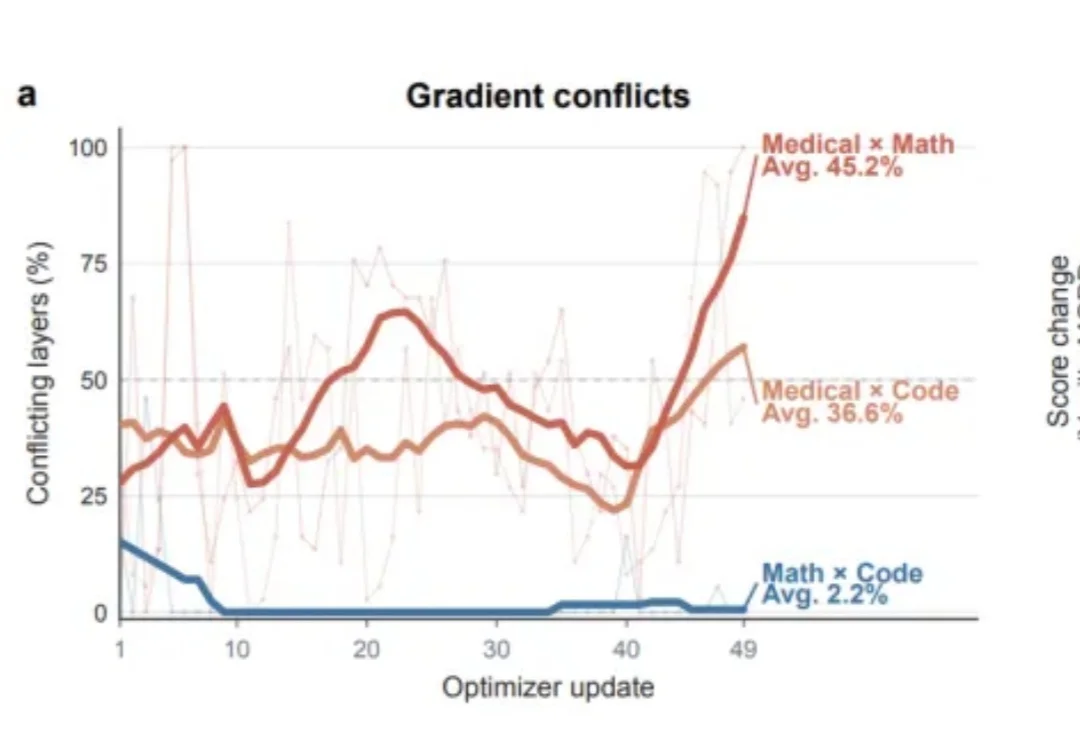
老师各有所长,合版却起冲突?京东×南大提出Road MOPD缓解风格与跨领域学习干扰

老师各有所长,合版却起冲突?京东×南大提出Road MOPD缓解风格与跨领域学习干扰

老师各有所长,合版却起冲突?京东×南大提出Road MOPD缓解风格与跨领域学习干扰

数学题交给数学老师,代码题交给代码老师,医学题交给医学老师。把各有所长的专家请到一起,就能让同一个小模型学会多种能力吗?

来自主题: AI技术研报
8767 点击    2026-11-02 15:33
蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD

蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD

蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD

清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
来自主题: AI技术研报
7190 点击    2026-10-31 12:08
万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
来自主题: AI技术研报
9099 点击    2026-10-04 22:03
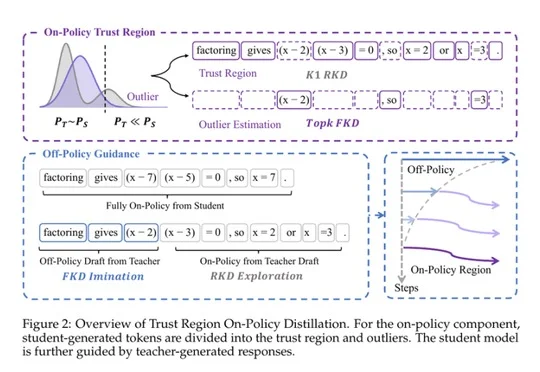
大模型Scaling撞上成本墙:三星提出TrOPD新方法,把前沿智能塞进数亿终端

大模型Scaling撞上成本墙:三星提出TrOPD新方法,把前沿智能塞进数亿终端

大模型Scaling撞上成本墙:三星提出TrOPD新方法,把前沿智能塞进数亿终端

三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
来自主题: AI技术研报
8871 点击    2026-09-18 15:48
清华团队再探 On-Policy Distillation:数据撑死,算法饿死

清华团队再探 On-Policy Distillation:数据撑死,算法饿死

清华团队再探 On-Policy Distillation:数据撑死,算法饿死

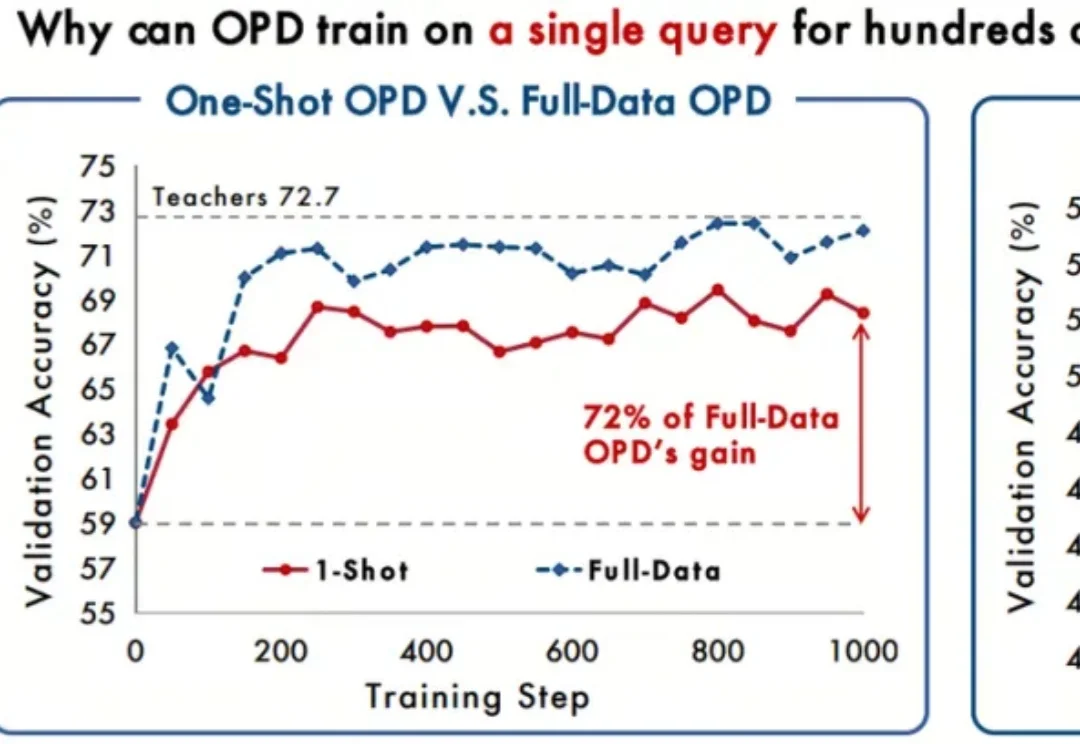
把 On-Policy Distillation(在线策略蒸馏,OPD)的训练集从 17000 道题删到 1 道,会发生什么?
来自主题: AI技术研报
10927 点击    2026-09-16 10:06
AI最尴尬的短板,中国科学院出手了

AI最尴尬的短板,中国科学院出手了

AI最尴尬的短板,中国科学院出手了

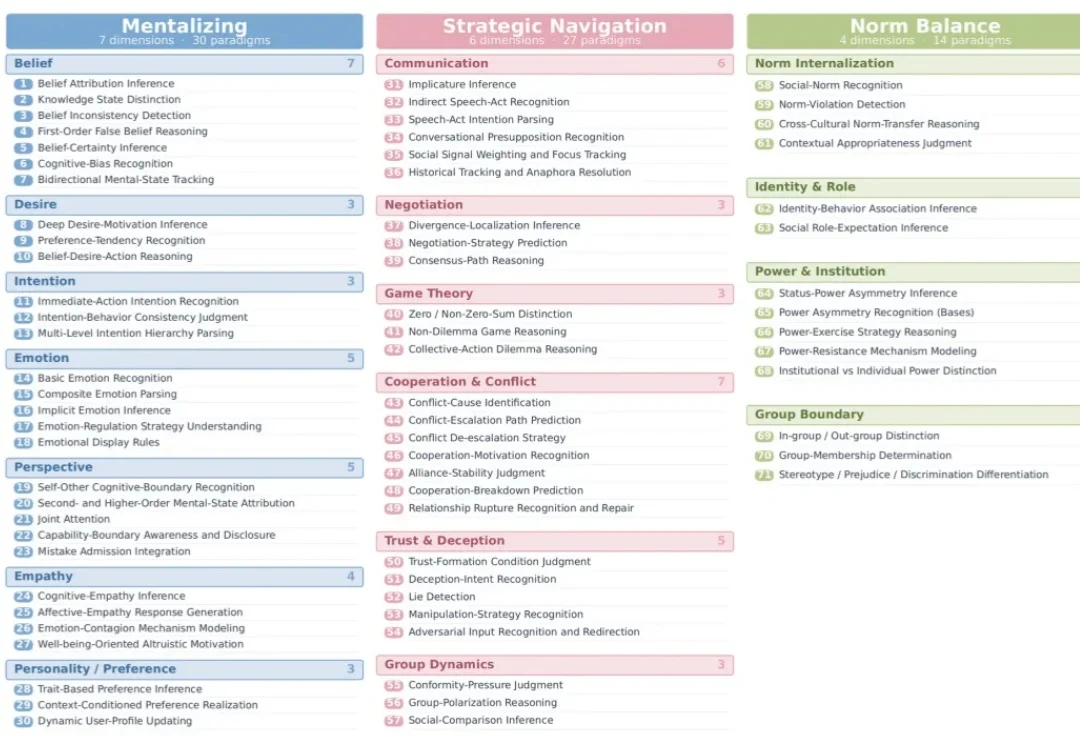
GPT-5.5能写专业论文,DeepSeek-V4-Pro能生成复杂代码,具身机器人能完成基础物理操作,语言智能和工具智能都已经跑出了自己的赛道。
来自主题: AI技术研报
8302 点击    2026-07-27 15:50
蒸馏效果起飞!DOPD破解「特权幻觉」,让在线策略蒸馏更有效

蒸馏效果起飞!DOPD破解「特权幻觉」,让在线策略蒸馏更有效

蒸馏效果起飞!DOPD破解「特权幻觉」,让在线策略蒸馏更有效

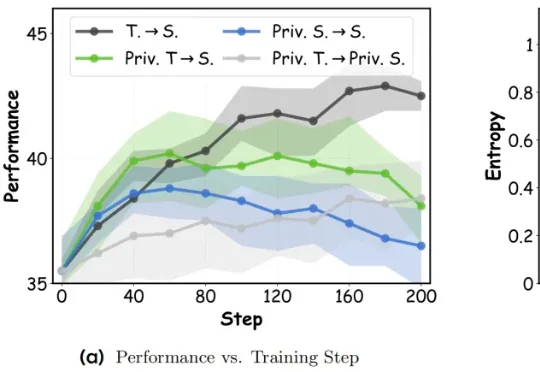
最近,来自新加坡国立大学、香港中文大学 MMLab、北京大学和京东探索研究院的研究团队提出了一种全新的在线策略蒸馏方法: DOPD (Dual On-policy Distillation) ,通过优势感知的双重蒸馏范式,成功破解了这一难题。
来自主题: AI技术研报
8741 点击    2026-07-09 09:48
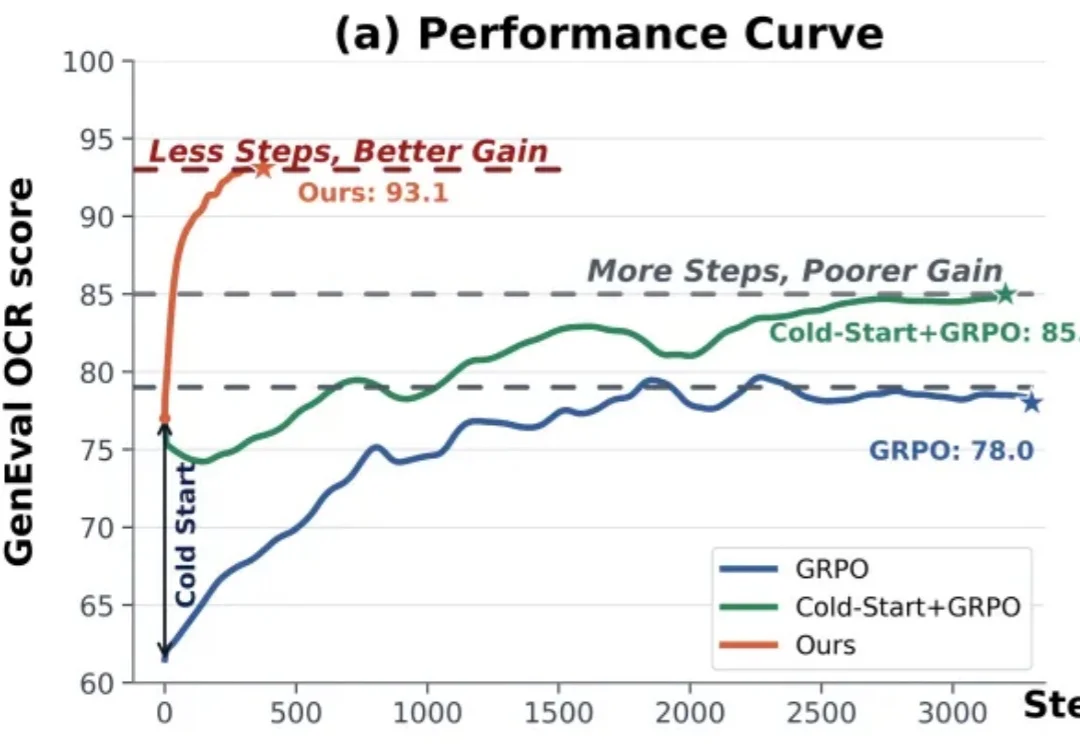
DiffusionOPD:复旦联合通义万相提出扩散模型「在线策略蒸馏」新范式,让学⽣模型同时学会构图、⽂字与美学

DiffusionOPD:复旦联合通义万相提出扩散模型「在线策略蒸馏」新范式,让学⽣模型同时学会构图、⽂字与美学

DiffusionOPD:复旦联合通义万相提出扩散模型「在线策略蒸馏」新范式,让学⽣模型同时学会构图、⽂字与美学

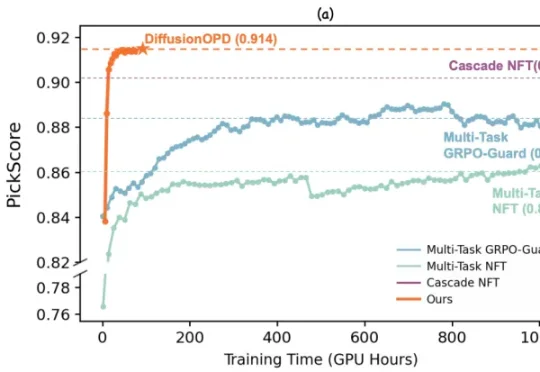
近期,来自复旦大学与阿里巴巴通义万相的研究团队对此提出了新的思考。他们认为,多任务强化学习不应被视为一个统一优化问题,而应该解耦为两个彼此独立的过程:单任务的在线策略探索 & 多任务能力整合。
来自主题: AI技术研报
9615 点击    2026-05-30 10:49
告别多奖励跷跷板:Flow-OPD将多教师OPD带入图像生成

告别多奖励跷跷板:Flow-OPD将多教师OPD带入图像生成

告别多奖励跷跷板:Flow-OPD将多教师OPD带入图像生成

今年以来,在线策略蒸馏 OPD(On-Policy Distillation)已经逐渐成为大厂 LLM 后训练中的重要组件,例如 DeepSeek-V4,GLM5 就使用了多教师 OPD 来整合不同领域专家模型的能力,相比混合奖励强化学习收敛更快、效果更好。
来自主题: AI技术研报
9219 点击    2026-05-26 10:07
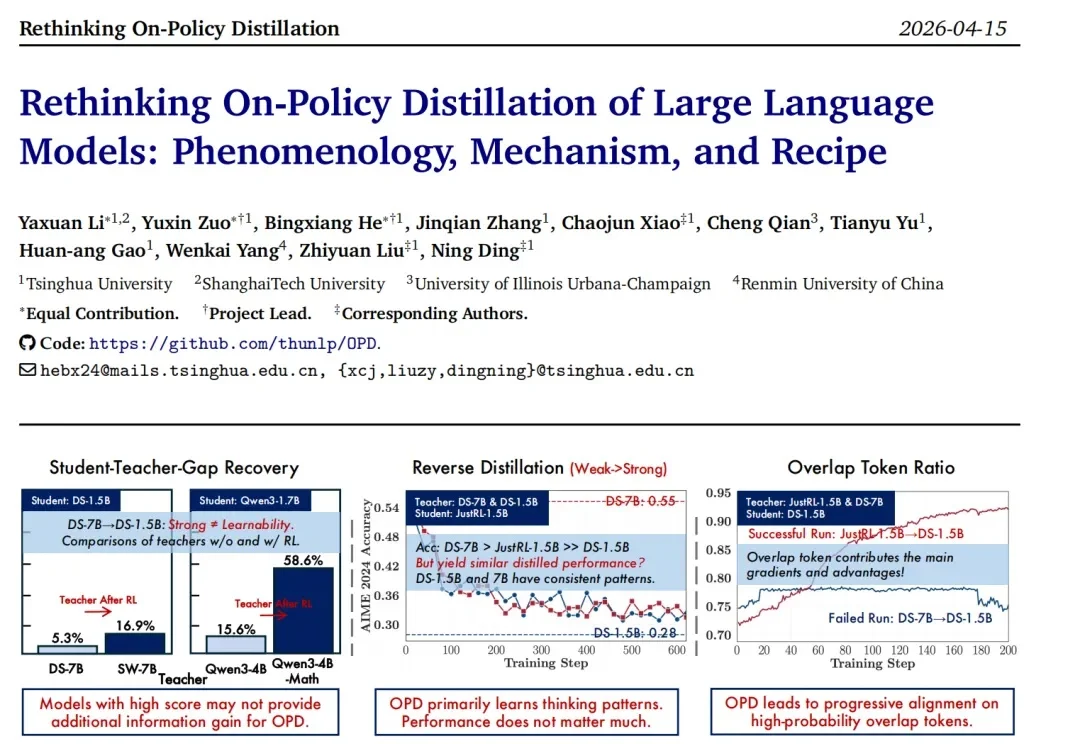
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。

来自主题: AI技术研报
11857 点击    2026-05-14 09:59