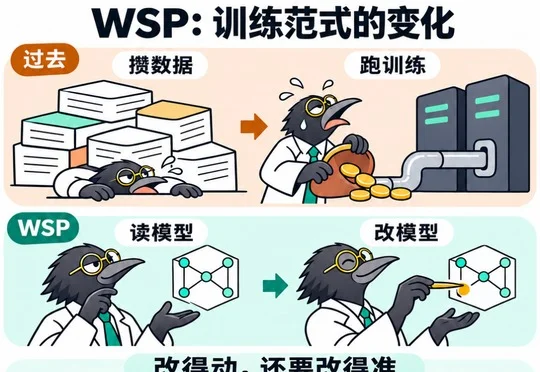
GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明
GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。
来自主题: AI技术研报
9304 点击 2026-11-08 14:49

 搜索
无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。

第一篇AI4AI综述论文将long horizon智能体、AI4AI与recursive self-improvement纳入同一研究地图,指出AI能在明确目标与评价规则下承担部分研发工作,但单项能力提升无法证明完整流程可靠,持续自我改进仍面临组合鸿沟等验证挑战。

网络安全初创公司Horizon3已完成2.5亿美元E轮融资,估值达到20亿美元,在14个月内估值增长逾三倍。这家总部位于旧金山的公司获得了老股东NightDragon和NEA的持续注资。
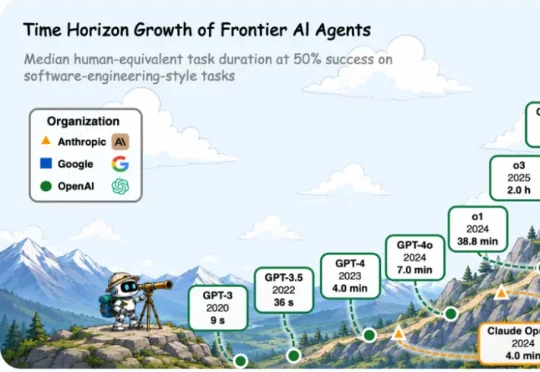
我们想强调的是:智能体 “跑得久”,并不等于 “具备长程能力”。真正的关键,不在于占用更多时间与算力,而在于能否在更长、更复杂、更真实的推理依赖链上持续、有效地行动。长期以来,Autonomous Agent、Self-Evolving Agent 等概念常与长程智能体混用。
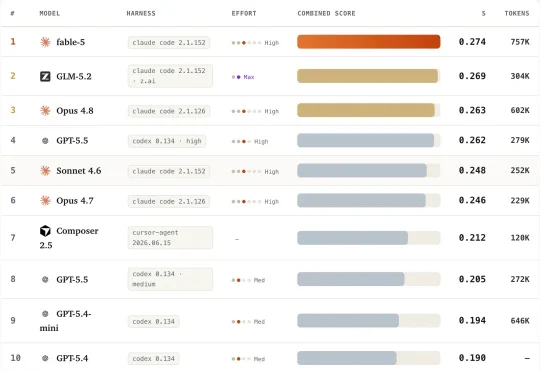
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
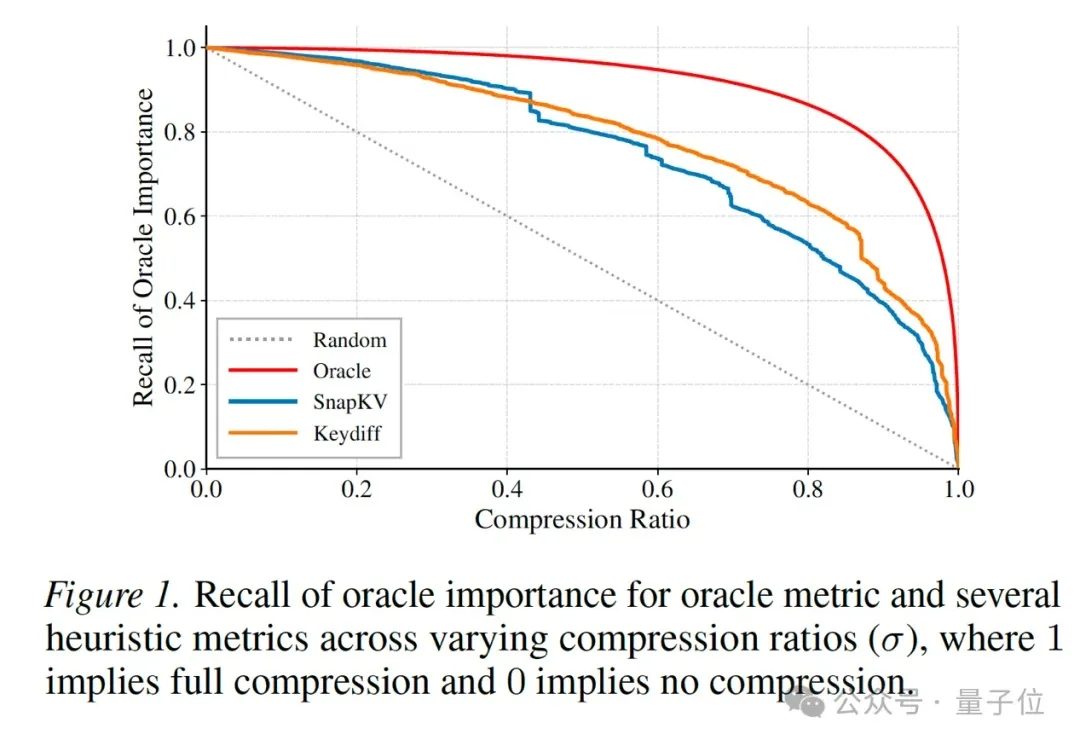
随着AI Coding、Agent、Deep Research 等应用快速普及,模型单次处理的上下文长度正在从几万Token迈向几十万甚至百万Token。
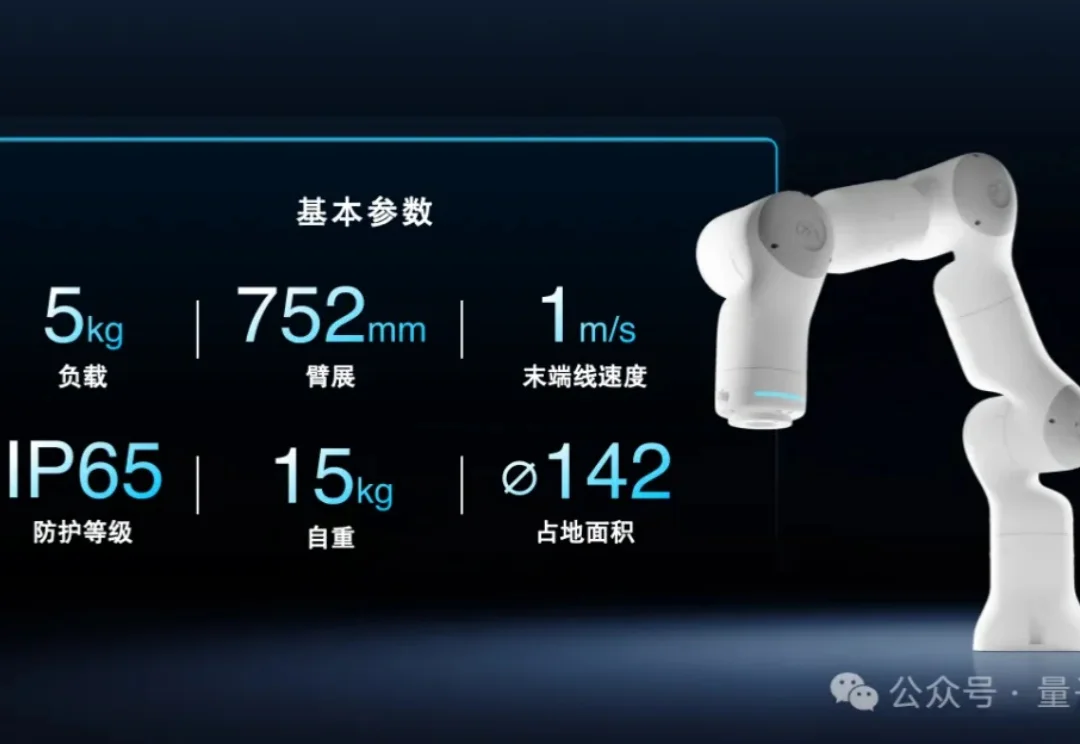
“对具身智能来说,力觉比视觉更重要。”
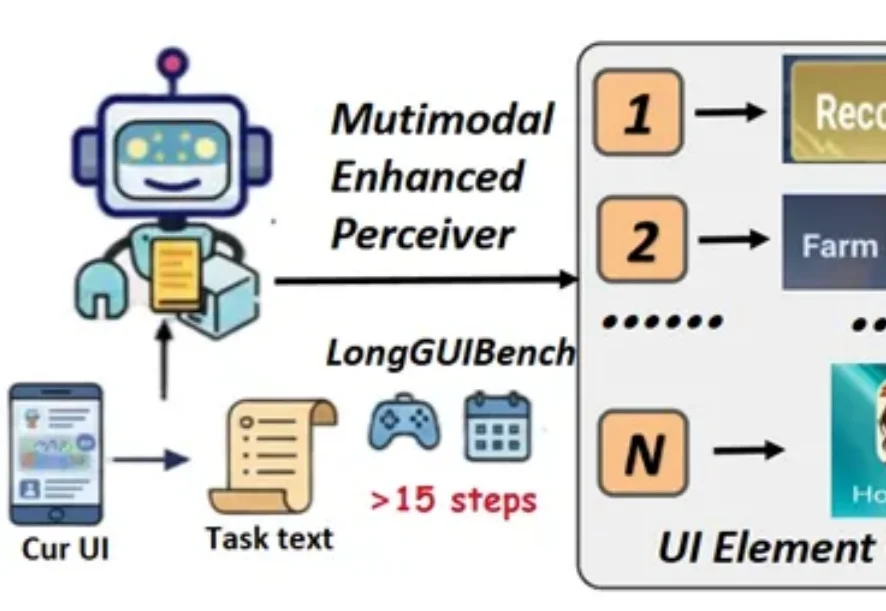
在移动端和桌面端的日常使用中,许多操作并非点一下按钮就能完成。预订一场会议、在游戏商城中购买并装备一件道具、又或者在多个应用之间完成一组连贯的工作流 —— 这些任务通常需要十几步甚至几十步的连续交互。
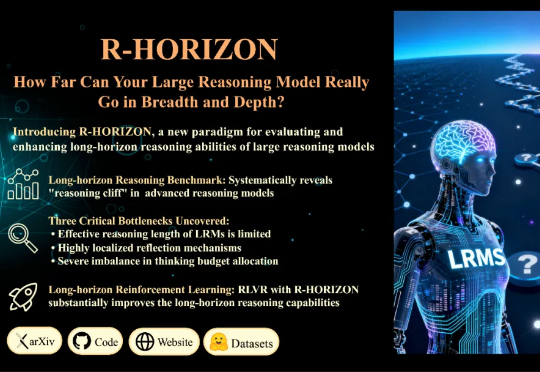
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。
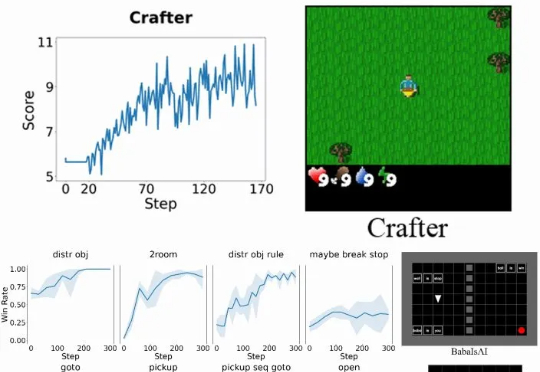
具体而言,Verlog 是一个多轮强化学习框架,专为具有高度可变回合(episode)长度的长时程(long-horizon) LLM-Agent 任务而设计。它在继承 VeRL 和 BALROG 的基础上,并遵循 pytorch-a2c-ppo-acktr-gail 的成熟设计原则,引入了一系列专门优化手段,从而在任务跨度从短暂交互到数百回合时,依然能够实现稳定而高效的训练。