jina-ocr-v1:在低成本 GPU 上更快解析文档
jina-ocr-v1:在低成本 GPU 上更快解析文档Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
搜索
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
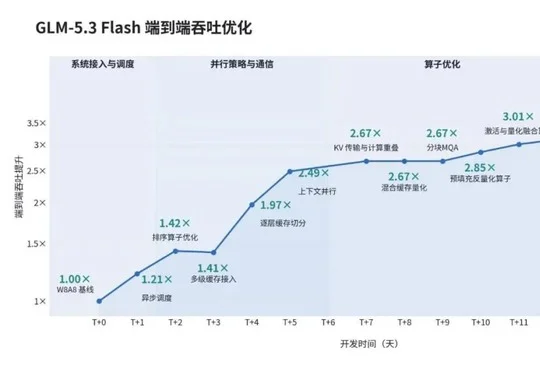
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
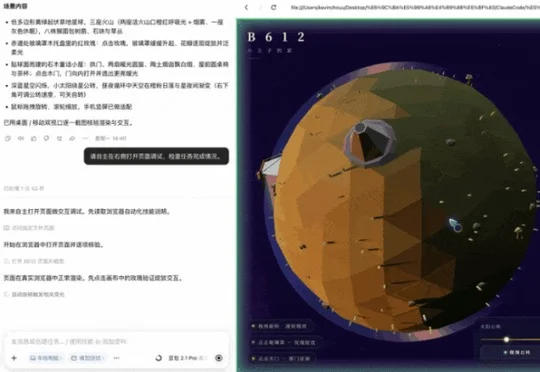
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
继“牛来”Ox Alpha 之后,OpenRouter 昨晚上又出现了一款身份不明的模型。
大模型一定要一个 token 接一个 token 地生成文字吗?
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
Token词元替代了Byte字节,但不意味着大模型都得是Token。
AI 的竞赛正在经历一次深刻的转向。过去两年,行业目光从“卷参数”转向“卷推理”,如今新的分水岭已经显现:AI 能否从数字世界走进物理世界,真正去“行动”?
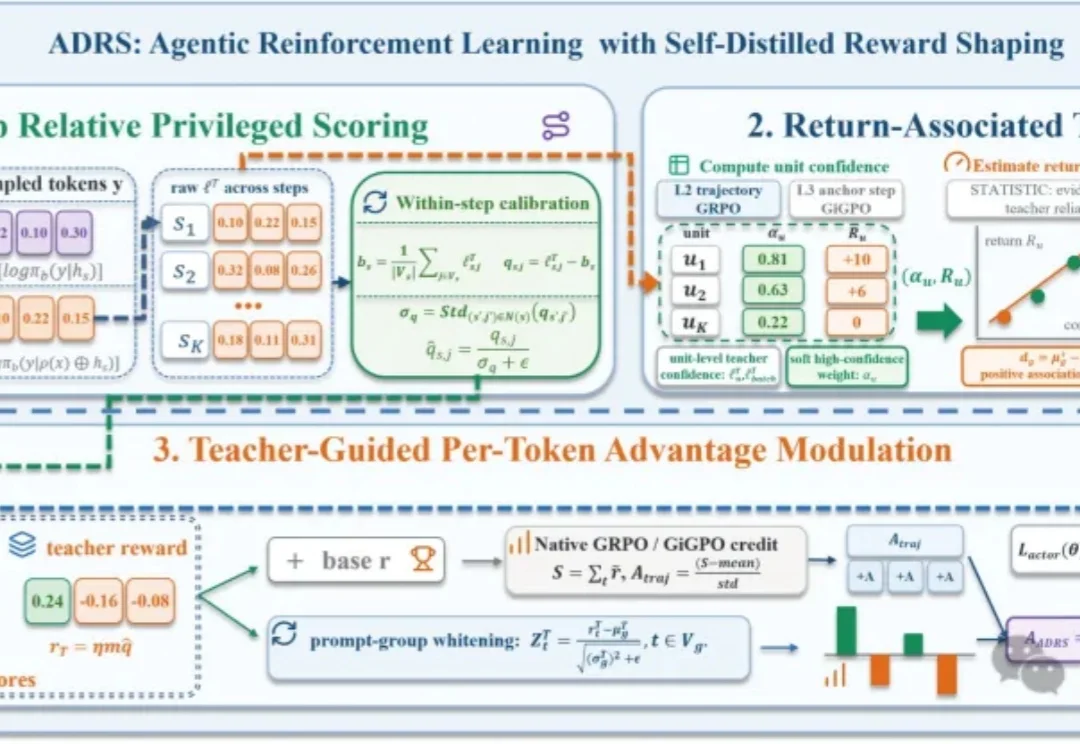
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。
清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。