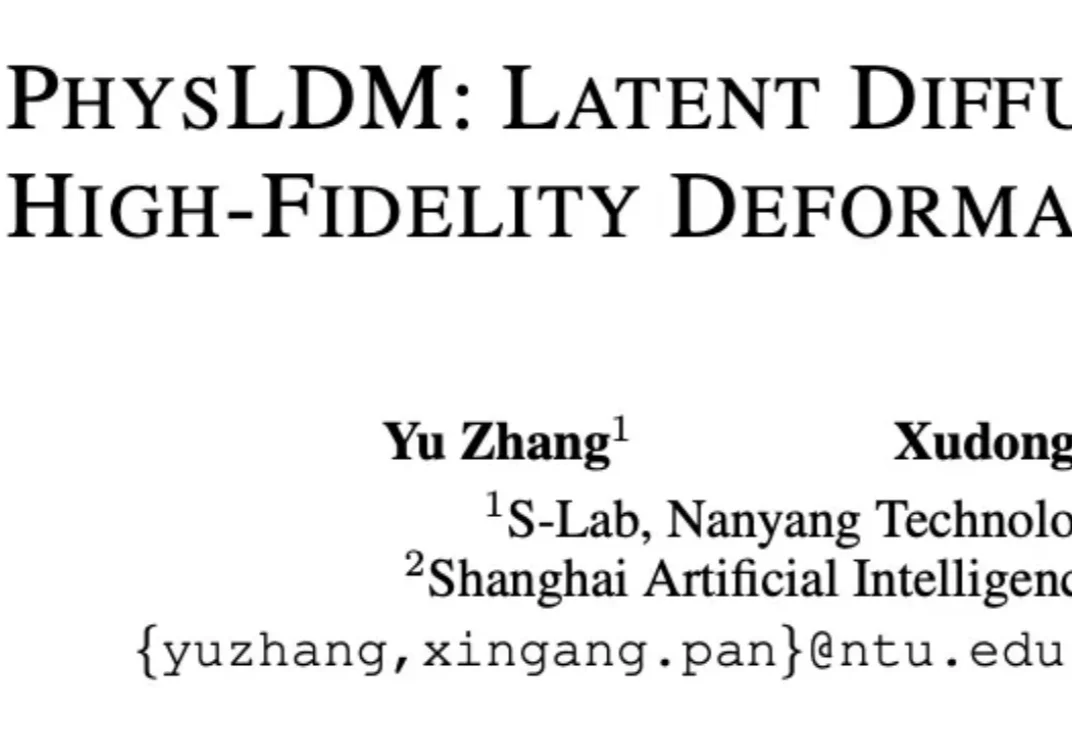
PhysLDM | 物理仿真的Latent Diffusion范式,革命传统物理仿真
PhysLDM | 物理仿真的Latent Diffusion范式,革命传统物理仿真过去几年,神经网络接连改写了一个又一个领域:图像生成有了 Stable Diffusion,视频生成已经能做到以假乱真,就连 3D 渲染也出现了 RenderFormer 这样的纯神经网络方法。但在高保真物理仿真上,神经网络始终没能交出令人满意的答卷,游戏、动画和机器人领域至今仍依赖需要手动调参、难以求梯度的传统求解器。
搜索
过去几年,神经网络接连改写了一个又一个领域:图像生成有了 Stable Diffusion,视频生成已经能做到以假乱真,就连 3D 渲染也出现了 RenderFormer 这样的纯神经网络方法。但在高保真物理仿真上,神经网络始终没能交出令人满意的答卷,游戏、动画和机器人领域至今仍依赖需要手动调参、难以求梯度的传统求解器。
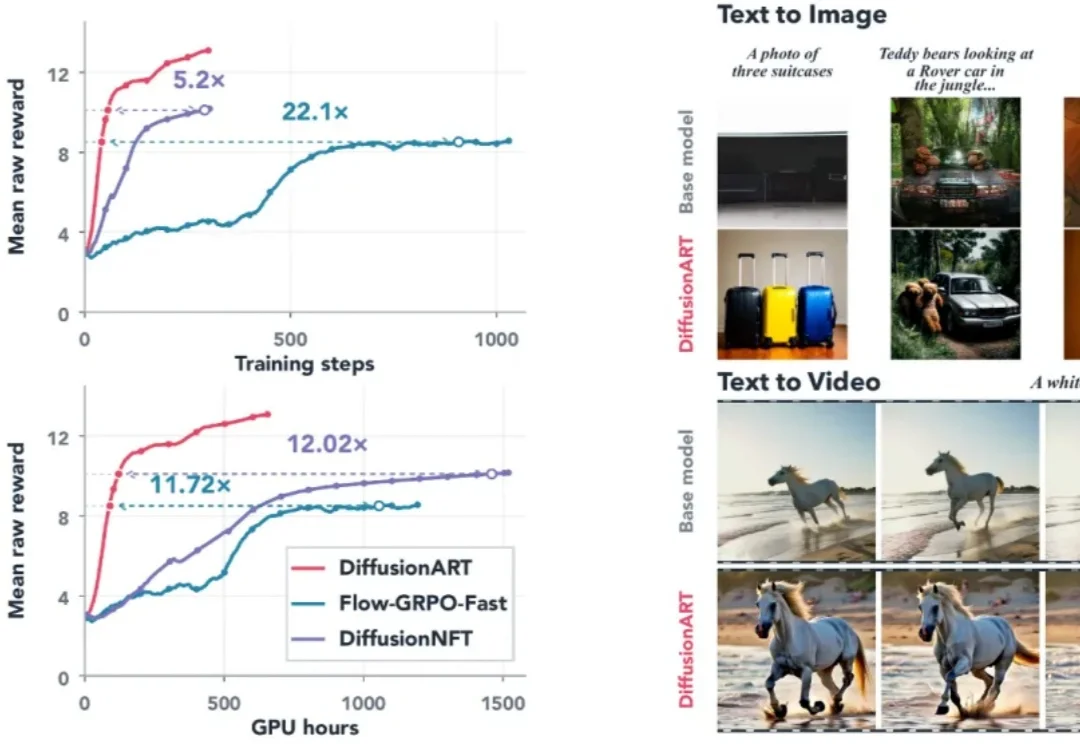
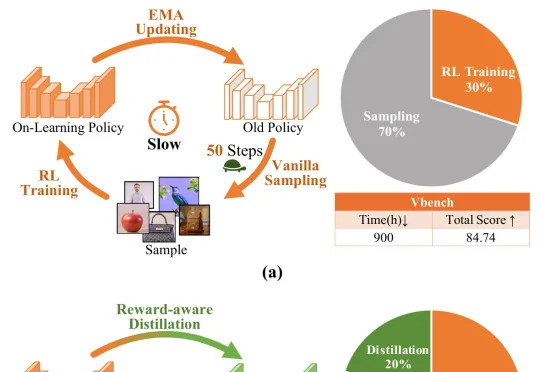
来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。
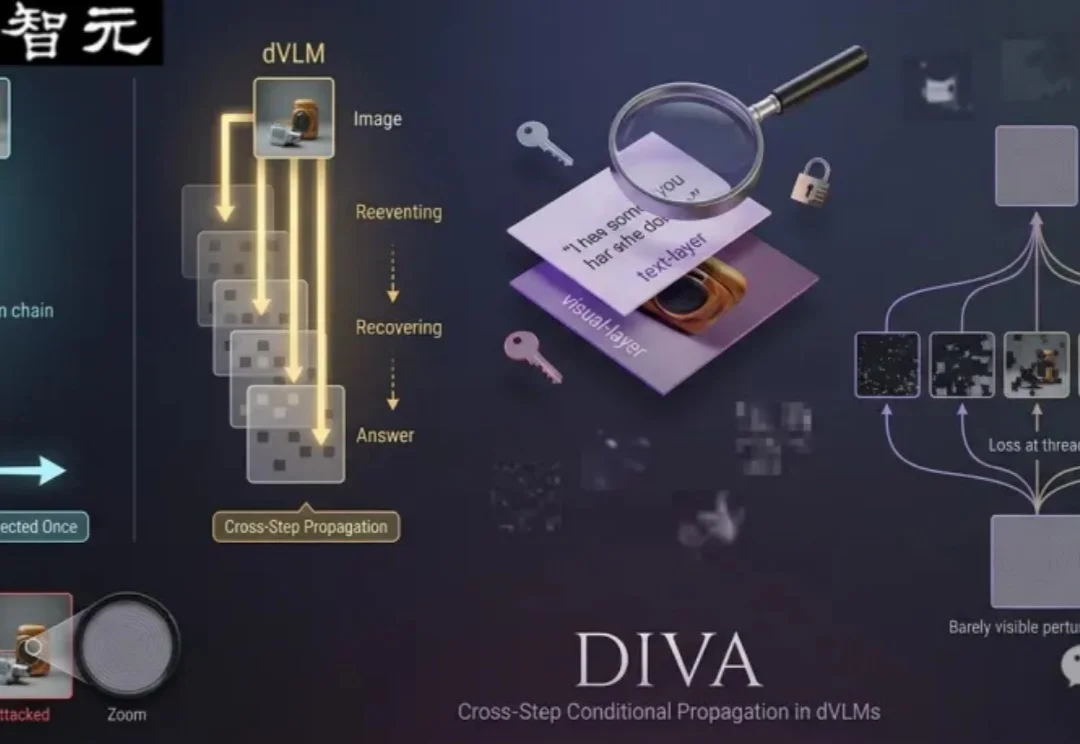
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
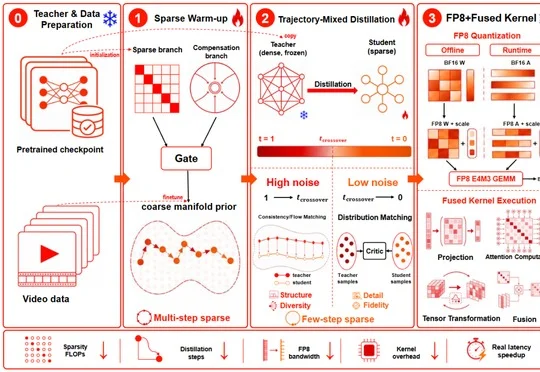
北京大学、清华大学与阿里巴巴等机构联合提出SparkDiffusion视频生成加速系统,通过融合稀疏注意力、少步蒸馏与FP8量化,在单卡RTX 5090上实现最高720倍推理加速,可在18秒内生成5秒720P视频,并已完整开源权重与训练代码。
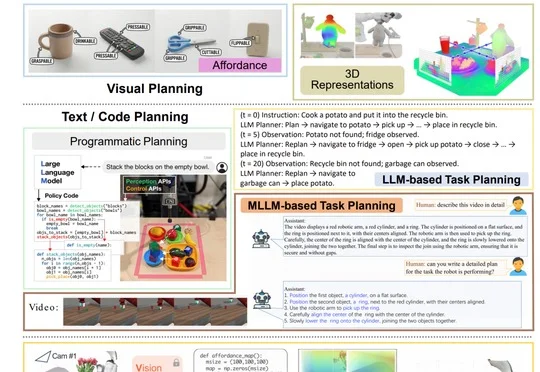
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
袁博地的答案是否定的。从清华大学接触计算机视觉,到 UC Berkeley 攻读 AI 博士,再到 Google X 负责机器人的视觉系统,袁博地过去十多年的研究几乎始终围绕 Pixel 展开:从图像识别,到 GAN、Diffusion,再到图像和视频生成,技术范式不断变化,研究对象却始终指向同一件事——如何让机器理解和生成视觉世界。
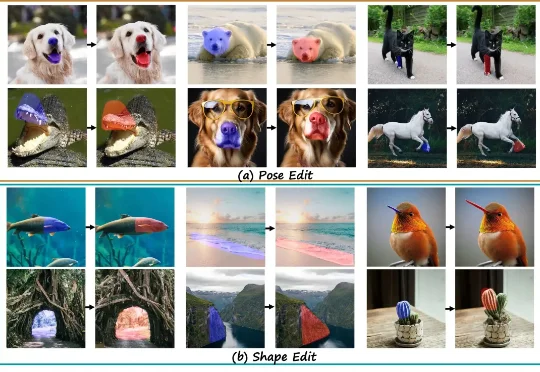
还在用 DragGAN、DragDiffusion 拖拽修图?点选拖拽容易变形、边界割裂、细节丢失的时代落幕了!ECCV 2026 ICRDrag 首创上下文区域拖拽模型,用掩码精准定位局部区域,移动、缩放、变形全都丝滑自然,兼顾精准度与画面真实感。