得到大脑发布AI录音台和4.0版本:聊聊发布会背后我的思考
得到大脑发布AI录音台和4.0版本:聊聊发布会背后我的思考AI真正的瓶颈,是个人上下文。
来自主题: AI资讯
8792 点击 2026-10-21 11:05

 搜索
AI真正的瓶颈,是个人上下文。
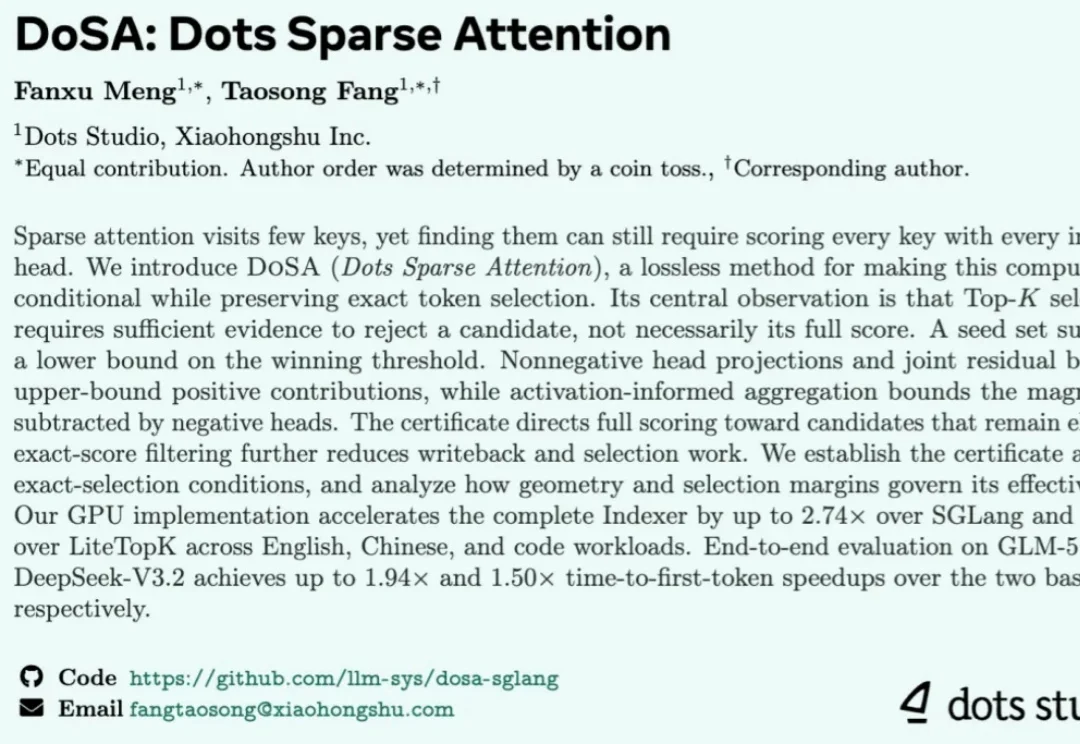
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
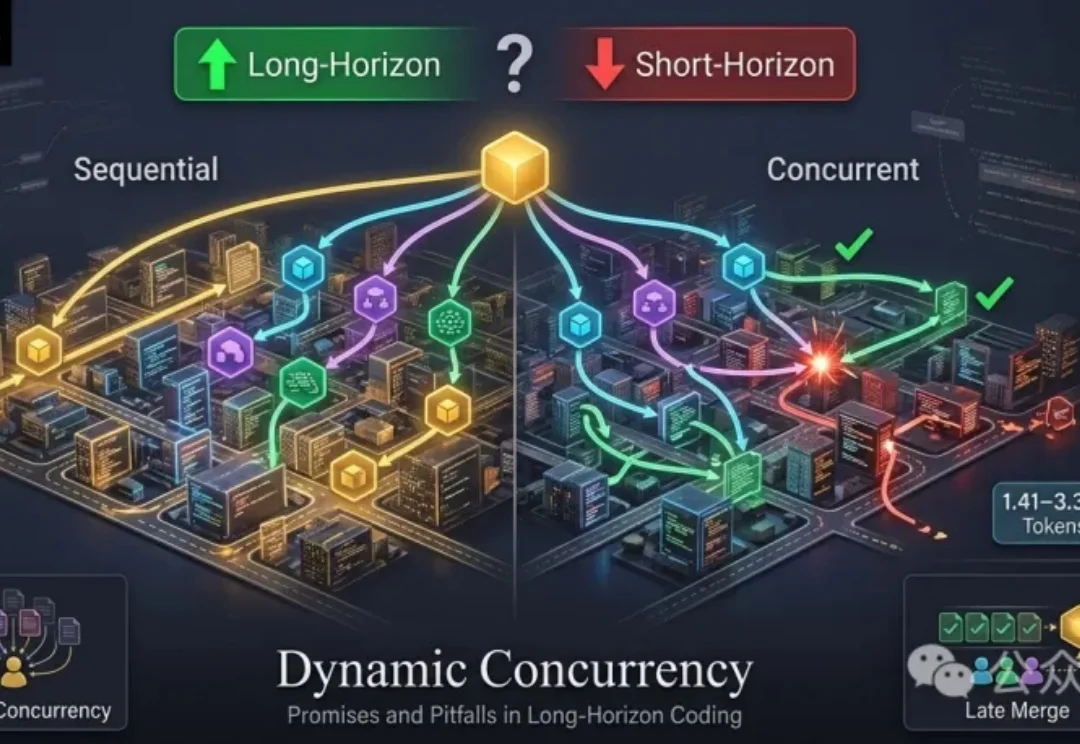
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
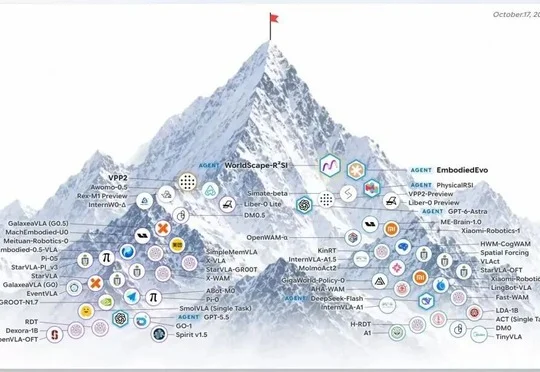
Manifold AI推出WorldScape R²SI,通过上下文学习与双层Agent持续改进能力登顶RoboDojo Agent Track总榜,超过GPT-6-Astra等模型。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
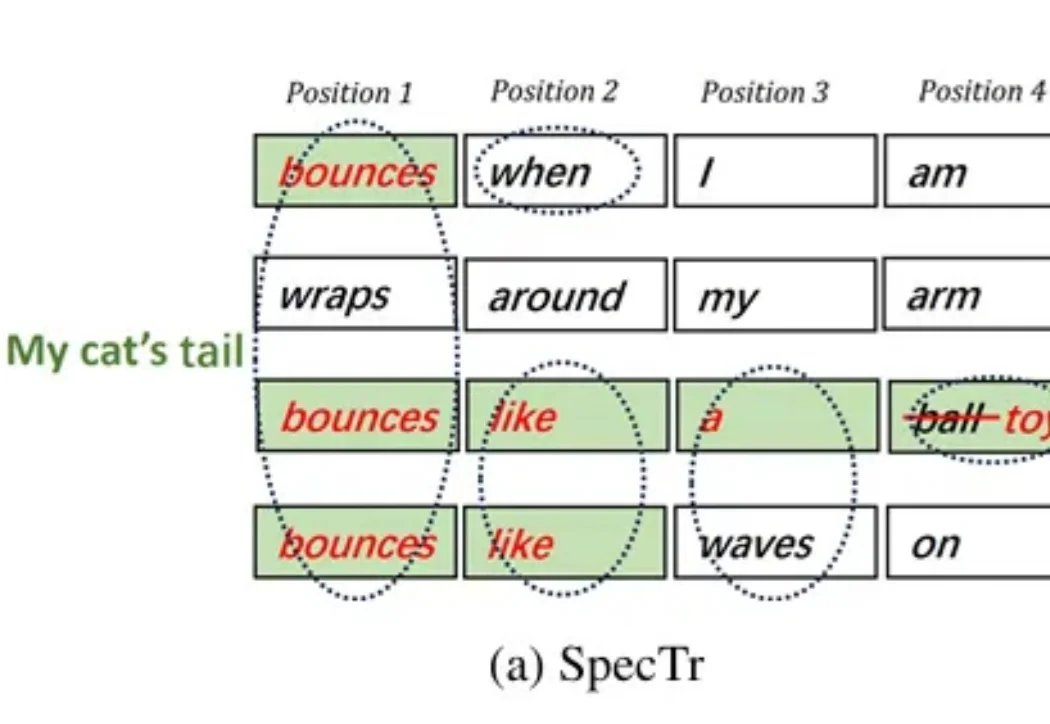
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
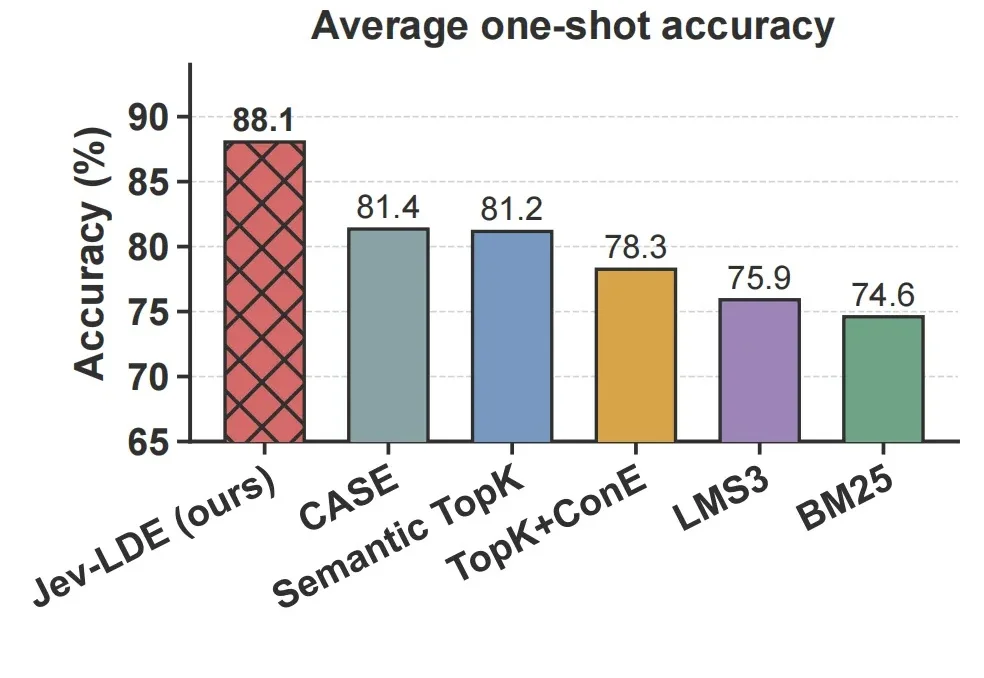
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
GPT-6.1 Sol,默认上下文直接冲到500k!