混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要
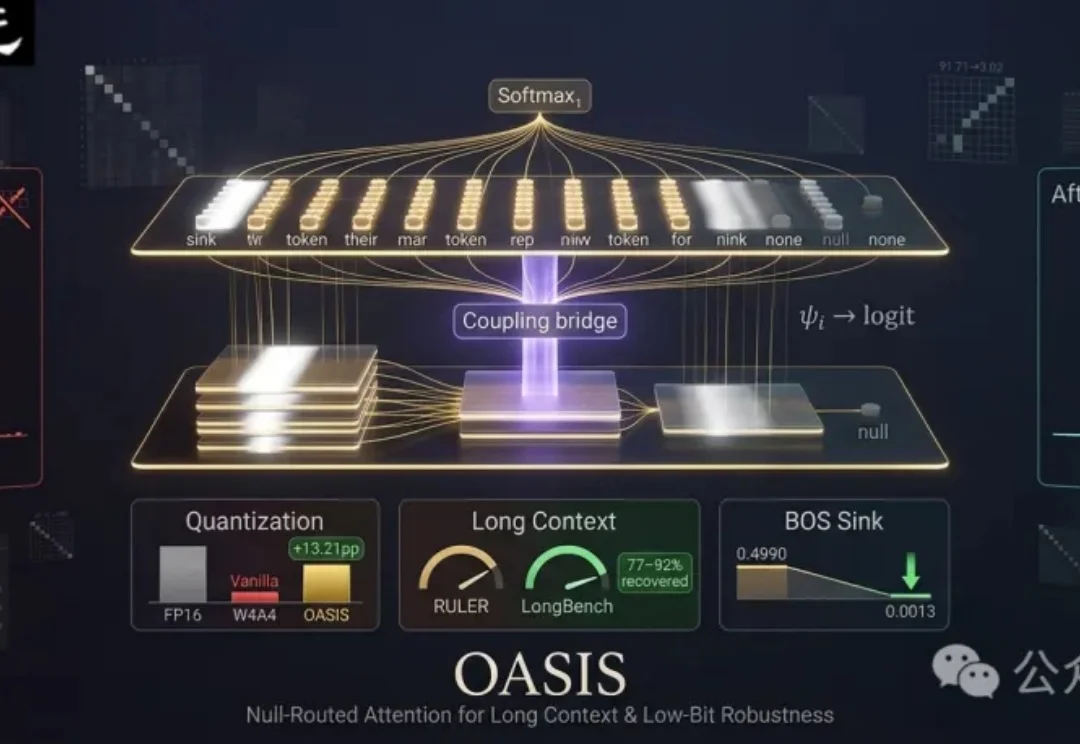
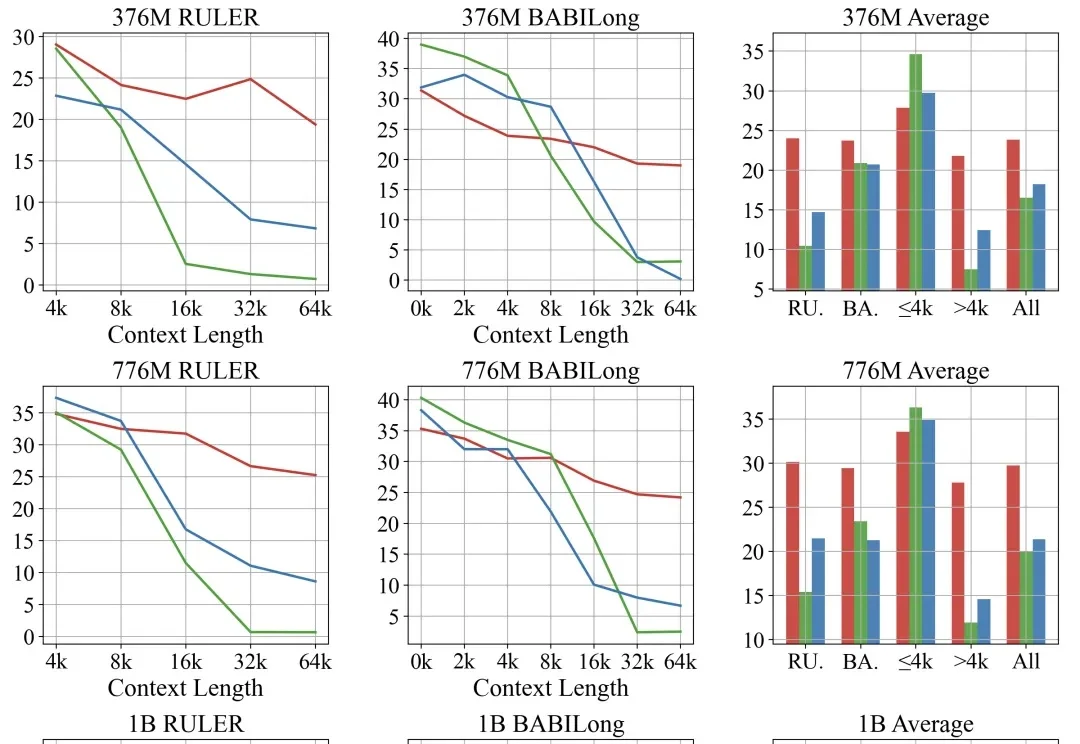
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
搜索
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
文章精选10组仍有近期维护记录的DeepSeek Harness插件,涵盖短剧创作、消息编辑、dsh-pet桌宠、QQ Bot与dsh-wechat手机端任务下达、视频筛选、网页搜索、浏览器操作、办公文件、交互界面、上下文查看及DSH Market插件市场。
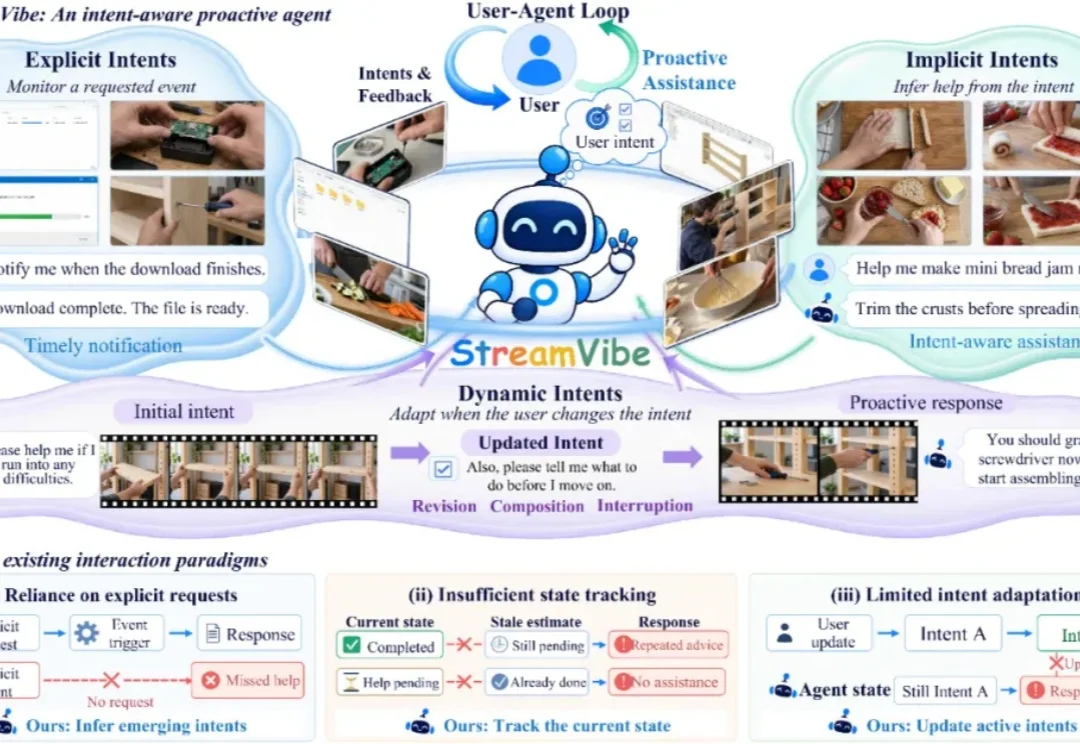
近期,Meta 的 Muse、OpenAI 的 Dot 等产品相继推出,让 Personal Agent(个人智能体)再次成为大模型领域的关注焦点。相比传统的对话助手,这类 Agent 不再局限于回答问题,而是能够结合用户的个人背景、历史记忆与应用上下文,主动执行任务并持续推进长期目标。一个更具主动性、能够长期陪伴用户的 AI 助手,正在逐渐成为现实。
Kimi K3.1 Pro 正式发布,具备3万亿级参数和100万 token 上下文,官方评测显示其在代码、Agent及金融等任务取得多项领先,完整权重将于11月4日前开放。
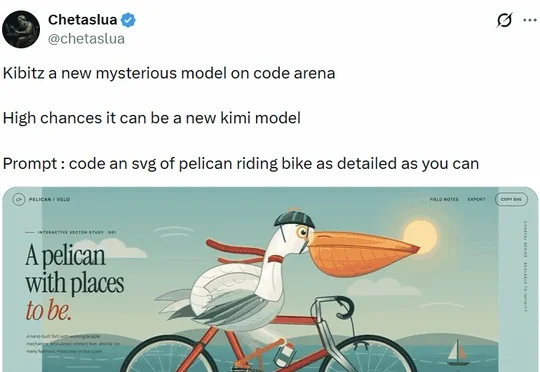
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
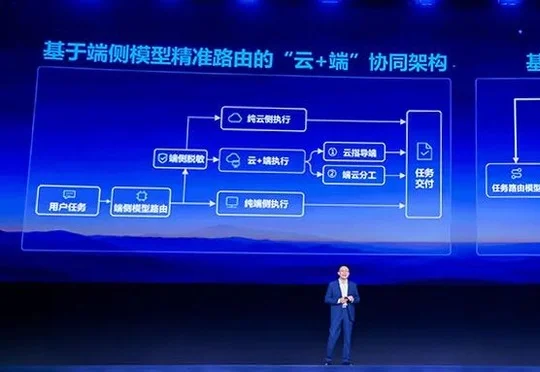
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
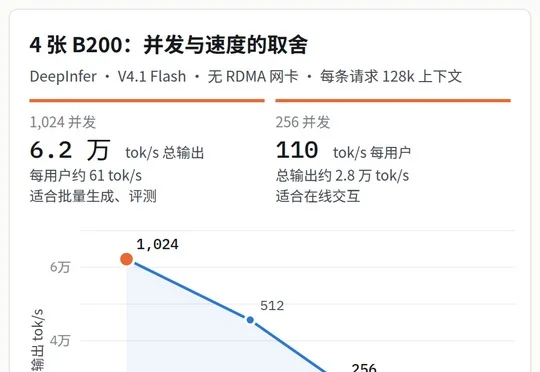
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
可能是最擅长「开会」的 AI 硬件。