蒋涛:大模型的“PC服务器时代”到来,解锁Token自由,走向人人程序员、行行炼模型
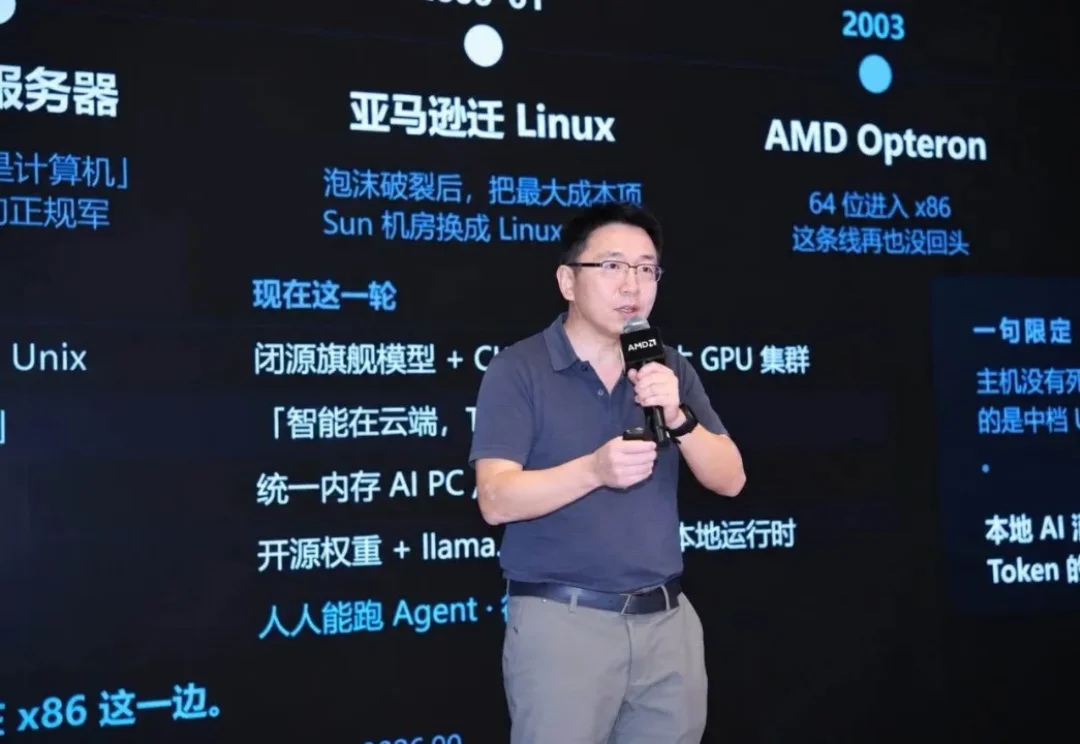
蒋涛:大模型的“PC服务器时代”到来,解锁Token自由,走向人人程序员、行行炼模型9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
搜索
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
坚持 1 晚通宵,烧掉 2 亿 Token,用上 3D 打印,掏出 4 千账单,购置 512GB 内存 Mac Studio,Vibe Coding 到 6 神无主,7 荤 8 素,最终获得 0 个用户......
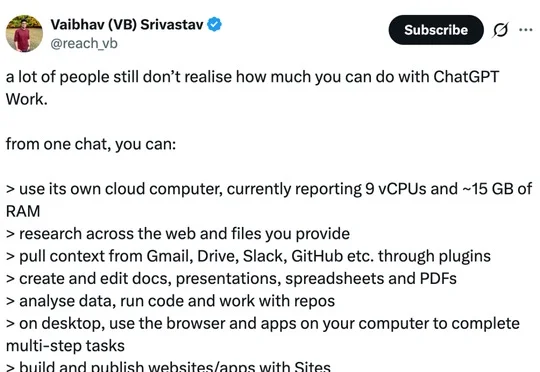
ChatGPT Work于8月25日上线云浏览器登录功能,背后的云电脑配有约9个虚拟CPU和15GB内存,可在网页和手机端自动登录网站处理订狗粮、保险报销等任务,而密码对AI不可见,标志着该智能体首次跨越登录墙真正替用户办完事。
寅谱试图用一种“以存换算”的思路破题:不是让硬盘SSD替代GPU计算,而是用更低成本的SSD承接温冷(指访问频率极低和中等)的AI大模型数据、复用已经完成的中间结果,减少显存及内存压力、GPU等待和重复Prefill(预填充)。
一台AI服务器,涨价超过15%!
面对大模型规模与硬件内存之间高达20倍的算力鸿沟,不重训的“1比特量化”如何把千亿参数的硅基大脑塞进微型设备?
OpenAI接连放大招!今天,一条OpenAI内部Slack消息爆出,ChatGPT将迎来一次「史诗级」的性能大换血。从硬核测试数据来看,这次ChatGPT前端性能的优化幅度,夸张到近乎「不真实」:应用加载速度直接飙升94%,堆内存增长减少87.8%,整体内存占用砍掉41.2%。
Cloudflare 用 12 周从零写了一个浏览器。Rust 编写,跑在自家的 Workers 边缘网络上,内存占用最多比 Chromium 省 7 倍,专给 AI agent 用,beta 期免费。名字叫 Kitesurf。官博和推文里反复念叨同一句话,Chromium 太沉了,没法给每个 agent 都发一个。
一块 8.24GB 内存的 CPU,一个 2.78 万亿参数的大模型,甚至不需要显卡,Kimi K3 就这么水灵灵地跑起来了。