Agent推理快10倍是怎么做到的?苹果×CMU:把「生成」改成「做选择题」
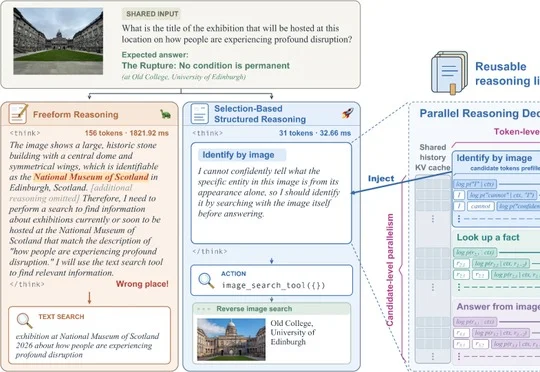
Agent推理快10倍是怎么做到的?苹果×CMU:把「生成」改成「做选择题」苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
来自主题: AI技术研报
10132 点击 2026-10-17 11:55

 搜索
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
Z Potentials 独家获悉,Xspark AI(无界智航)近日完成新一轮融资。本轮融资由猎道投资、华山资本、元航资本、浦东创投、钧源资本、南山战新投、水木创投等机构共同参与,多维资本担任本轮融资独家财务顾问。
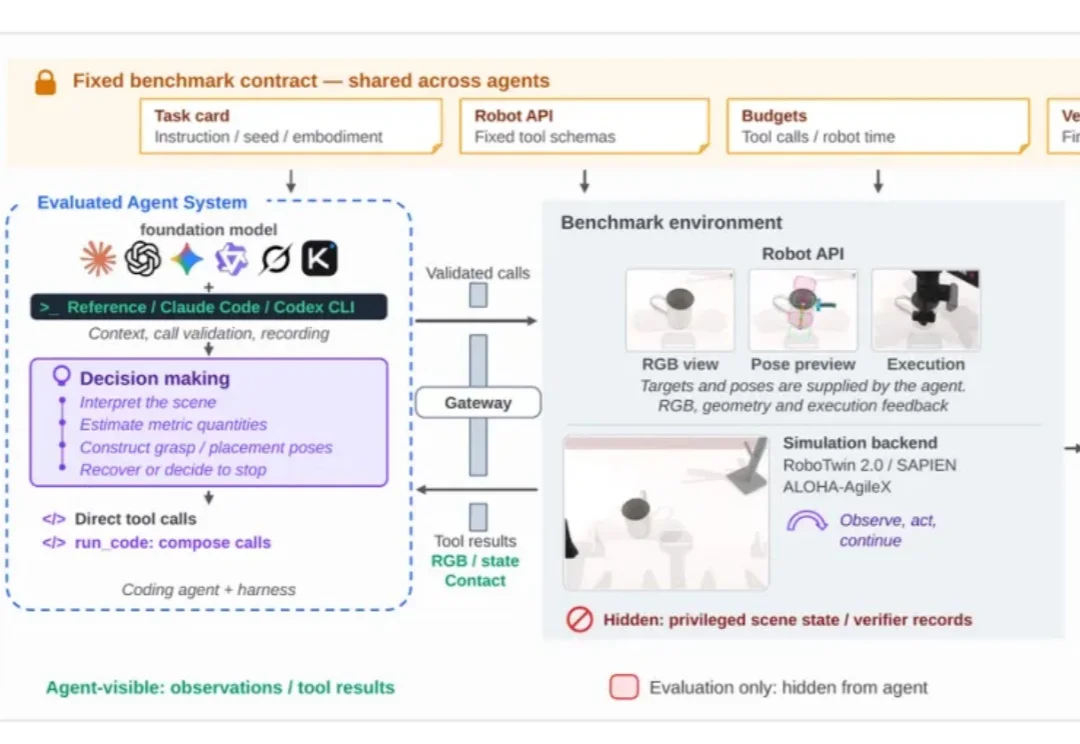
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
什么?35B的MoE,在手机上也能跑得很丝滑?
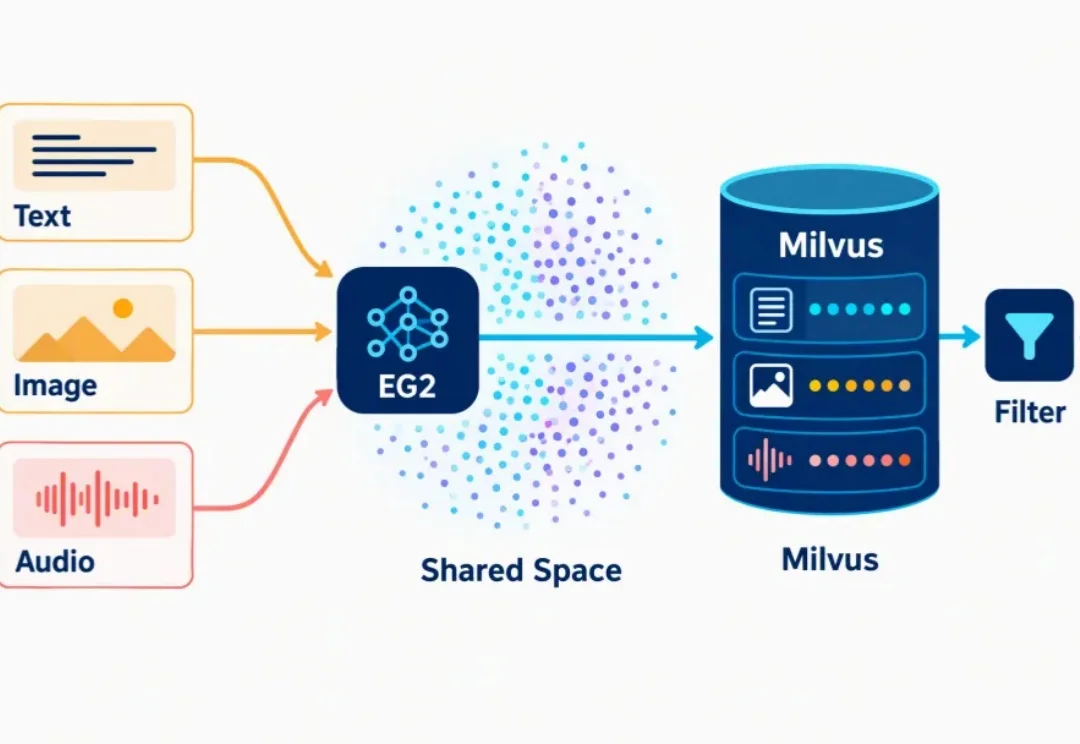
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。
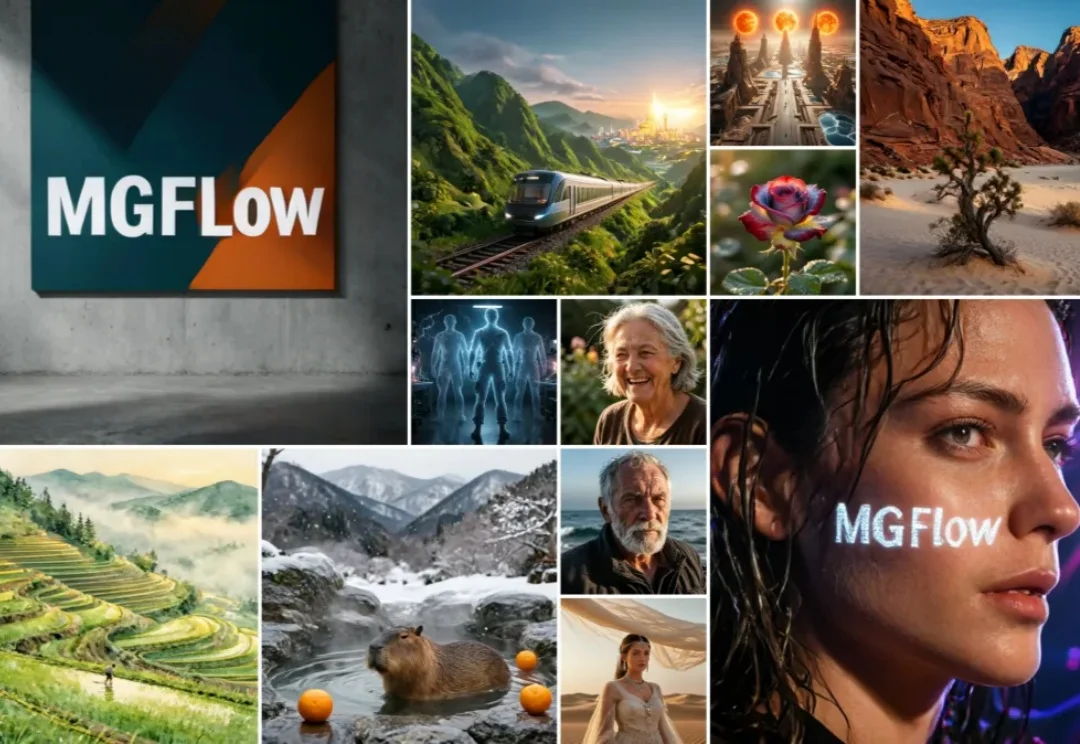
对着屏幕说一句 “向左转”,画面随即展开新的视野;调整角色的动作,场景紧接着给出反馈。多模态交互要求视觉生成跟上人的操作,而漫长的等待会打断整个体验。
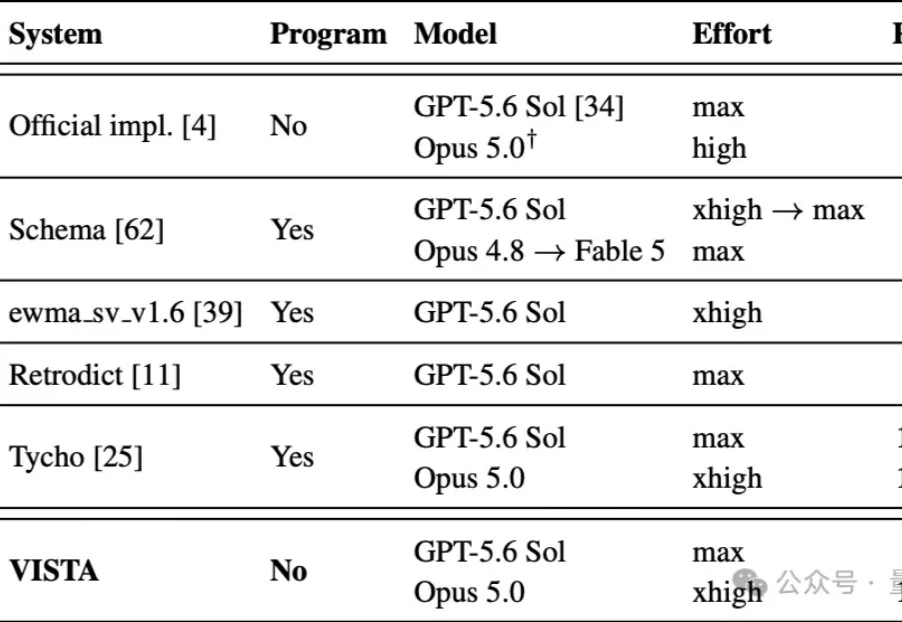
多模态模型的视觉原生Harness,来了!
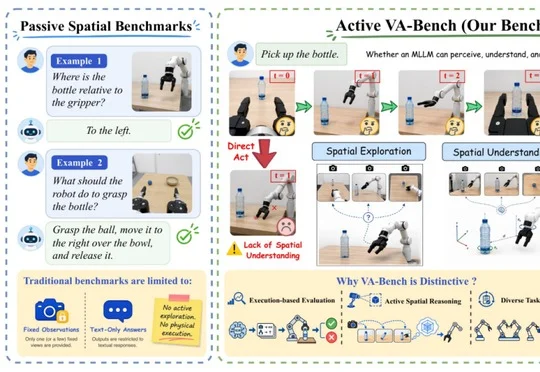
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。