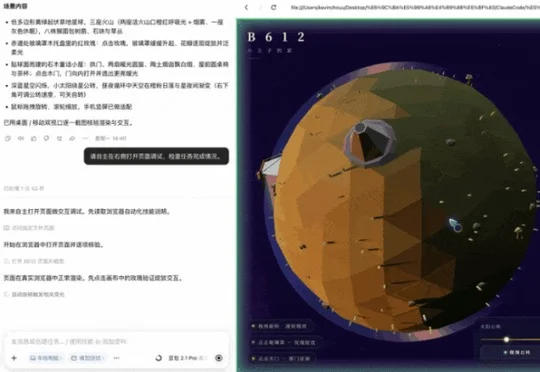
豆包大模型再更新,发力多模态编程,一手实测来了
豆包大模型再更新,发力多模态编程,一手实测来了字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
来自主题: AI资讯
7372 点击 2026-09-18 15:48

 搜索
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
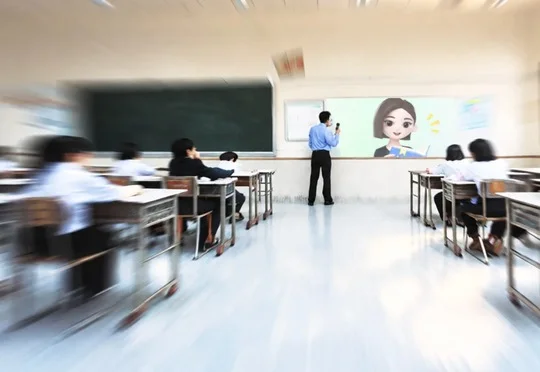
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。
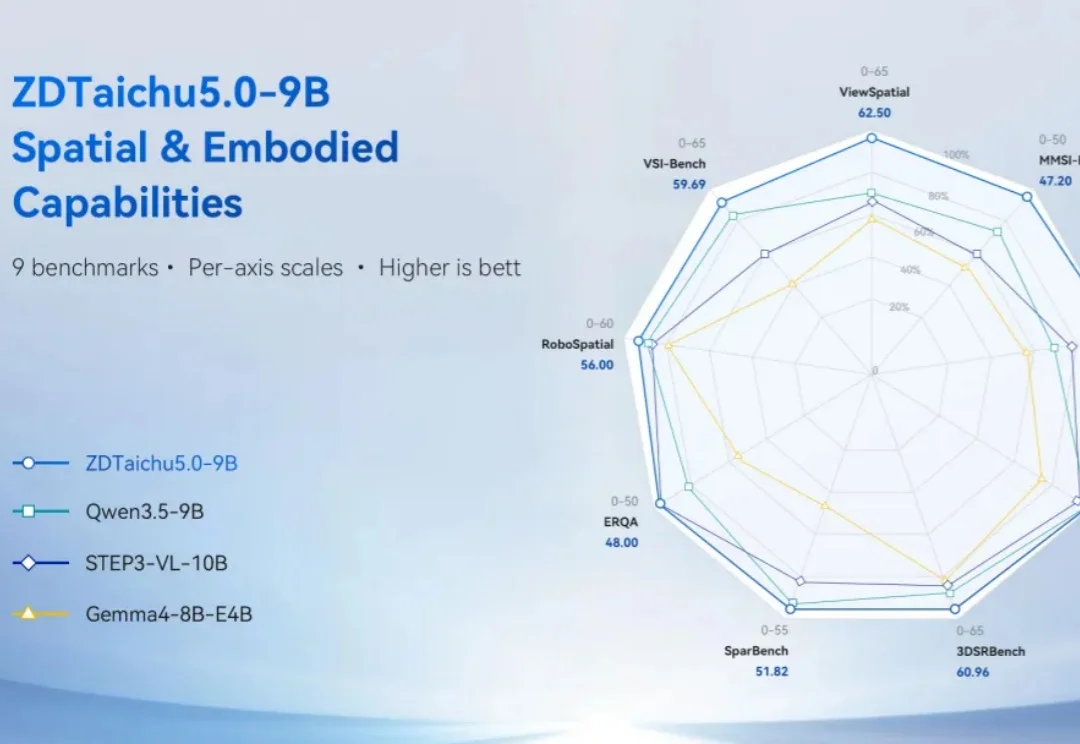
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
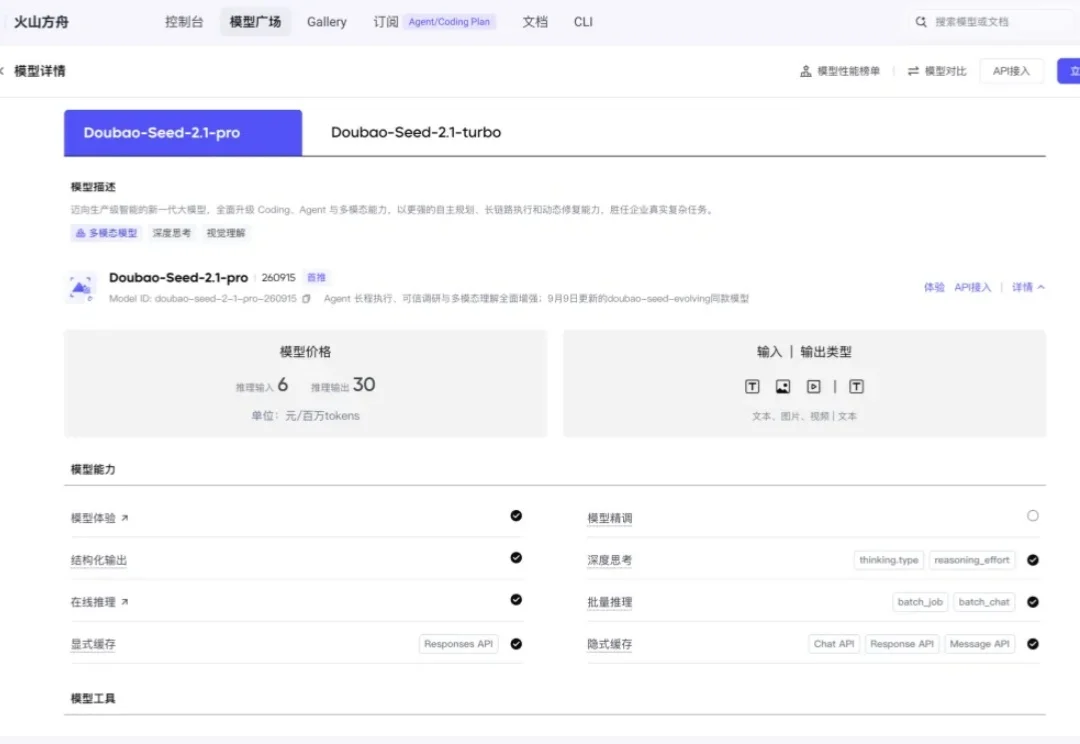
最近Seed-2.1-pro又更新了。
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
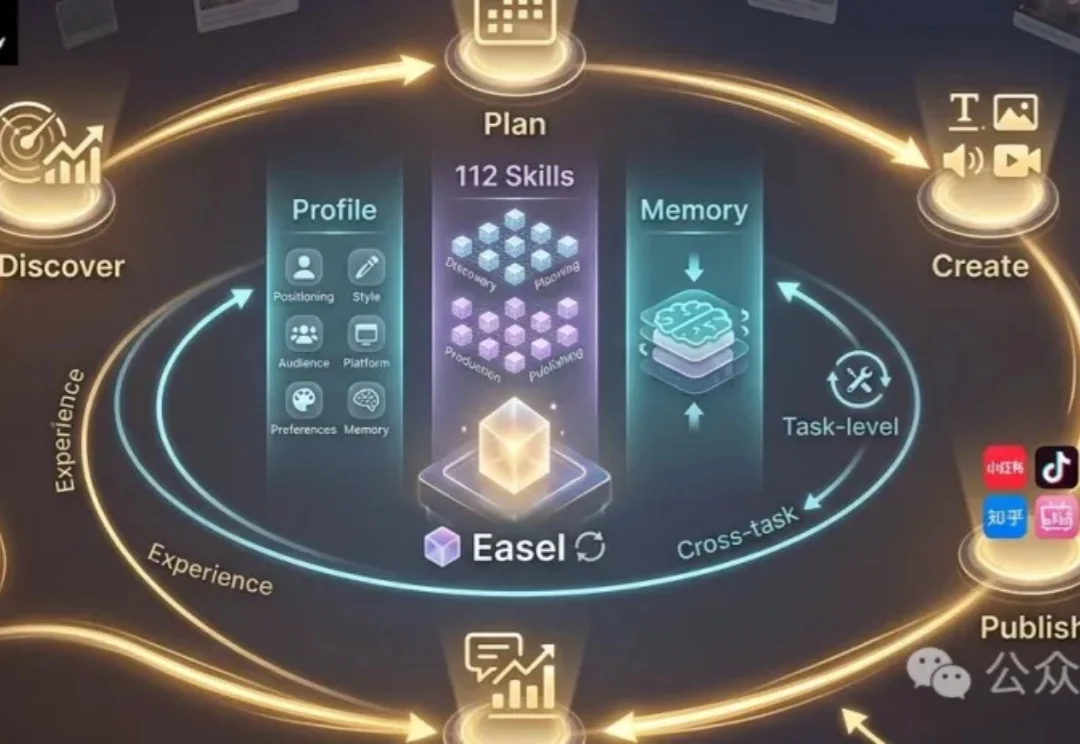
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
OpenAI计划以3亿美金收购由前苹果工程师创立的AI影像公司Glass Imaging,以补充端侧视觉能力,布局多模态AI硬件。
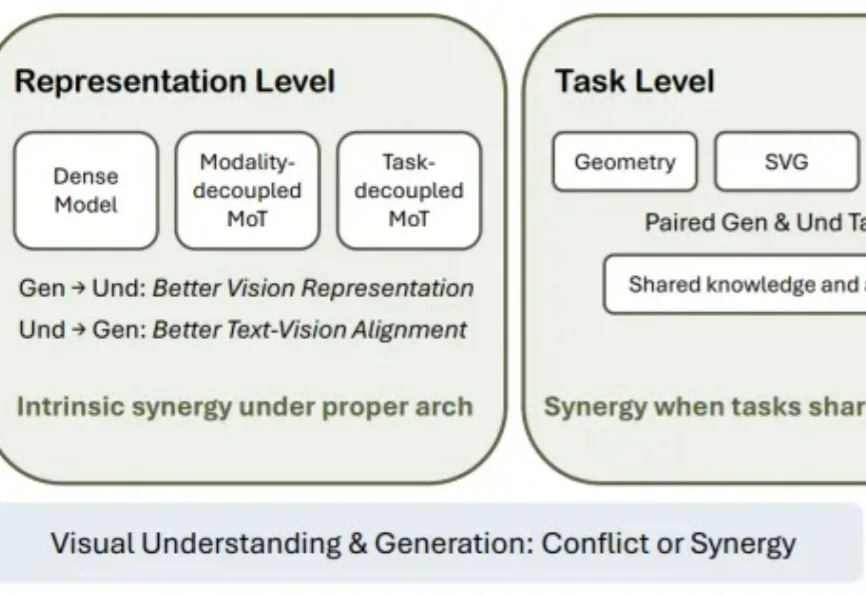
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
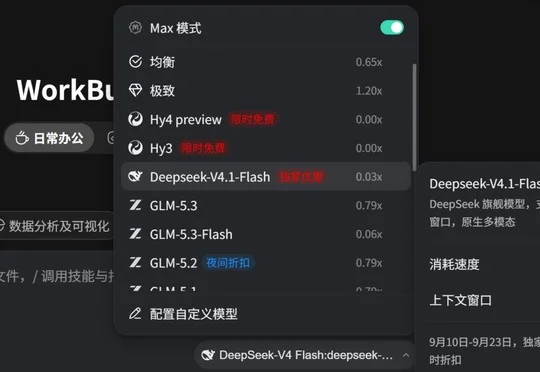
DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
视觉编程成绩超GPT-5.4。