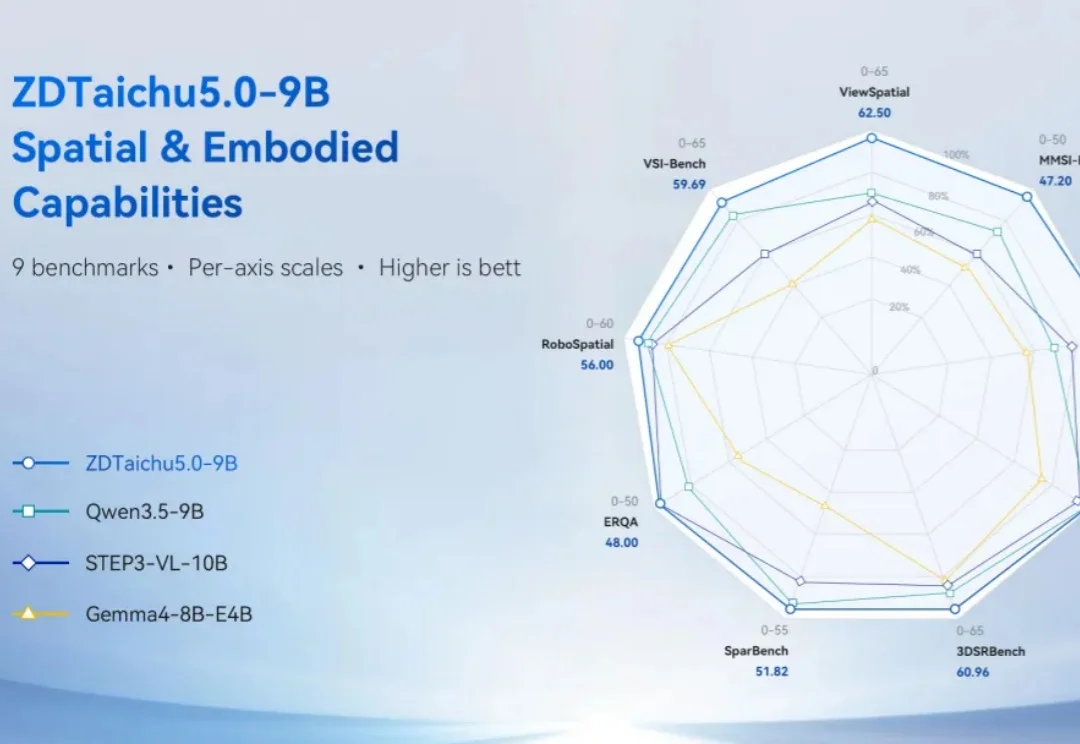
开源模型夯爆了!ZDTaichu5.0-9B,10B以内空间具身智能卷出通用类第一
开源模型夯爆了!ZDTaichu5.0-9B,10B以内空间具身智能卷出通用类第一紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
来自主题: AI技术研报
7913 点击 2026-09-18 10:00

 搜索
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
大模型过去几年的能力跃迁,几乎都围绕一个词:Scaling。
创新工场汪华与Floatboat.ai创始人谭少卿对话指出,腾讯WorkBuddy、字节豆包工作、阿里千问办公等大厂AI办公会战已完成Agent市场教育,GLM-5.3-Flash和DeepSeek-V4-Flash等国产模型跨过能力门槛,巨头的壁垒仅剩资金,而中国创业者凭借贴近开源模型生态的优势,有望在垂直Agent领域找到更多机会。
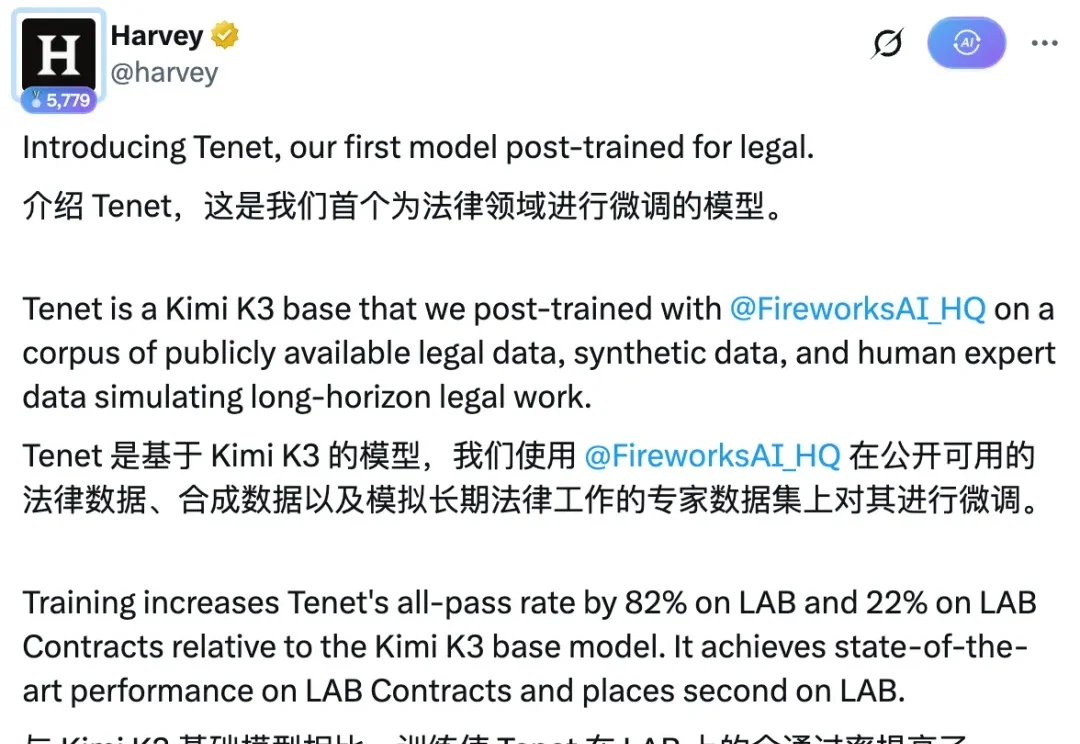
沙特人工智能公司HUMAIN基于中国MiniMax的开源旗舰模型MiniMax M3推出阿拉伯语大模型HUMAIN M3,使用超过1万亿Token阿拉伯语数据进行后训练,在七项阿拉伯语基准测试中等权平均分达89.37%,标志着中国开源模型正成为全球AI生态的底层技术基础。
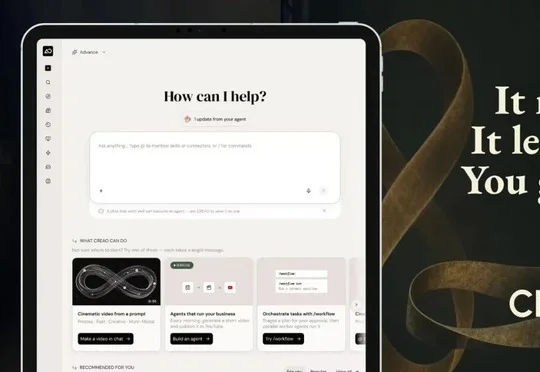
面向Agent Harness层自进化方向,CREAO AI近日完成千万级美元新融资,资金将用于扩大真实业务工作流与高质量反馈数据规模,加速基于开源模型后训练的垂直模型迭代。
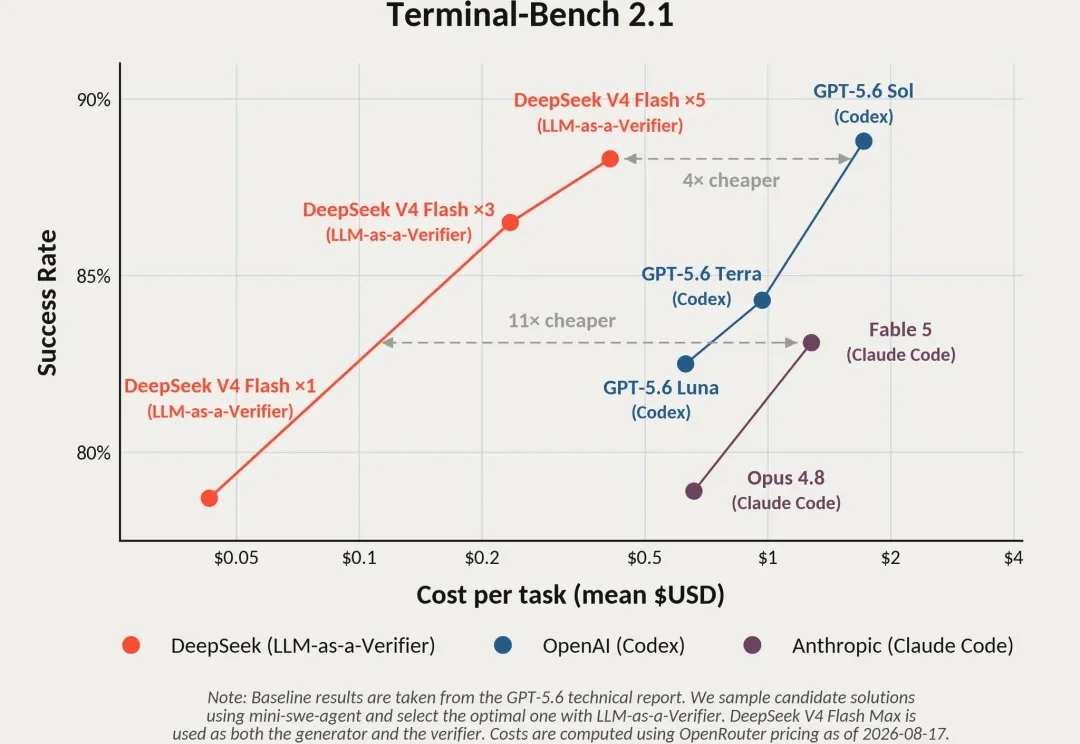
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
老黄刚砸60亿,要造一个地表最强开源模型。
大模型的版本告一段落,AI应用的新版本已经到来。
老黄,真的不甘心只做卖铲人了!
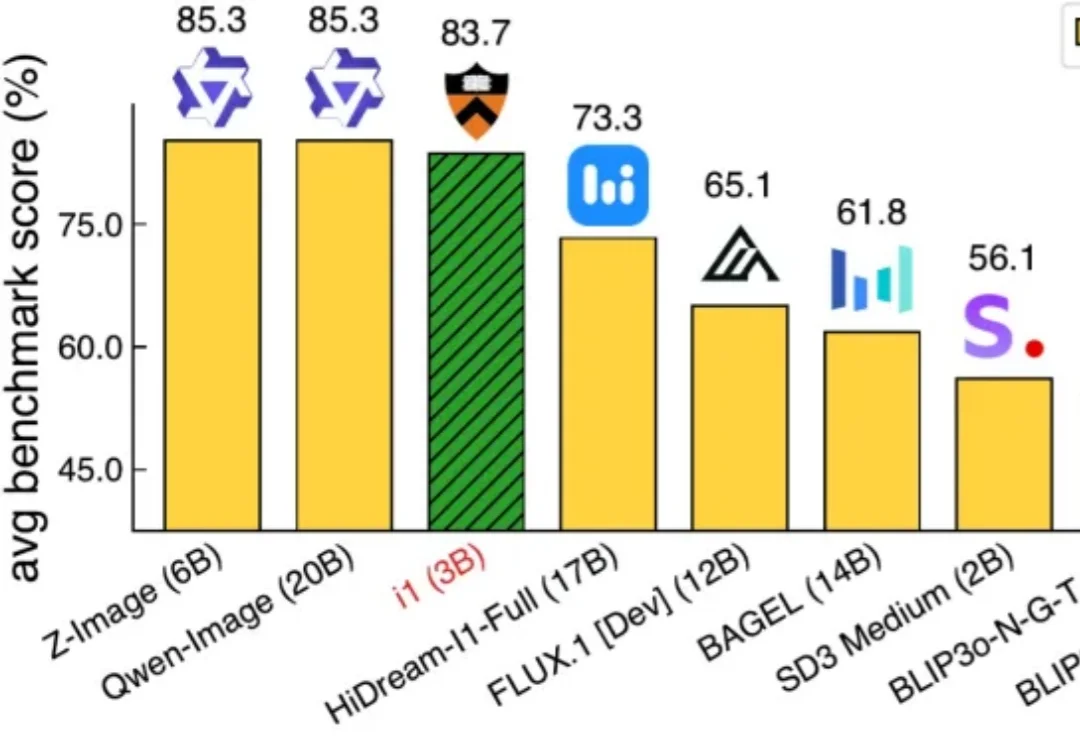
近来文生图模型发展迅速,但每篇工作多是独立地引入一整套模型、数据和训练设计,然后用私有的数据训出来了一个亮眼的模型。