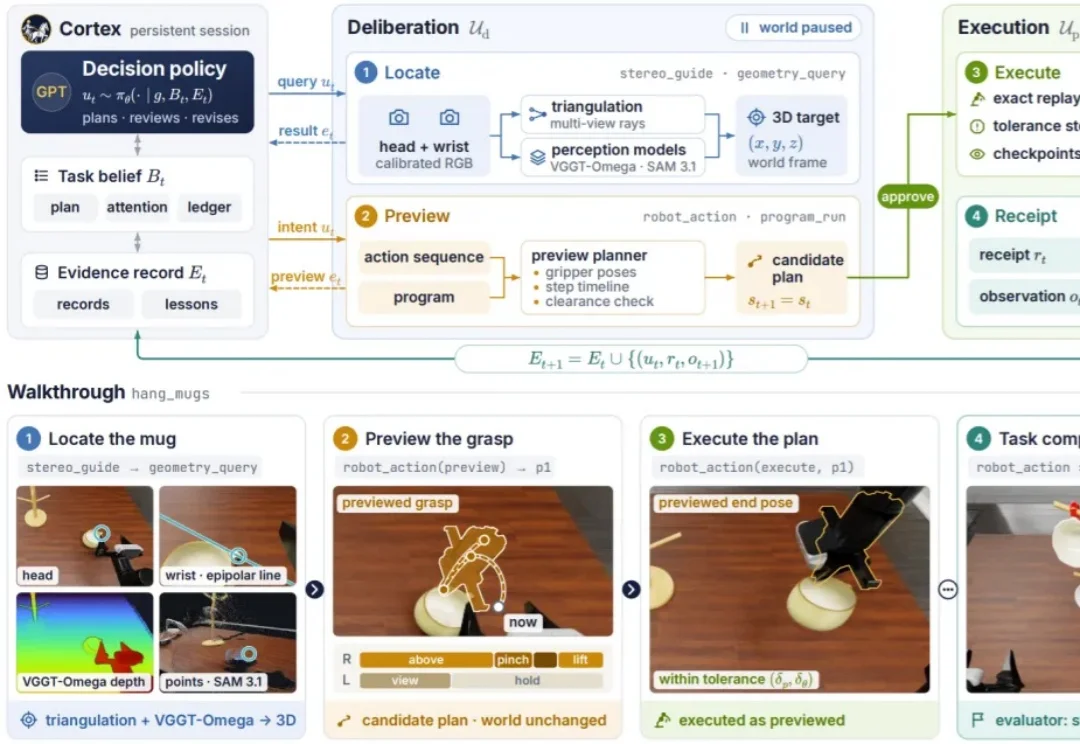
具身RSI的真假之争:机器人是在自我进化,还是在反复刷题?
具身RSI的真假之争:机器人是在自我进化,还是在反复刷题?在电子游戏里,玩家拥有一项近乎无敌的特权——无限读档(env.reset)。
来自主题: AI技术研报
9131 点击 2026-11-02 10:32

 搜索
在电子游戏里,玩家拥有一项近乎无敌的特权——无限读档(env.reset)。
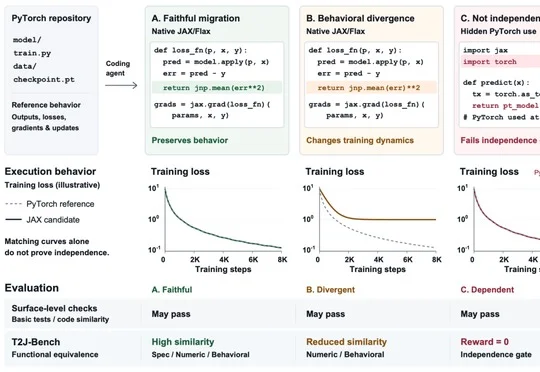
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
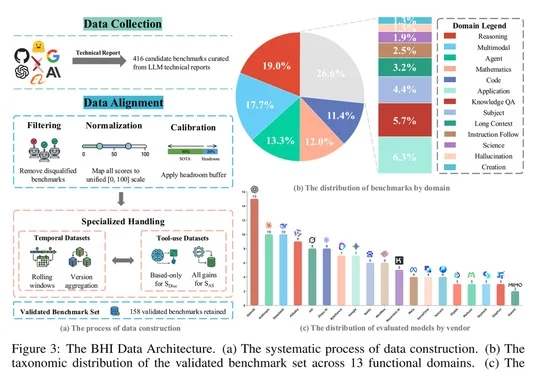
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
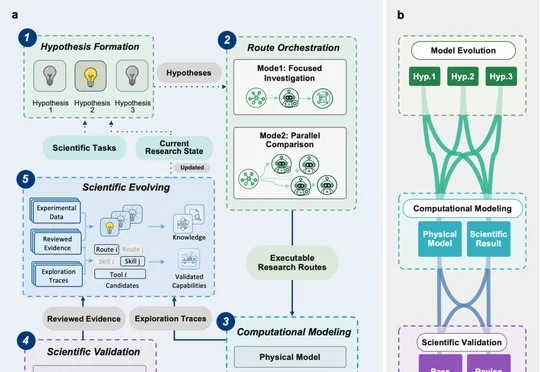
清华大学张强教授团队联合北京清屿科技、香港大学和北京怀柔实验室提出EvoSim,使AI从实验偏差中追查机制、修订方程并积累建模方法,并在电池快充析锂与动态电压预测场景完成验证。
清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
刘锋博士研究团队基于广义智能体理论提出仍属初步设想的AI「鲁滨逊测试」,通过分阶段撤离人类维护和任务指令,观察AI能否自主维持、探索资源及形成源自自身的控制。
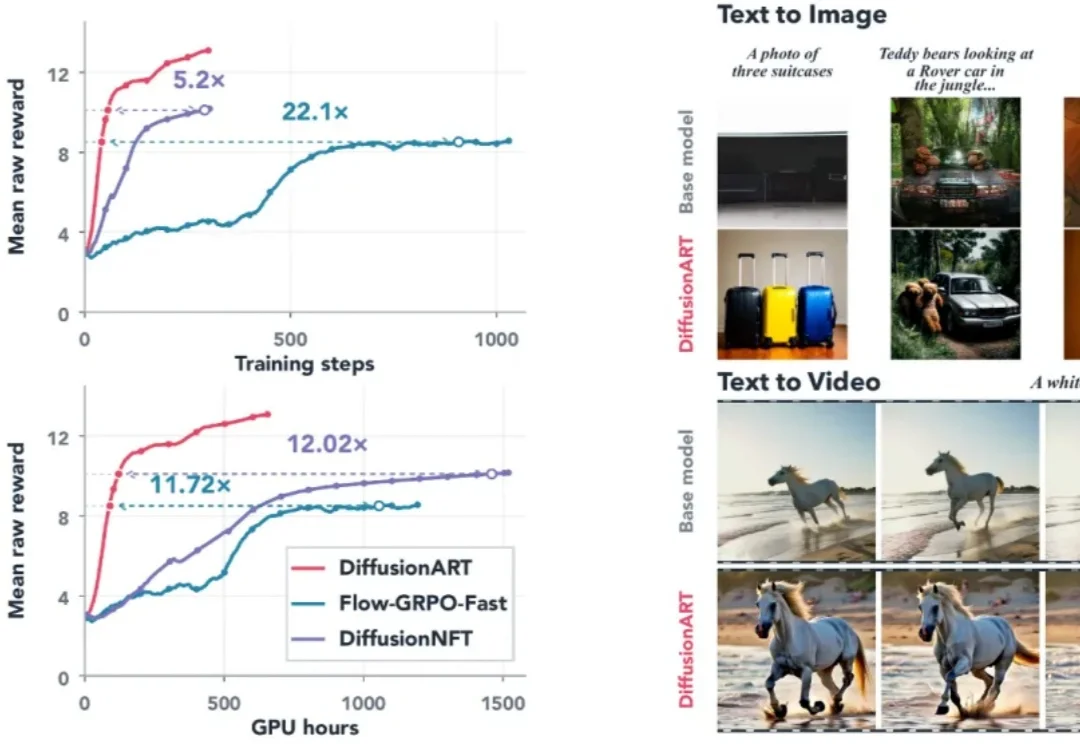
来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。
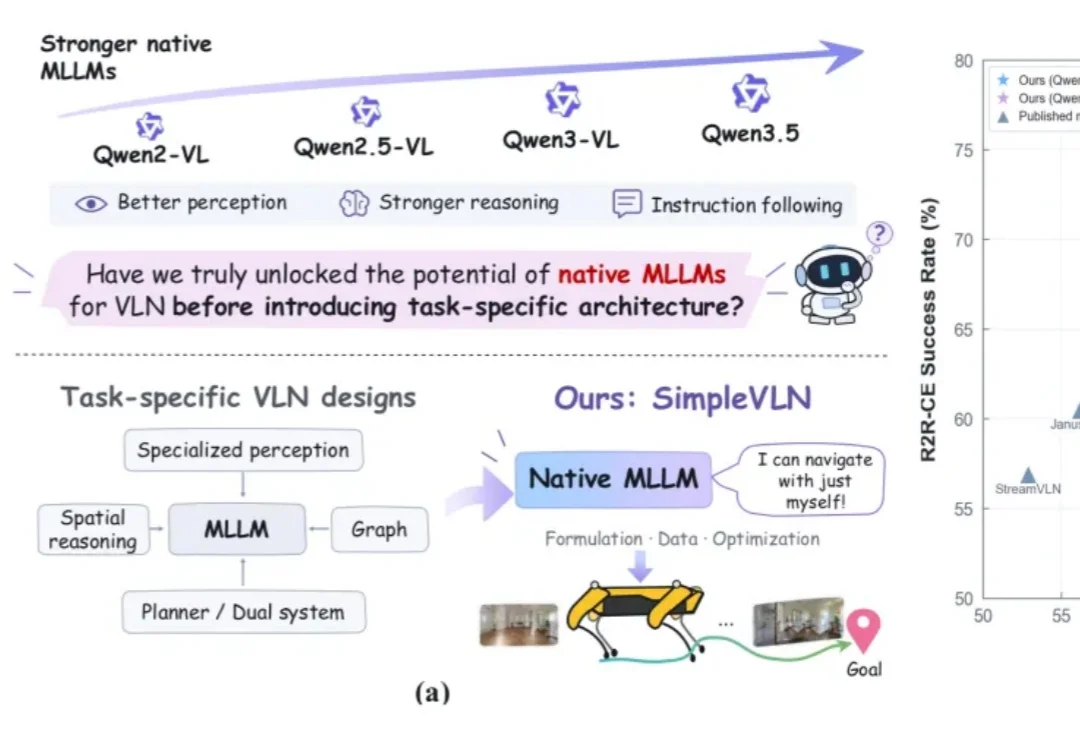
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
一个充电器,一根缠成一团的线。
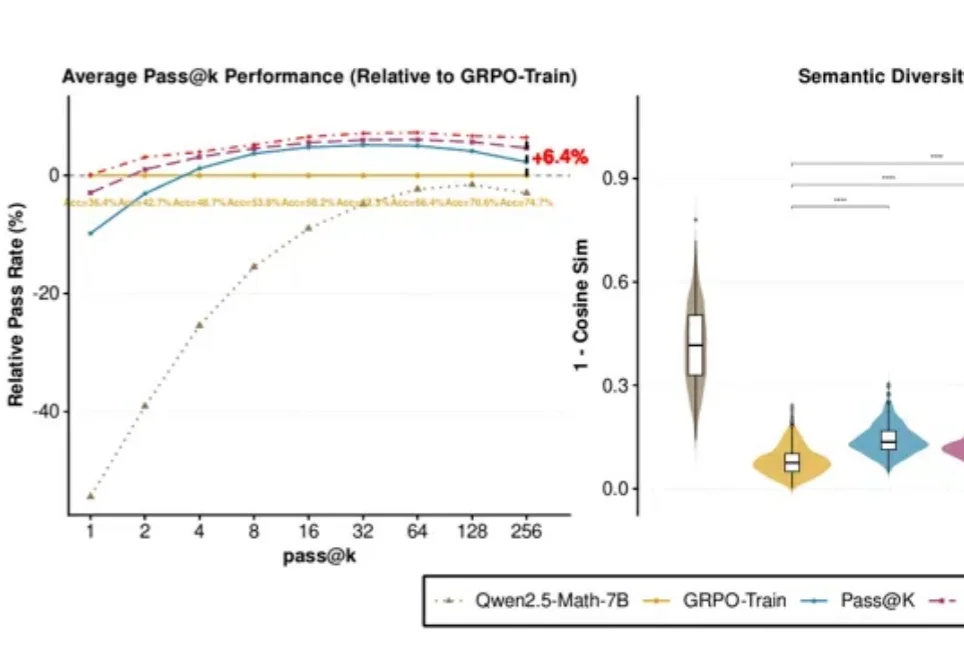
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。