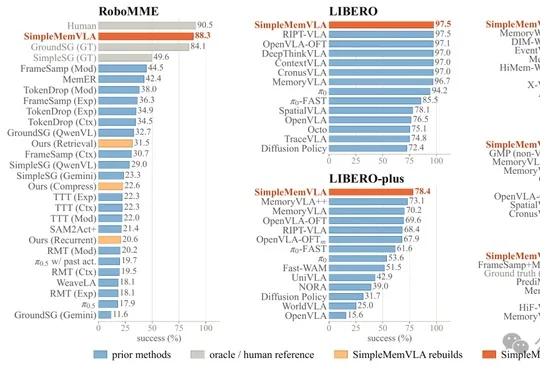
流式推理优化,让机器人决策延迟低至0.68秒
流式推理优化,让机器人决策延迟低至0.68秒SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
来自主题: AI技术研报
9161 点击 2026-09-18 15:47

 搜索
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
就在上周,黄仁勋在高盛科技大会上说了一句让整个 AI 圈亢奋的话: 网络安全,很可能是 AI 的下一个杀手级应用。
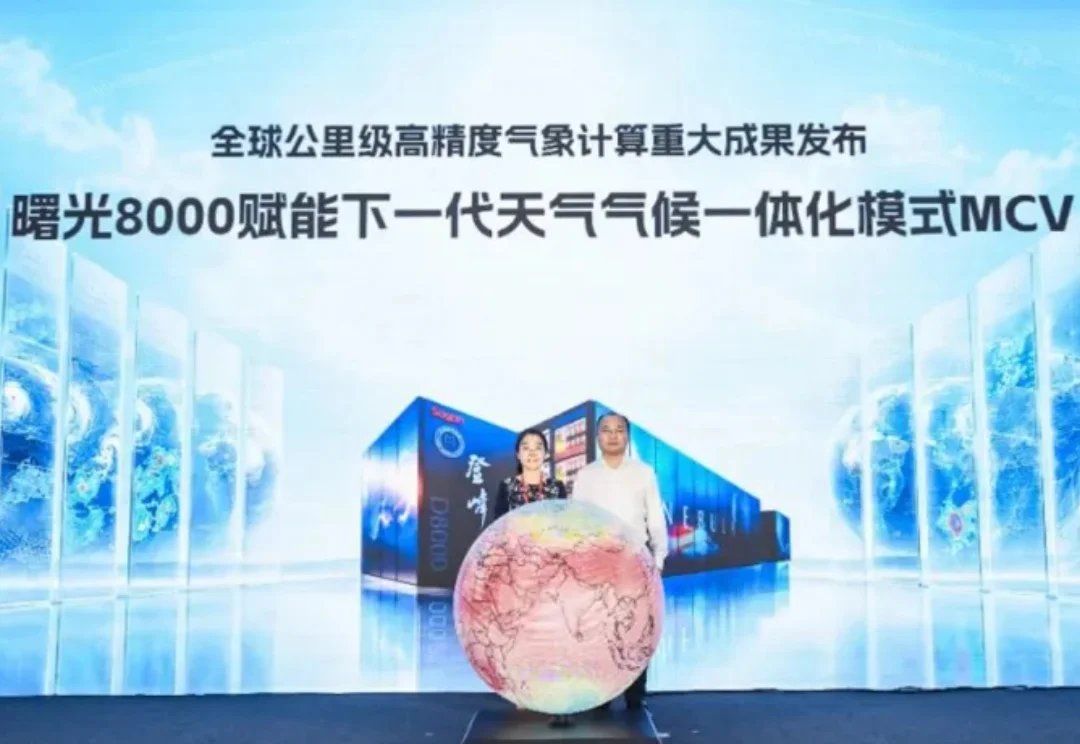
中国科技又拿下“全球第一”,这次突破难在哪?
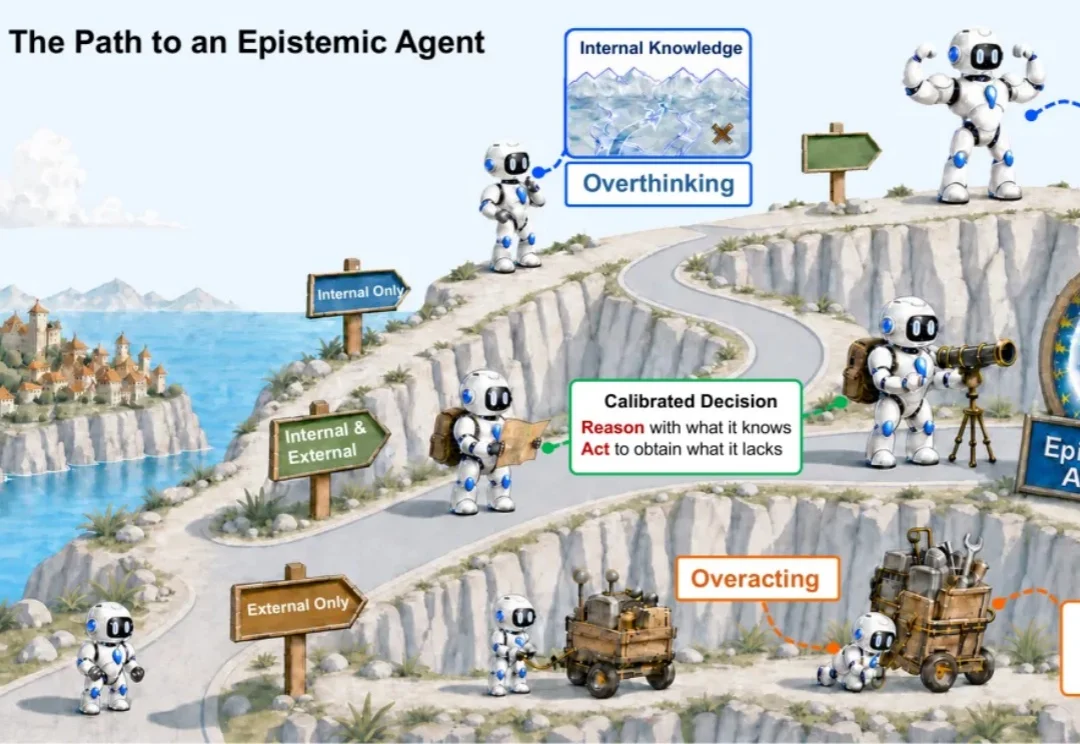
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
2026年上半年,具身智能赛道狂揽超过460亿元融资,人形机器人的单价也正式迈入「万元以内」的门槛。
近日,中国金融AI领跑者讯兔科技正式完成超3亿元人民币B轮融资。至此,公司在过去一年内已连续完成三轮融资。
数据从哪儿来?模型怎么做?落地在哪里?
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
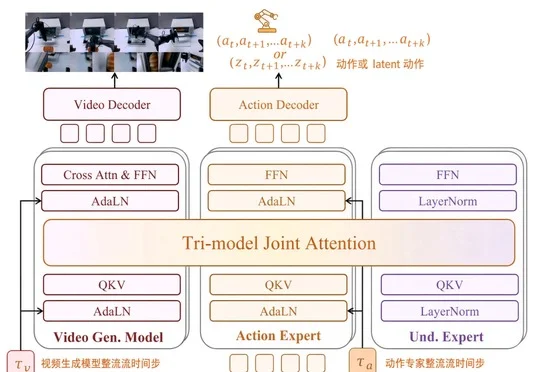
9月10日,生数科技在外滩大会发布面向灵巧操作的自进化通用世界模型Motus2,首次将策略、仿真器与评估器统一于同一模型,实现"行动—预测—评估—反馈"闭环,五项真机任务平均成功率84%。
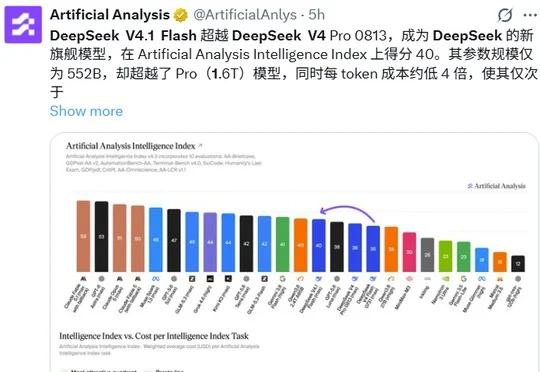
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。