混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要
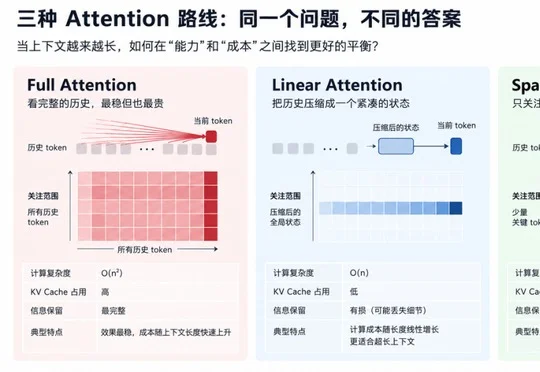
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
搜索
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
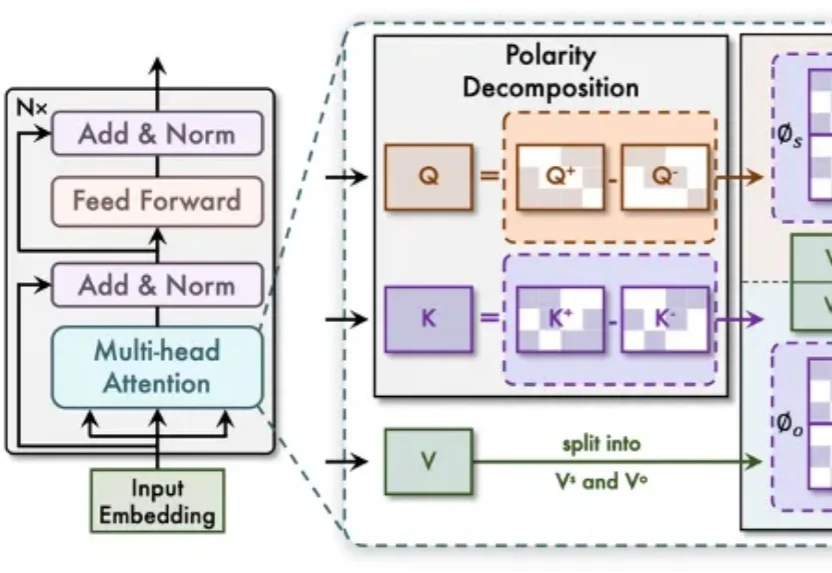
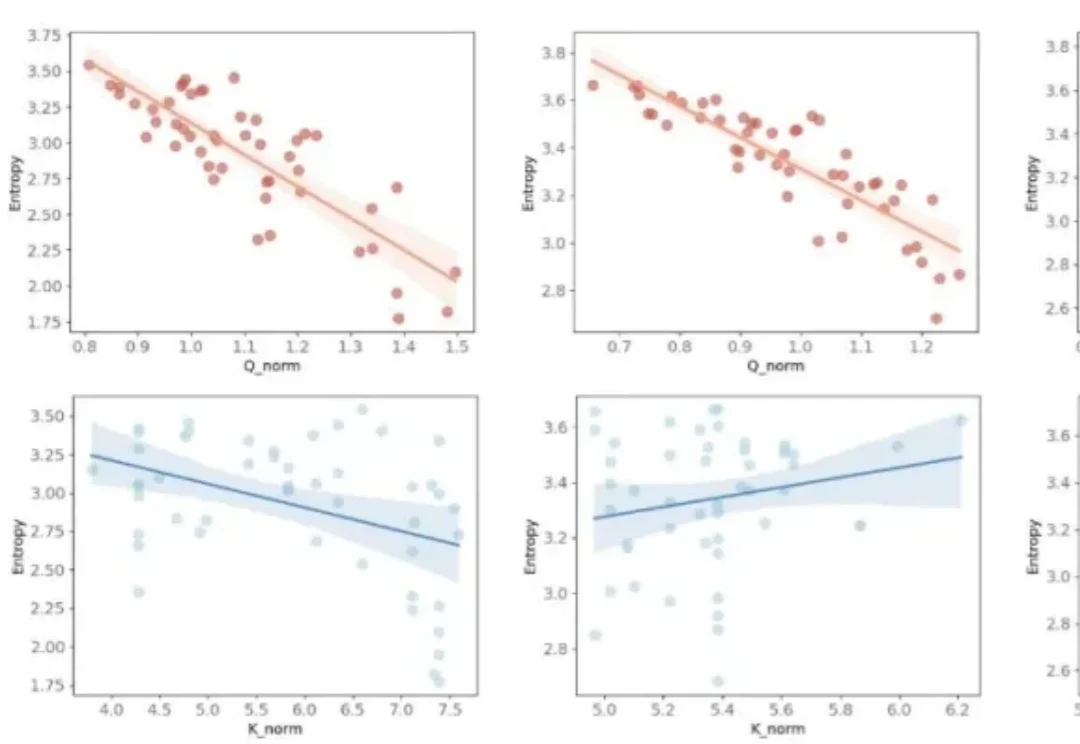
继 ICLR 2025 的 PolaFormer 之后,哈工大(深圳)与鹏城实验室合作的扩展版本 PolaFormer++ 近日被 IEEE TPAMI 正式接收。新版本在理论框架、特征映射设计和实验覆盖面上全面升级:首次给出判定特征映射是否具备「降熵尖锐性」的理论判据,并提出极性感知的通道级尖锐(PaCS)特征映射,在六大类视觉核心任务上全面验证了线性注意力的潜力。
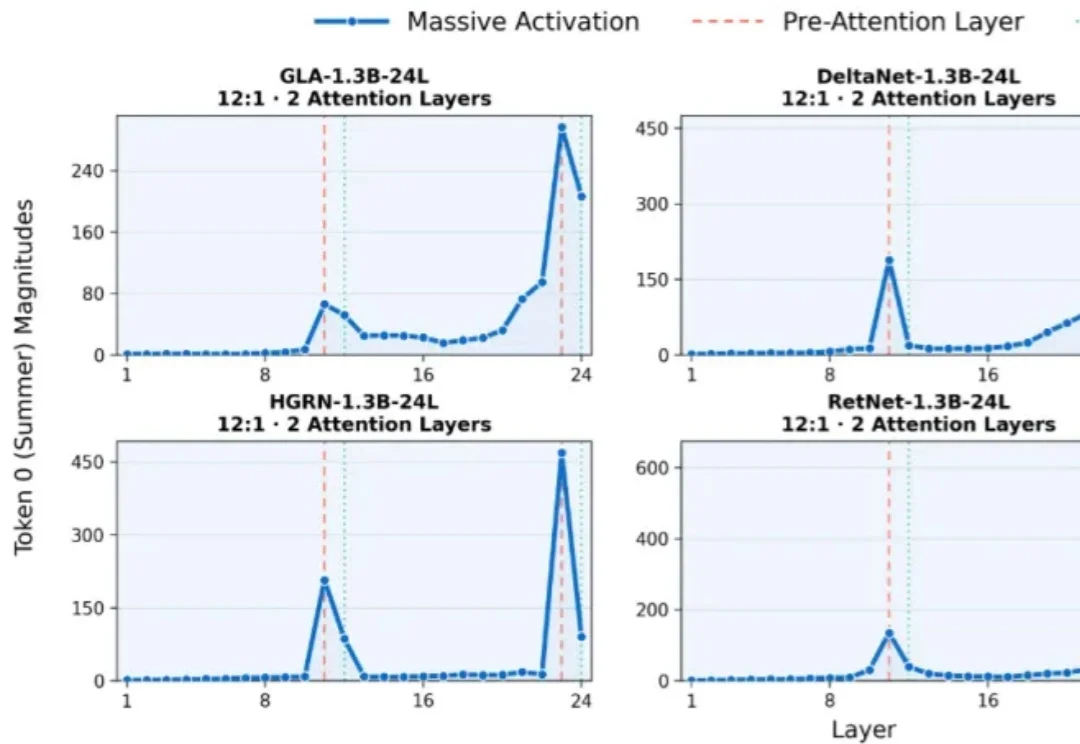
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
Transformer 依托强大的建模能力和 Scaling 效率在推荐领域被广泛应用于超长序列建模和生成式推荐等方向,
当 Transformer 席卷计算机视觉领域,高分辨率图像、超长序列任务带来的算力与显存瓶颈愈发凸显:标准 Softmax 注意力的二次复杂度,让 70K+token 的超分辨率任务直接显存爆炸,高分辨率图像分割、检测的推理延迟居高不下。
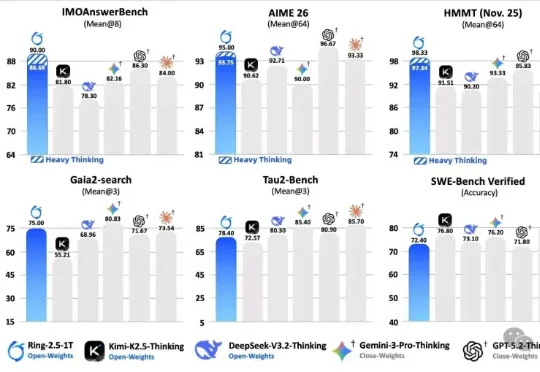
先介绍一下今天的主角。Ring-2.5-1T,蚂蚁百灵团队刚发布的万亿参数开源思考模型,全球首个混合线性注意力架构的万亿级选手。IMO 2025 国际奥数 35/42 拿到金牌水平,CMO 2025 中国奥数 105 分远超国家集训队线 87 分,GAIA2 通用 Agent 评测开源 SOTA。数字很漂亮,但数字谁都会贴。
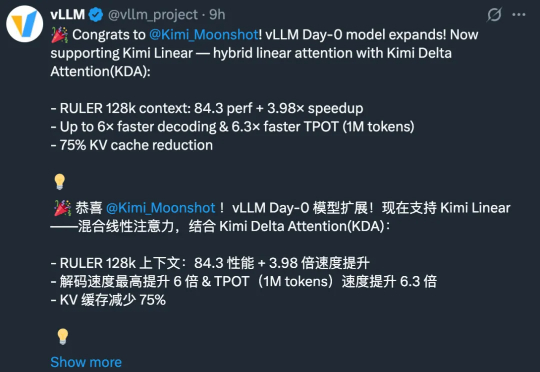
月之暗面最新发布的开源Kimi Linear架构,用一种全新的注意力机制,在相同训练条件下首次超越了全注意力模型。在长上下文任务中,它不仅减少了75%的KV缓存需求,还实现了高达6倍的推理加速。
月之暗面在这一方向有所突破。在一篇新的技术报告中,他们提出了一种新的混合线性注意力架构 ——Kimi Linear。该架构在各种场景中都优于传统的全注意力方法,包括短文本、长文本以及强化学习的 scaling 机制。