谷歌爆改Transformer,“无限注意力”让1B小模型读完10部小说,114倍信息压缩
谷歌爆改Transformer,“无限注意力”让1B小模型读完10部小说,114倍信息压缩它通过将压缩记忆(compressive memory)整合到线性注意力机制中,用来处理无限长上下文
来自主题: AI资讯
11293 点击 2024-04-13 20:07

 搜索
它通过将压缩记忆(compressive memory)整合到线性注意力机制中,用来处理无限长上下文
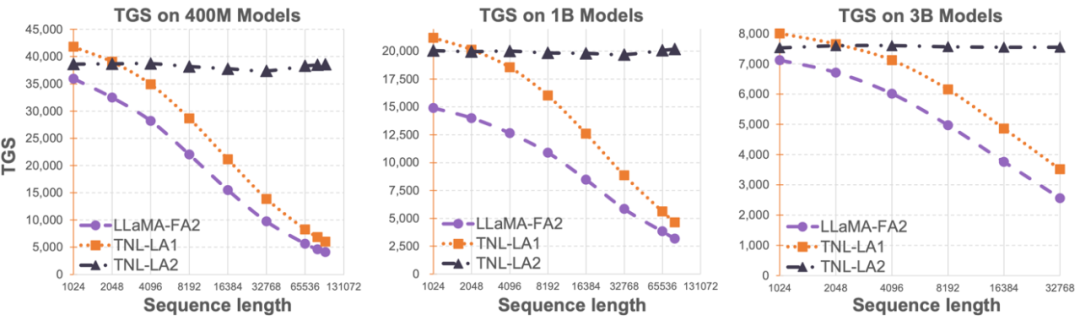
Lightning Attention-2 是一种新型的线性注意力机制,让长序列的训练和推理成本与 1K 序列长度的一致。
来自清华大学的研究者提出了一种新的注意力范式——代理注意力 (Agent Attention)。