AI资讯新闻榜单内容搜索-评测基准

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 评测基准
NeurIPS 2026 ED Oral丨Benchmark也有保质期?我们给158个评测基准打了分

NeurIPS 2026 ED Oral丨Benchmark也有保质期?我们给158个评测基准打了分

NeurIPS 2026 ED Oral丨Benchmark也有保质期?我们给158个评测基准打了分

阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。

来自主题: AI技术研报
9476 点击    2026-11-01 09:19
最强模型准确率仅39%!当Deep Search真正进入复杂的真实互联网

最强模型准确率仅39%!当Deep Search真正进入复杂的真实互联网

最强模型准确率仅39%!当Deep Search真正进入复杂的真实互联网

多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。

来自主题: AI技术研报
7173 点击    2026-10-31 12:07
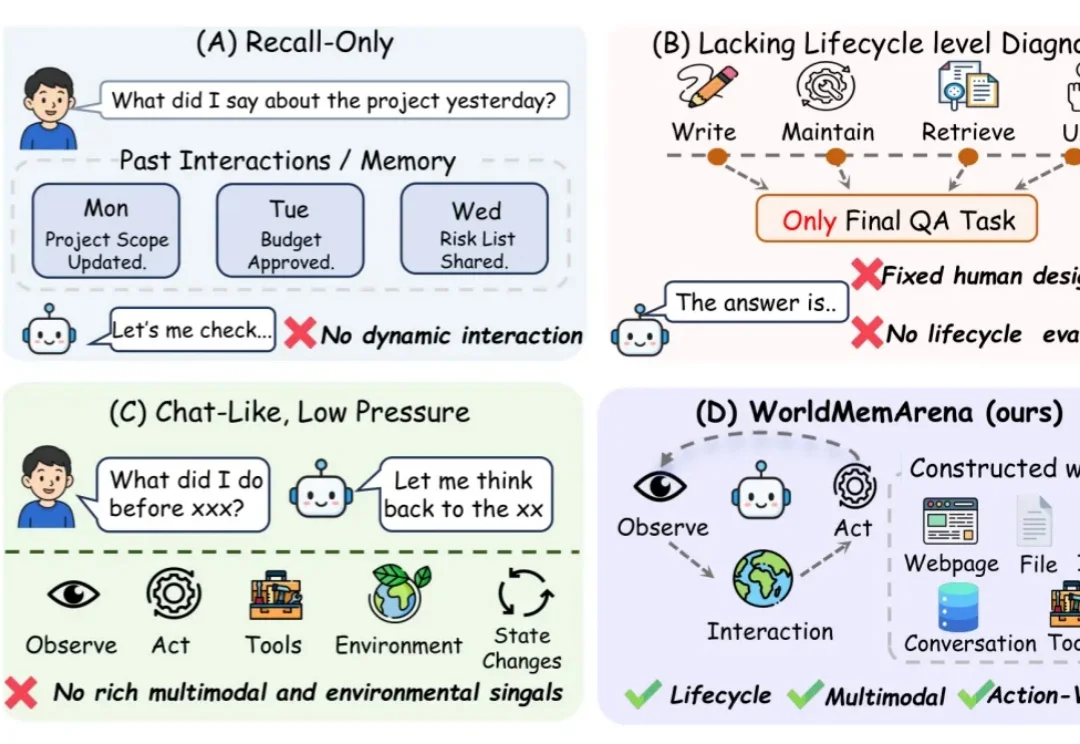
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互

从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互

从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互

团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?

来自主题: AI技术研报
8288 点击    2026-10-21 10:12
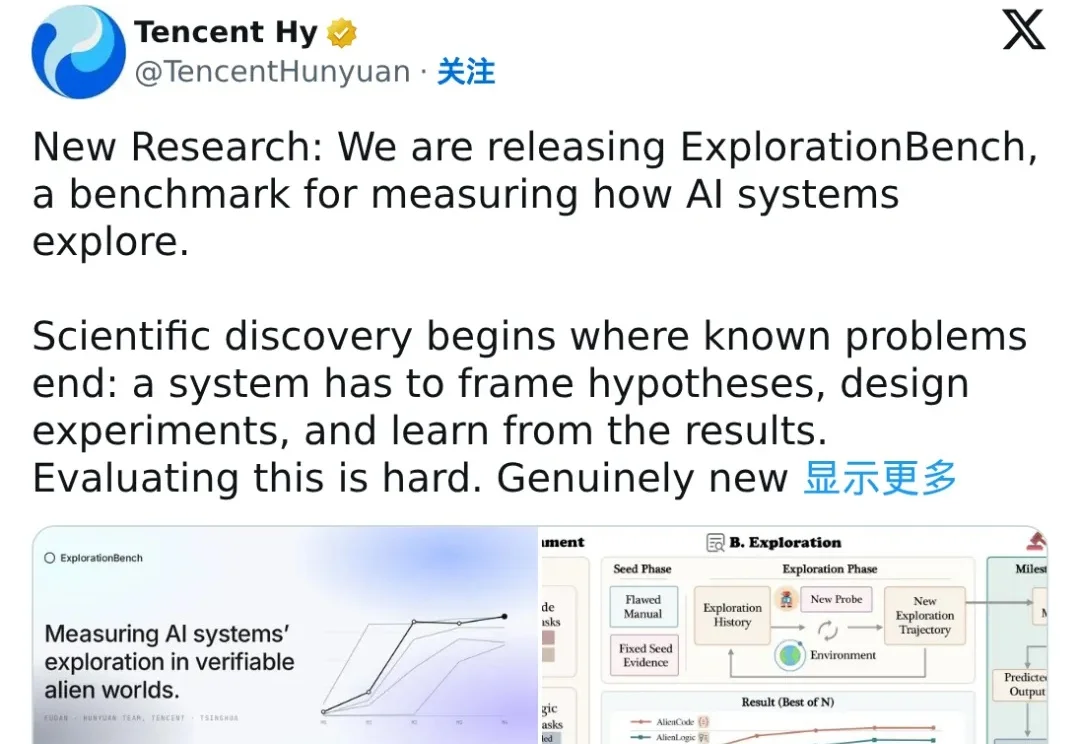
该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench

该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench

该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench

近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。

来自主题: AI技术研报
7425 点击    2026-10-20 11:57
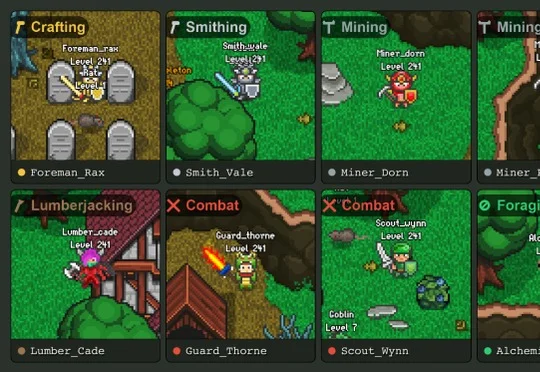
Agent组队干活,最强模型只完成50%任务!基准评测协作能力

Agent组队干活,最强模型只完成50%任务!基准评测协作能力

Agent组队干活,最强模型只完成50%任务!基准评测协作能力

OpenAgents、哥伦比亚大学等研究者构建多智能体协作评测基准AgentWorld,评测显示主任务最高完整成功率为Gemini 3 Flash的52.0%,并提出CCE指标分析协作贡献。

来自主题: AI技术研报
8105 点击    2026-10-10 12:29
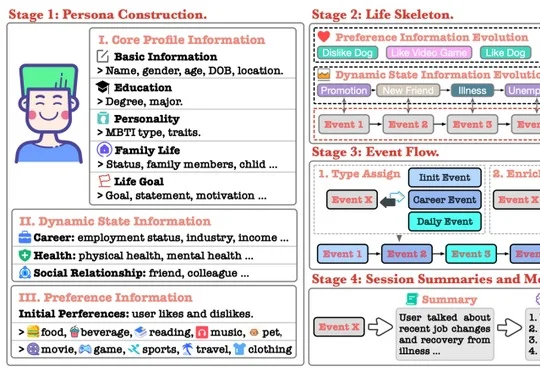
给AI装上记忆,它就真的记对了吗?HaluMem拆解智能体记忆幻觉

给AI装上记忆,它就真的记对了吗?HaluMem拆解智能体记忆幻觉

给AI装上记忆,它就真的记对了吗?HaluMem拆解智能体记忆幻觉

中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。

来自主题: AI技术研报
10749 点击    2026-09-30 15:39
答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」

答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」

答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」

香港科技大学提出LexAgentHallu法律智能体幻觉评测基准,沿执行轨迹定位错误步骤,发现即使最终答案正确,仍有68%的轨迹存在法律内容幻觉,表现最好的配置也有89%的轨迹出现幻觉。

来自主题: AI技术研报
8346 点击    2026-09-28 09:49
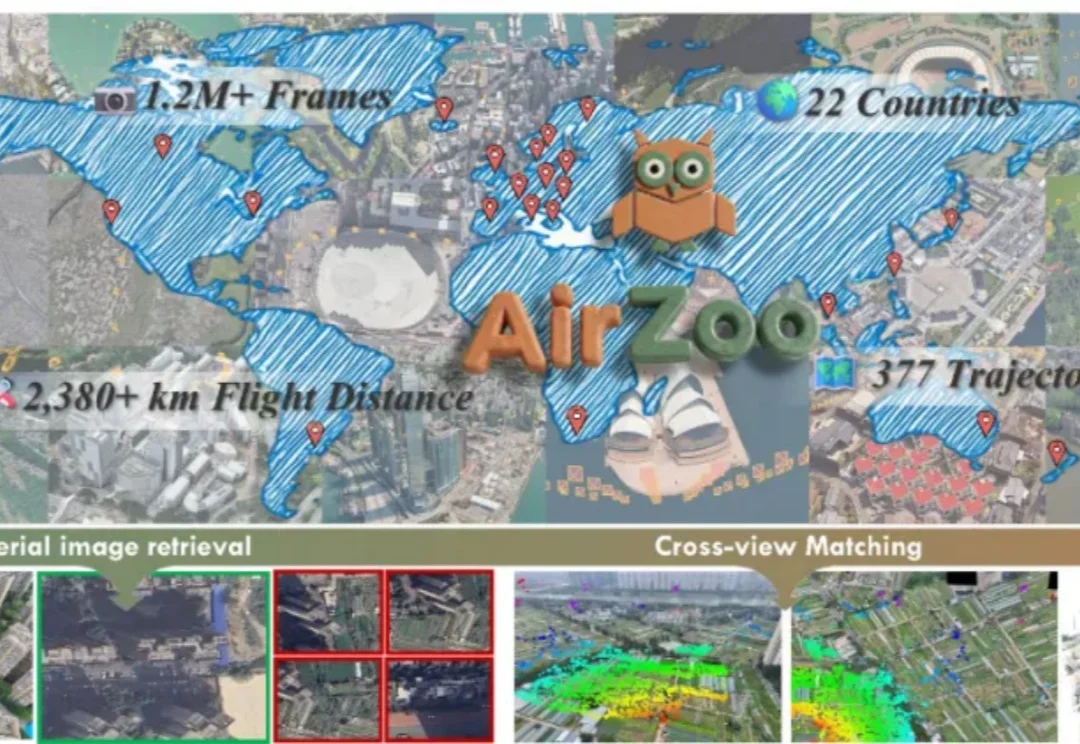
ECCV 2026|把全球3D地图变成无人机训练场,国防科大AirZoo构建航拍几何3D视觉统一基准

ECCV 2026|把全球3D地图变成无人机训练场,国防科大AirZoo构建航拍几何3D视觉统一基准

ECCV 2026|把全球3D地图变成无人机训练场,国防科大AirZoo构建航拍几何3D视觉统一基准

国防科技大学虚拟现实与视觉计算团队(SAW Lab)联合先进制导与控制技术国家级重点实验室等推出面向航拍几何 3D 视觉的统一大规模数据集与评测基准 「AirZoo」。

来自主题: AI技术研报
7048 点击    2026-07-23 15:36
世界模型评测的最大盲区,被新基准MemoBench捅破了

世界模型评测的最大盲区,被新基准MemoBench捅破了

世界模型评测的最大盲区,被新基准MemoBench捅破了

来自哈佛大学、MIT、IBM、波士顿大学、谷歌、JHU、CMU 和 Kempner Institute 的研究者提出了一个新的诊断性基准:MemoBench。这是首个面向动态环境的「消失-重现」世界建模评测基准,并已被计算机视觉顶会 ECCV 2026 接收。其一作 Haoyu Chen 为哈佛大学计算科学与工程专业一年级硕士生,师从哈佛大学计算机科学助理教授 Yilun Du。

来自主题: AI技术研报
8665 点击    2026-07-06 12:24
Claude「断电」背后:中国基准首次捅开了AI万亿市场「死穴」

Claude「断电」背后:中国基准首次捅开了AI万亿市场「死穴」

Claude「断电」背后:中国基准首次捅开了AI万亿市场「死穴」

6月22日Claude全家桶集体宕机,只是冰山一角。当最强大模型被丢进真实机房直面「幽灵故障」,AISHPerf-智算运维智能体评测基准给出残酷答案:全军覆没,无一过50分。这道鸿沟,第一次被量化。

来自主题: AI资讯
7324 点击    2026-06-30 10:21