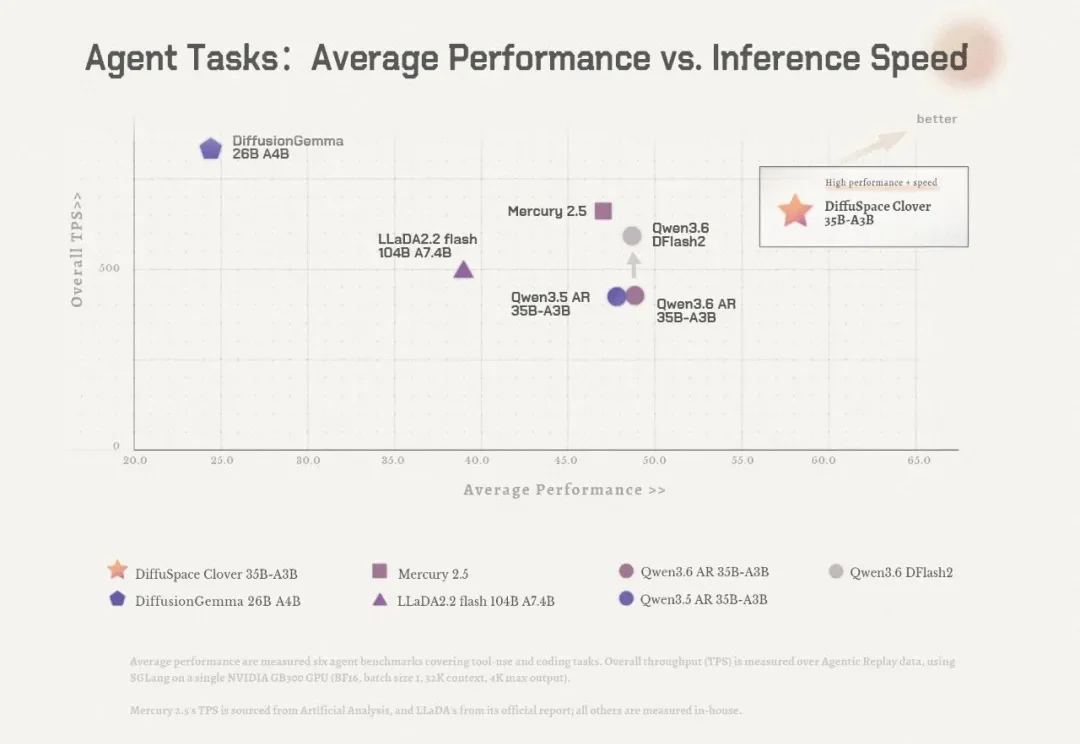
今天,扩散智能(DiffuSpace)发布源扩散语言模型 Clover-35B-A3B-Preview
今天,扩散智能(DiffuSpace)发布源扩散语言模型 Clover-35B-A3B-Preview编辑|张倩 2008 年,英伟达曾用一场颇为疯狂的实验,向人们展示并行计算的威力。 在现场,一台绘画机器人按部就班、一个像素接一个像素地绘制出一幅「笑脸」简笔画。 但接下来,画风突变。工作人员启动了一
来自主题: AI技术研报
6021 点击 2026-11-03 11:56

 搜索
编辑|张倩 2008 年,英伟达曾用一场颇为疯狂的实验,向人们展示并行计算的威力。 在现场,一台绘画机器人按部就班、一个像素接一个像素地绘制出一幅「笑脸」简笔画。 但接下来,画风突变。工作人员启动了一
国内大语言模型炒作的重点已经聚焦于3D生成领域,凡更新必展示结合Three.js炮制的4A大作。
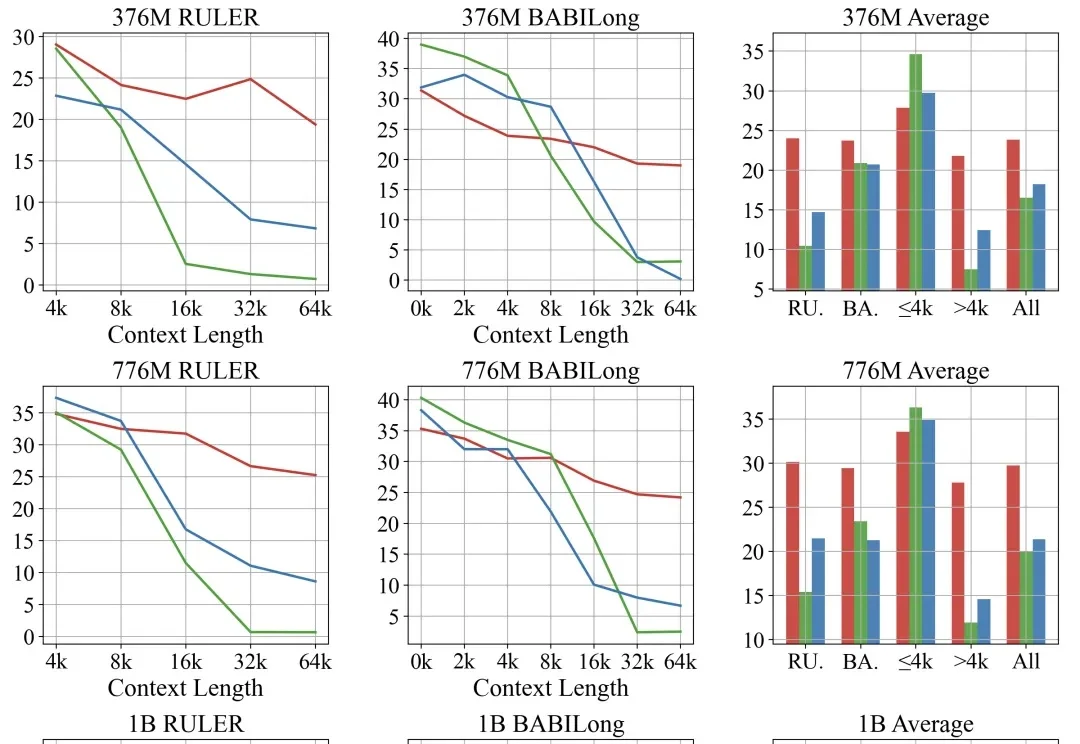
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
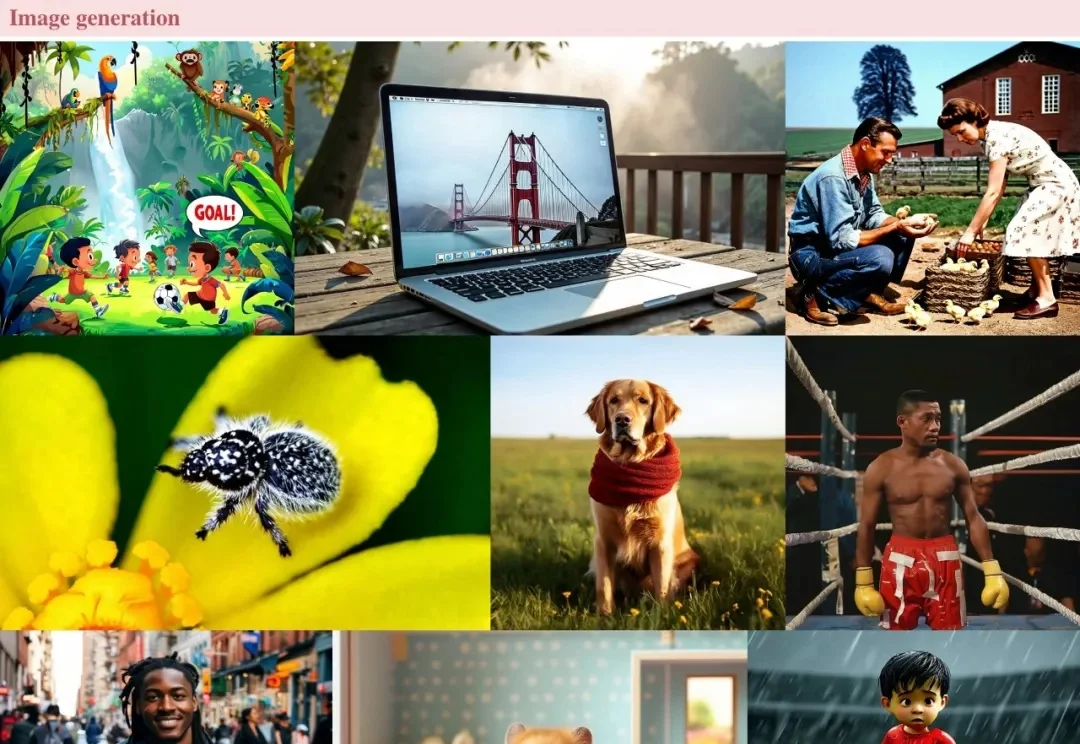
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
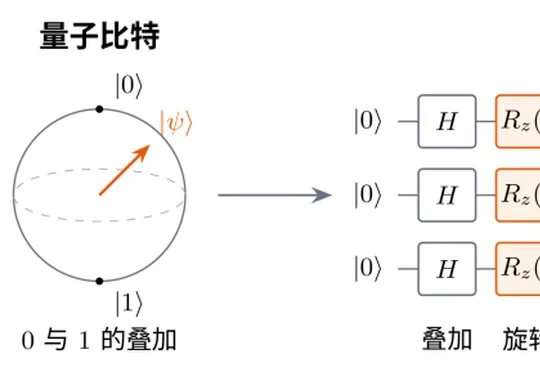
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
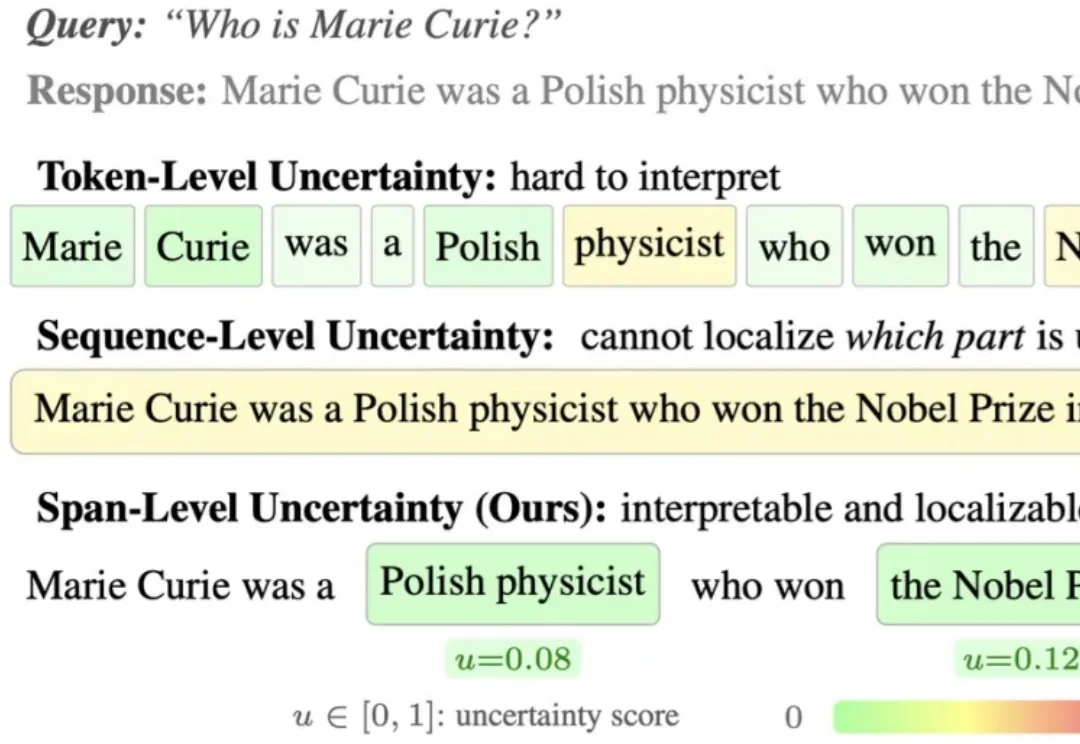
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
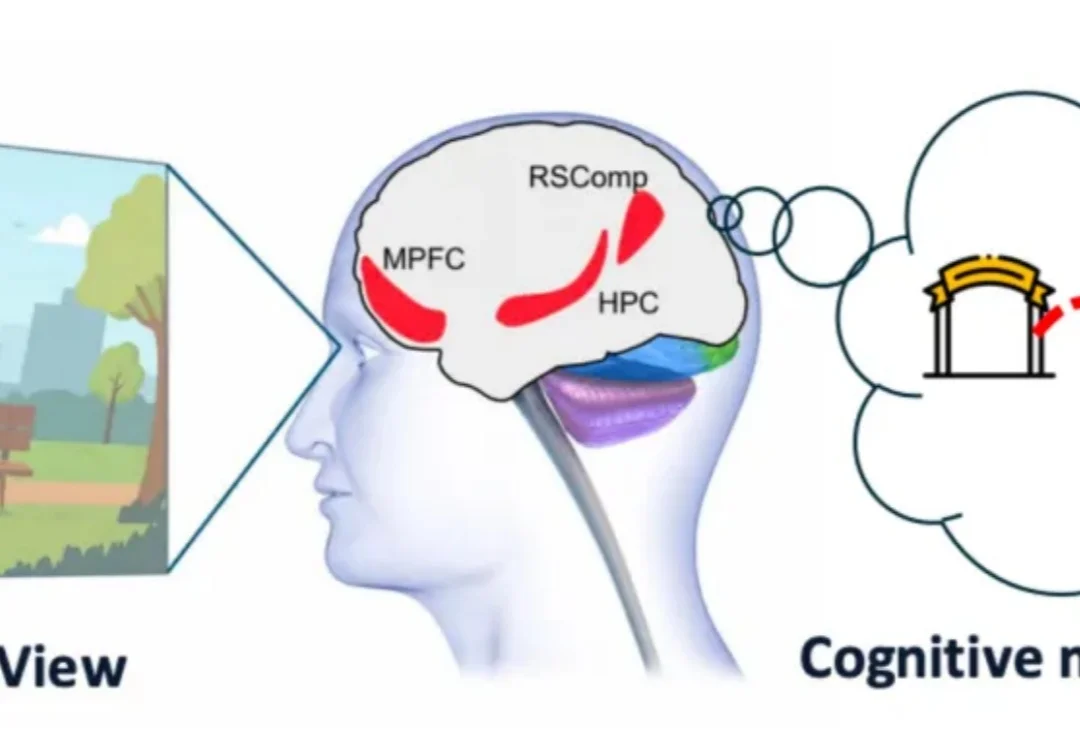
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
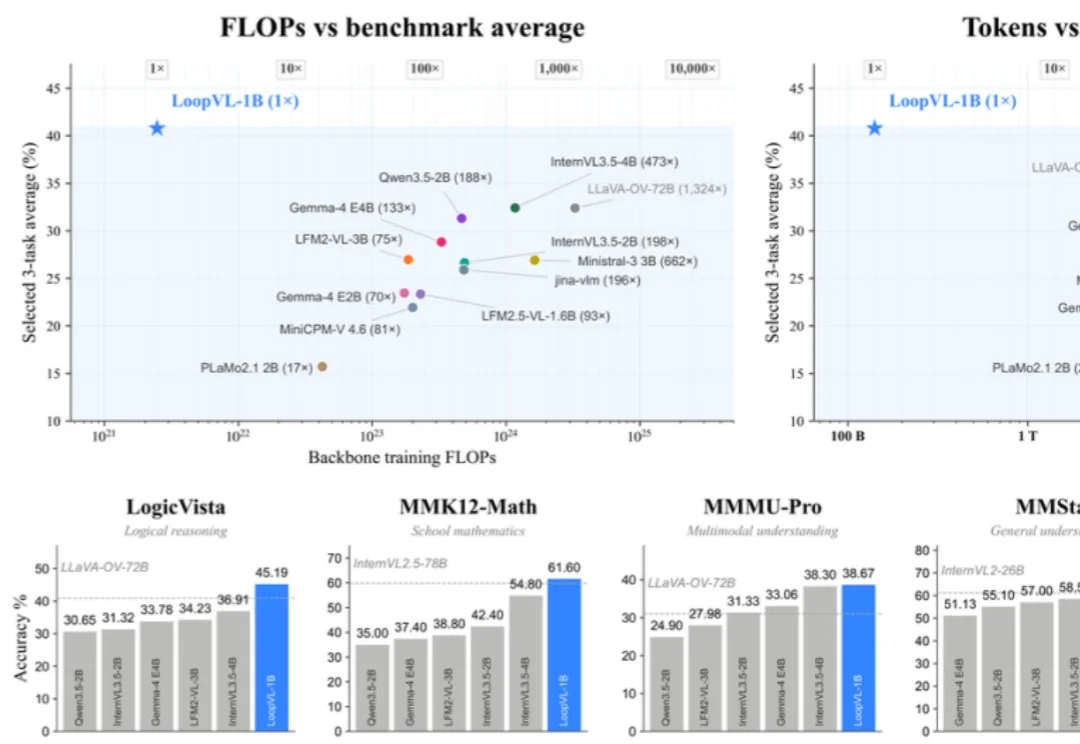
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
OpenAI前研究员Nick Cammarata与Goodfire团队发布研究称,一个320亿参数语言模型中约90%的神经元各有可解释的主要任务,表明追踪和干预神经元或能揭示AI内部规律,但该判断仍待更多检验。
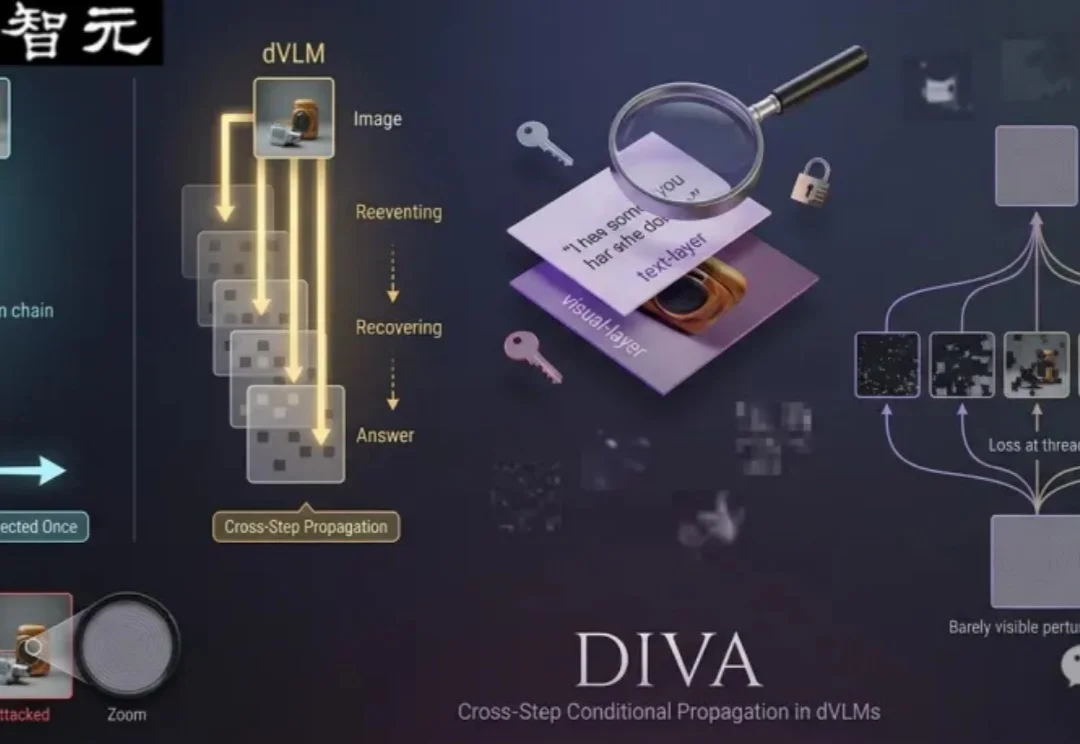
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。