AI资讯新闻榜单内容搜索-长上下文

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 长上下文
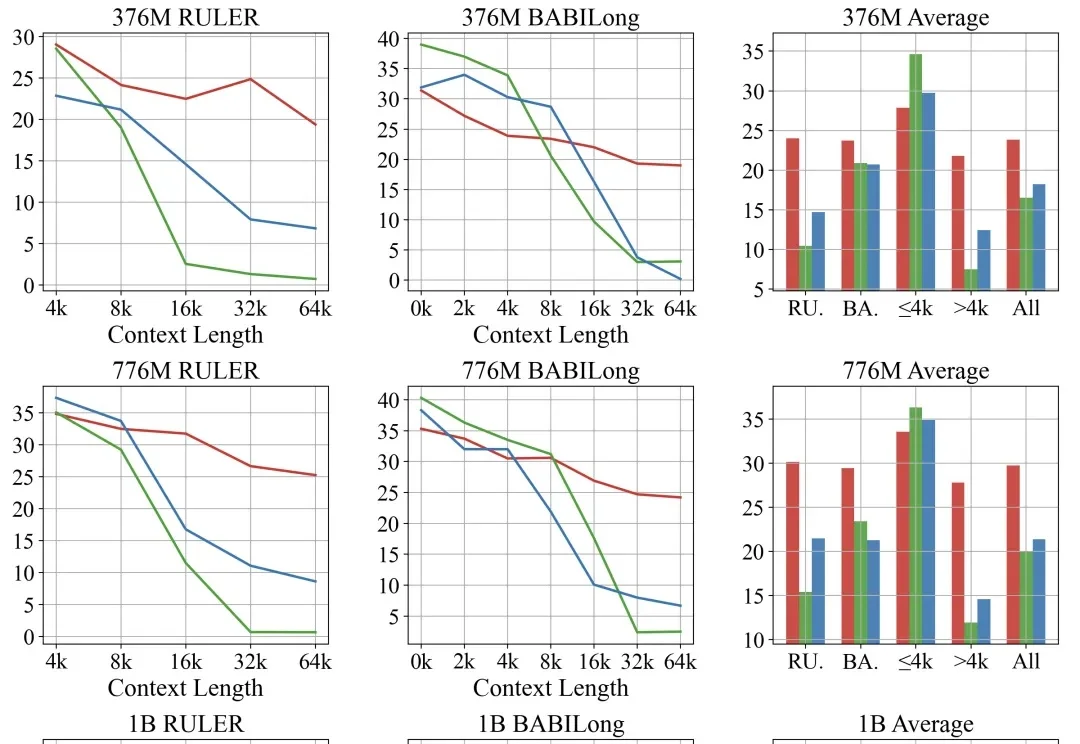
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要

混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要

混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要

长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。

来自主题: AI技术研报
9050 点击    2026-11-02 10:59
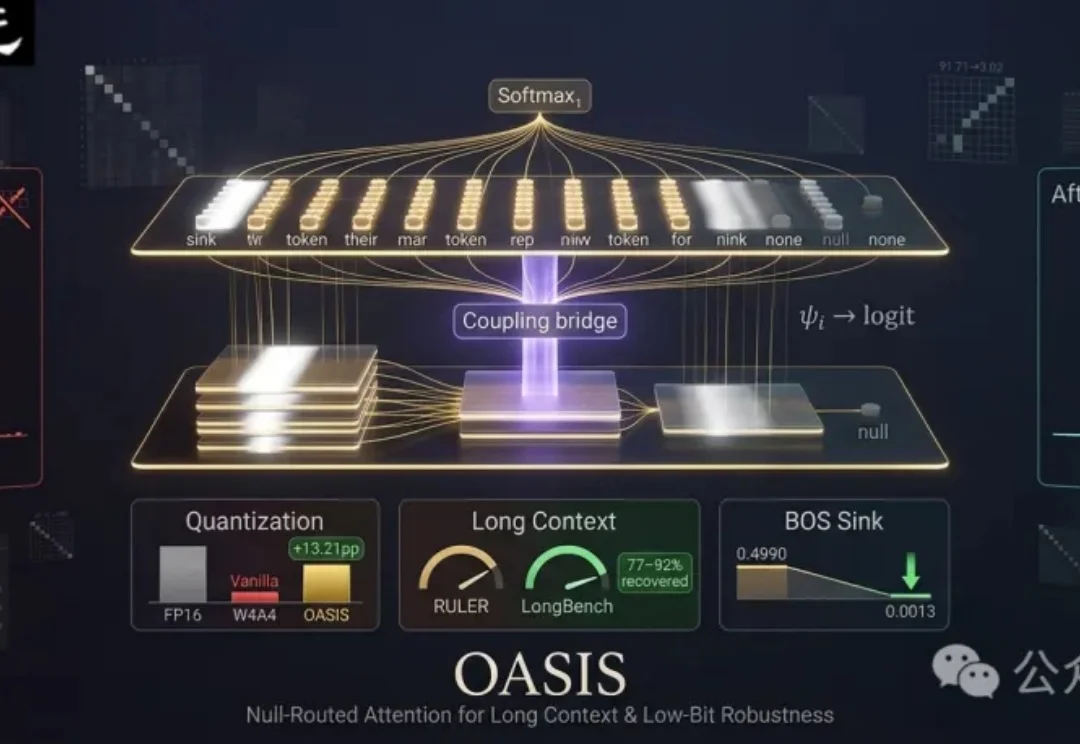
NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。

来自主题: AI技术研报
6133 点击    2026-10-23 09:51
提速不降智,小红书DoSA将首token延迟减半

提速不降智,小红书DoSA将首token延迟减半

提速不降智,小红书DoSA将首token延迟减半

稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。

来自主题: AI技术研报
8950 点击    2026-10-21 10:11
苹果LensVLM:长上下文压缩成图片,模型边看边「放大」

苹果LensVLM:长上下文压缩成图片,模型边看边「放大」

苹果LensVLM:长上下文压缩成图片,模型边看边「放大」

Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。

来自主题: AI技术研报
7210 点击    2026-10-15 11:26
AI 圈杀出新顶流,神秘「太空兔」能用涂鸦做网站

AI 圈杀出新顶流,神秘「太空兔」能用涂鸦做网站

AI 圈杀出新顶流,神秘「太空兔」能用涂鸦做网站

匿名AI模型Space Bunny Alpha(太空兔)近期凭借草图转网页、长上下文与Agent编程能力在OpenRouter和OpenCode平台刷屏并冲上日调用量第一,其分词特征与MiniMax M3.1系列高度吻合但尚无厂商官方认领。

来自主题: AI资讯
10411 点击    2026-09-30 11:12
全模态模型Qwen3.8-Omni-Flash发布

全模态模型Qwen3.8-Omni-Flash发布

全模态模型Qwen3.8-Omni-Flash发布

原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。

来自主题: AI资讯
10258 点击    2026-09-18 17:29
Kimi 新模型  K2.8 Preview 全量上线!综合性能逼近 K3!

Kimi 新模型 K2.8 Preview 全量上线!综合性能逼近 K3!

Kimi 新模型 K2.8 Preview 全量上线!综合性能逼近 K3!

Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。

来自主题: AI资讯
10498 点击    2026-09-11 21:23
张小珺:创造超长上下文之前,先抓住一瞬间的直觉

张小珺:创造超长上下文之前,先抓住一瞬间的直觉

张小珺:创造超长上下文之前,先抓住一瞬间的直觉

张小珺的播客(《张小珺商业访谈录》)是关注人工智能前沿的人绕不开的上下文——超长上下文。

来自主题: AI资讯
8969 点击    2026-08-25 14:37
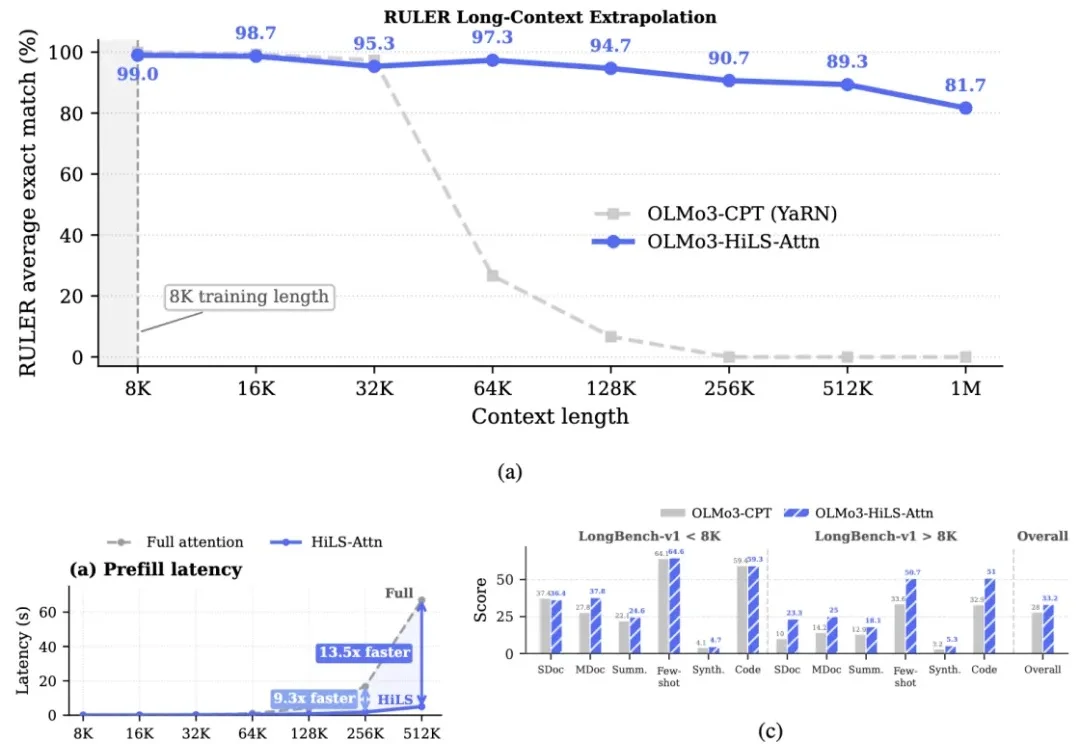
在数学上把稀疏注意力做对!腾讯Hy开源HiLS-Attention: 计算更少效果更好, 外推512倍

在数学上把稀疏注意力做对!腾讯Hy开源HiLS-Attention: 计算更少效果更好, 外推512倍

在数学上把稀疏注意力做对!腾讯Hy开源HiLS-Attention: 计算更少效果更好, 外推512倍

让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。

来自主题: AI技术研报
9838 点击    2026-07-20 15:19
速递|爆MiniMax研发2.7万亿参数新模型,解禁前获超八成基石股东承诺长期持有

速递|爆MiniMax研发2.7万亿参数新模型,解禁前获超八成基石股东承诺长期持有

速递|爆MiniMax研发2.7万亿参数新模型,解禁前获超八成基石股东承诺长期持有

据 The Information 报道,MiniMax 正在研发一款参数规模达 2.7 万亿的大语言模型,内部代号暂定为 M3 Pro,最快有望于今年第三季度发布,并计划同步开源。相较于现有旗舰模型 M3 的 4280 亿参数,M3 Pro 的规模实现了数量级跃升,预计将在复杂推理、多步骤任务处理及长上下文理解等能力上进一步增强。

来自主题: AI资讯
9851 点击    2026-07-08 22:25